خفض التكاليف بأكثر من 90% باستبدال واجهات Google البرمجية بخدمة مصغّرة قائمة على LLM
استبدال واجهات Google البرمجية المكلفة بخدمة مصغّرة قائمة على LLM خفّض التكاليف بنسبة 90% – تعرّف كيف جعل Gemini AI ذلك ممكناً.
استبدلنا استخدامنا لخدمتين منفصلتين من Google بخدمة مصغّرة صغيرة واحدة تعمل بنموذج لغوي كبير (LLM)، هو Gemini AI (وهو أيضاً من Google). والنتيجة؟ انخفضت التكاليف بأكثر من 90%، وازدادت المرونة، بعد يومين من العمل فقط.
مقدمة
أثناء مراجعة روتينية لحساب فوترة GCP لأحد عملائنا، دقّقت في بضع واجهات برمجية جاهزة من Google نعتمد عليها في ترجمة اللغات (Cloud Translation API) وفي تحليل المشاعر (Cloud Natural Language API). وكانت التغييرات الأخيرة في أجزاء من منطق الأعمال، إضافة إلى ميزات كنا ننوي بناءها خلال الصيف، تعني أن كلفة هذه الخدمات يُتوقع أن ترتفع بحدة، وكان عليّ تقدير مقدار الارتفاع لنكون أكثر استعداداً للنقاشات حول المنتج مع ما يسمى “الأعمال”.
في البداية كان سير العمل لدينا مع واجهتي Google بسيطاً: ترجمة نص المستخدم إلى الإنجليزية، ثم إجراء فحوص المشاعر عليه. ولم تكن الترجمة موجودة إلا لأن واجهة تحليل المشاعر لا تدعم اللغة الأصلية للنص. وحين كان النص يبدو مشبوهاً (مسيئاً أو بذيئاً أو مصقولاً بصورة مريبة)، كنا نعلّمه لتراجعه فرقة من البشر.
وفي المستقبل كنا ننوي استخدام Translation API في أماكن أكثر بكثير، وكان حجم الاستدعاءات لهذه الخدمات سينمو أُسّياً. أردنا تحسين تجربة المستخدم بالترجمة إلى 12 لغة مع الإبقاء على تحليل المشاعر. وهذا يعني آلاف استدعاءات الواجهة يومياً للترجمات وحدها (نخزّن النتائج مؤقتاً ولا نحدّثها إلا عند تغير النص المصدر).
وعند تحليل أحجام الاستدعاءات الحالية والمتوقعة، أدركنا أن خدمة واحدة قائمة على LLM يمكنها أن تحل محل الواجهتين. وكان عليّ إعداد إثبات مفهوم (PoC) سريع لمعرفة كلفة الحصول على الوظائف نفسها عبر استدعاءات LLM بسيطة من خلال الواجهة البرمجية.
كانت متطلبات الأعمال للخدمة المصغّرة الجديدة (PoC) مباشرة:
- التعامل مع 12 لغة،
- التعامل مع تحليل المشاعر (ويفضل في استدعاء واحد بدلاً من اثنين)،
- مقارنة التكاليف بالإعداد الحالي.
الخلفية والإعداد السابق
قبل الترحيل كانت المعمارية بسيطة. كانت إحدى خدماتنا المصغّرة تتلقى رسالة تحتوي النص المراد فحصه، وتستدعي Google Translation API للحصول على النسخة الإنجليزية من النص، ثم تستدعي Cloud Natural Language API مرتين للحصول على نتائج تحليل المشاعر المختلفة التي تهمنا.
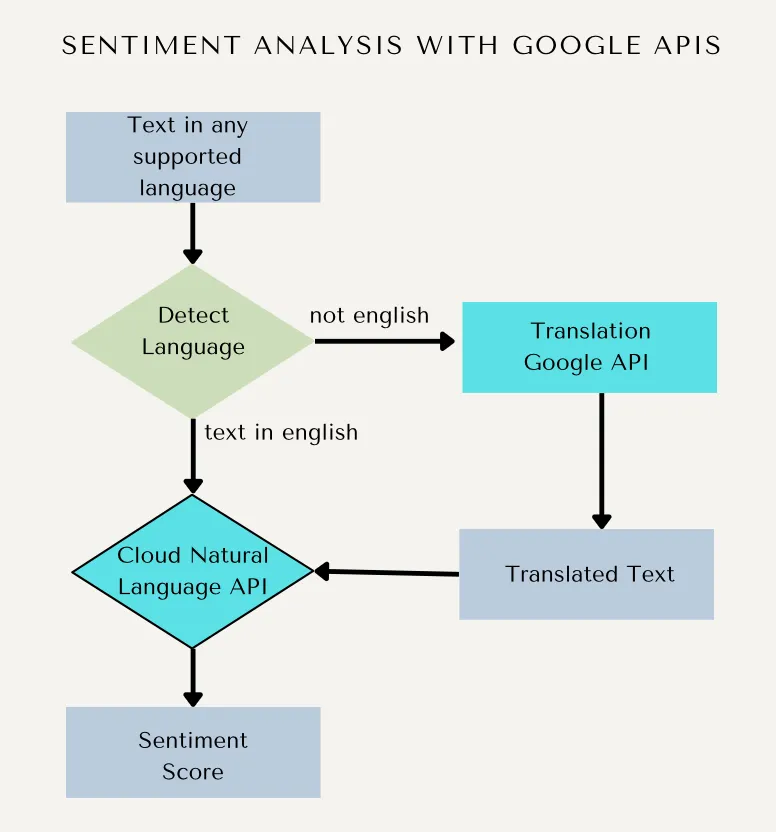
تطلبت الميزات الجديدة ترجمة النص إلى 11 لغة، واكتشاف اللغة المصدر حين تكون غير معروفة، مع الاستمرار في إجراء تحليل المشاعر.
ونتيجة لذلك كان لا بد من مضاعفة عدد الطلبات إلى الواجهة القائمة عدة مرات، ولم يكن ذلك كل شيء. فقد تضمنت الميزات المخطط لها للصيف تغييرات تعني ترجمة عدد أكبر بكثير (مئات المرات) من النصوص مسبقاً. وفي المجمل كان استخدام الواجهات سيزداد مئات الأضعاف في المستقبل القريب.
وقبل حساب ما سندفعه مقابل الخدمات بالإعداد الحالي، أو ما سيكلفه LLM، كان بوسعنا إجراء تجربة بسيطة: كنا نعرف تقريباً عدد مرات استدعائنا لخدمات Google، لأننا نعرف عدد النصوص التي تمر عبر نظام المراسلة Pub/Sub لدينا. فإذا أطلقنا المشروع الجديد بسرعة وعالجت تلك الخدمة المصغّرة تقريباً العدد نفسه من الرسائل، فستكون المقارنة بالنهج القديم سهلة. وهذا ما فعلناه بالضبط. ففي يوم واحد بنينا خدمة مصغّرة بسيطة جداً من ملف واحد بلغة Python، كُتبت بالكامل بأسلوب vibe coding مع cursor، ونشرناها على عنقود Kubernetes لدينا، وأعدنا توجيه استدعاءات الواجهة من Google إلى خدمتنا المصغّرة. ستجد النتائج (دون أرقام دقيقة) في قسم مقارنة التكاليف أدناه.
لماذا نظرنا في حل قائم على LLM
بالنسبة إلى LLM، تبدو ترجمة نص أو التحقق من احتوائه على ألفاظ نابية بلغة معينة مهمة سهلة. حتى أولى نسخ ChatGPT أبهرتني بطريقة تعاملها مع الترجمة. فكلتا المهمتين مثالية لـ LLM. وكان المجهول الوحيد هو الكلفة. ومع إصدار نماذج جديدة كل شهر تقريباً، هناك الكثير للاختيار منه. وتبين أن أحد أرخص النماذج المتاحة في Gemini أدى المهمة لنا على أكمل وجه.
تقدير التكاليف صعب غالباً حتى مع أبسط الخدمات السحابية (أياً كان المزوّد)، ولا تشذ LLMs عن ذلك. فالسعر يعتمد أساساً على أحجام الرموز (tokens) وعلى مدى تعقيد النموذج. يمكنك إجراء تقدير تقريبي بالطبع، لكن في رأيي، إذا كان بوسعك بناء مشروع صغير وتشغيله في الإنتاج أسبوعاً أو أسبوعين لرؤية التكاليف الحقيقية، فهذا هو الطريق (وإن لم يكن ذلك ممكناً أو عملياً دائماً بطبيعة الحال).
وهكذا عرفنا أن الكلفة ستكون العامل الحاسم قبل أن نستقر على الحل النهائي، لكن كانت هناك أسباب مهمة أخرى لاختيار LLM.
يمنحك LLM ميزة هائلة: يمكنك طلب أي استجابة تريدها والحصول عليها. وهذا يتيح لك جعل واجهتك البرمجية مرنة كما تشاء – يمكنك طلب عدة أشياء دفعة واحدة أو، إن كنت تفضل أقصى قدر من البساطة، استخدام استدعاء واحد لتقليل الرموز المستخدمة. كما أنك لا تحتاج إلى ترجمة أي شيء مسبقاً لتحليل المشاعر؛ يكفي تغيير الـ prompt ليكتشف LLM اللغة ويترجم نصاً ويجد الألفاظ النابية وغير ذلك.
وفي النهاية تبين أن الحل القائم على LLM أرخص بكثير. فالنصوص التي نترجمها قصيرة عادةً (فقرة أو فقرتان، أو أحياناً كلمة واحدة فقط)، لذا يبقى استهلاك الرموز منخفضاً أيضاً. وجربنا كذلك عدة نماذج من المتاحة واكتشفنا أن أحد أرخصها يؤدي أداءً ممتازاً في مهامنا.
وإضافة إلى ذلك، تتيح لنا prompts LLM جيدة البنية معالجة بعض المهام في طلب واحد بدلاً من عدة طلبات، كما كان ضرورياً مع واجهات Google المنفصلة، ما خفّض زمن الاستجابة الإجمالي في نظام الإنتاج.
ومن الجدير التأكيد أنه بينما اخترنا Gemini AI، فإن أي نموذج LLM شائع اليوم سيؤدي المهمة على الأرجح. بل بحثت في تنفيذ وظائفنا باستخدام Ollama مستضافاً داخلياً على أحد خوادمنا، لكن إبقاء خادم قوي بما يكفي لتشغيل حتى أصغر النماذج المتاحة على مدار الساعة سيكلف أكثر من استدعاء واجهة Gemini، فتخلينا عن الفكرة (على الأقل في الوقت الحالي).
باختصار (TL;DR)
لماذا نختار LLM؟
- تحسين التكلفة: تبين أن النصوص القصيرة التي نترجمها عادةً تستهلك عدداً قليلاً جداً من الرموز.
- المرونة: يمكن لـ prompt واحد معالجة الاكتشاف والترجمة وفحوص المشاعر في استدعاء واحد.
- تكرار أسرع: نحن من يحدد مخططات المخرجات (JSON/enums/درجات) بدلاً من أن تفرضها علينا واجهة طرف ثالث.
- اختيار مزوّد LLM: اخترنا Gemini، لكن نماذج LLM السائدة الأخرى كانت ستؤدي الغرض بالقدر نفسه.
كيف صممنا الخدمة المصغّرة الجديدة
كما قلت، بنيت هذه الخدمة المصغّرة مرتين. كانت النسخة الأولى PoC سريعة وبدائية، كتبها الذكاء الاصطناعي بالكامل بلغة Python. التخاطب مع واجهة Gemini بسيط إلى حد كبير – كل ما تحتاجه مفتاح API. وفي المرة الثانية أعدنا كتابة الخدمة المصغّرة بلغة Scala لتتبع أسلوب الخدمات المصغّرة الأخرى في قاعدة شيفرتنا، وشغّلناها على عنقودنا. بدا البدء بـ Python معقولاً للحصول سريعاً على حل مكتوب بأسلوب vibe، لكن بعد فوات الأوان نرى أن الخدمة بسيطة إلى حد كان يمكننا معه تجاوز تلك الخطوة تماماً وكتابتها مباشرة بـ Scala وتوفير بضع ساعات عمل – حسناً، نعيش ونتعلم.
هناك نقطة نهاية واحدة لاكتشاف اللغة، واثنتان للترجمات (من لغة إلى أخرى، ومن لغة واحدة إلى كل اللغات الأخرى دفعة واحدة)، ونقطة نهاية تتحقق من الإفراط في صيغ التفضيل (superlatives)، وأخرى مخصصة للألفاظ النابية. أما /healthcheck و/api/languages فهما نقطتا نهاية مساعدتان – الأولى تخدم آلية فحص الصحة في Kubernetes، والثانية تسرد ببساطة اللغات التي ندعمها.
والمثير في الحل الجديد أننا استطعنا تشكيل مخرجات هذه الواجهات تماماً كما نشاء. لم يكن هناك داعٍ للتنقيب في التوثيق لفهم سبب إرجاع Google درجة واحدة لنص معين ودرجة مختلفة لمثال آخر. مع LLM يمكننا ببساطة أن نخبر الوكيل بما يُرجع – مثلاً قيمة بين 0 و1، أو ربما تعداداً (enumeration) مثل “good”/”bad” – والسماء هي الحد.
للتوضيح، سأريك مدى سهولة معالجة طلب ترجمة نص. تقبل الواجهة /api/translate طلب json التالي:
{
  "text": String,
  "source_lang": Option[String],
  "target_lang": String
}
الحقل source_lang اختياري. وعندما تتلقى خدمتنا المصغّرة طلباً كهذا، نعدّل ببساطة الـ prompt الذي نرسله إلى Gemini AI:
val prompt: String = req.source_lang match {
         case Some(src) =>
           s"""Translate the following text from ${LanguageUtils.nameFor(src)} (${src.code}) to ${LanguageUtils
               .nameFor(req.target_lang)} (${req.target_lang.code}).

Text: "${req.text}"

Provide only the translated text without any additional explanations or formatting."""
         case None      =>
           s"""Detect the language of the following text and translate it to ${LanguageUtils.nameFor(
               req.target_lang
             )} (${req.target_lang.code}).

Text: "${req.text}"

First, detect the language and provide the language code, then provide the translation. Format your response as:
Detected language: [language_code]
Translation: [translated_text]"""
       }
نخبره صراحةً إما بترجمة النص وإرجاع الترجمة فقط عندما يكون source_lang محدداً، أو باكتشاف اللغة بنفسه وإرجاع اللغة المكتشفة مع النص المترجم.
يبين هذا المثال البسيط بوضوح ما تستطيع LLMs فعله ومدى مرونتها مقارنة بالاعتماد على عدة خدمات مختلفة من أطراف ثالثة معروضة عبر واجهات REST.
وهذا مثال آخر، هذه المرة لاكتشاف صيغ التفضيل:
val prompt = s"""Analyze the following English text for excessive use of superlatives (words like "best", "worst", "most", "least", "greatest", "amazing", "incredible", "fantastic", "terrible", "horrible", etc.).

Text: "${req.text}"

You must respond with ONLY valid JSON in this exact format:
{
   "score": <number from 1-10 where 1=no superlatives, 10=excessive superlatives>,
   "analysis": "<brief explanation of the score>",
   "detected_superlatives": ["<list of detected superlative words/phrases>"]
}

Do not include any text before or after the JSON. Only the JSON object."""
يفترض هذا الـ prompt أن النص بالإنجليزية (ما سهّل استبداله بالنسخة السابقة من هذه الوظيفة، فاستطعنا استبدالها مباشرة في الإنتاج بتغييرات قليلة)، لكنه يُظهر الفكرة العامة. نخبر Gemini بألا يُرجع سوى JSON، ونعطيه بنية نموذجية، ونشرح له كيفية حساب الدرجة. بسيط!
وفي النهاية نُفّذ الحل في متحكم (controller) واحد يعرض نقاط النهاية الموصوفة أعلاه، إضافة إلى نقطة أخرى لفحوص صحة pods في Kubernetes. وكل ذلك صغير وسلس وسريع بفضل http4s ومكتبات مفتوحة المصدر أخرى، تتولى أيضاً استدعاءات Gemini AI.
وعندما يُترجم نص إلى اللغات الإحدى عشرة الأخرى، نحفظ النتائج في قاعدة بيانات علائقية باستخدام doobie، فلا يحتاج النص نفسه إلى الترجمة مراراً وتكراراً (مع آلية بسيطة تكتشف التغييرات في النص الأصلي بالطبع).
نهج النشر والتوسع
من سلبيات التحول إلى خدمة LLM قائمة على Gemini أن علينا الآن تشغيلها بأنفسنا. وهذه ليست مشكلة بالنسبة لنا، إذ تعمل جميع خدماتنا المصغّرة أصلاً بسلاسة على عنقود Kubernetes، وخدمة أخرى لا تضر. وكان pod واحد بموارد دنيا يكفي فعلاً، لكن للسماح بالتحديثات المتدرجة (rolling updates) نحتاج إلى pods اثنين على الأقل من النسخة نفسها تعملان وتعالجان الطلبات.
والعمل الإضافي الوحيد المطلوب لإطلاقها كان نقطة نهاية لفحص الصحة يستطيع عنقود Kubernetes نفسه استخدامها.
ولأننا نستضيف الخدمة بأنفسنا، نحصل على قابلية رصد كاملة أصلية في GCP: يمكننا بسهولة رؤية ما تفعله الخدمة بالضبط وكمية الموارد التي تستخدمها، والاطلاع على السجلات، وإعداد تنبيهات في حال حدوث خلل، والاستجابة بسرعة، تماماً كما نفعل مع كل خدمة مصغّرة أخرى نشرناها.
مقارنة التكاليف: قبل وبعد
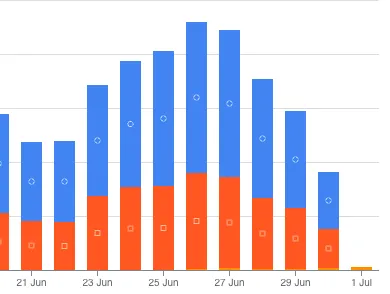
بسبب سرية العميل، لا يمكننا مشاركة سوى النسب المئوية لا الأرقام المطلقة. وكما ربما خمنت من الصورة الأولى، انخفضت كلفة إرسال الطلبات إلى خدمات Google بما لا يقل عن 90%. وهذا بطبيعة الحال تقدير تقريبي. فمن جهة، يُغفل الكلفة الإضافية لتشغيل الـ pods على عنقودنا (وهي صغيرة)؛ ومن جهة أخرى، ستكون الفجوة أكبر بكثير لو قارنّا الاستخدام الحالي، بعد أن أصبحت الميزات الجديدة المتعلقة بالترجمة إلى 12 لغة قيد التشغيل ونرسل مئات أضعاف الطلبات يومياً.
يمثل اللونان الأحمر والأزرق خدمتَي الترجمة وتحليل المشاعر من Google، بينما البرتقالي هو ما يكلفه Gemini AI لأداء العمل نفسه. وكما يوضح الرسم البياني، ففي الأول من يوليو أوقفنا كل استدعاء للواجهتين السابقتين.
وبالطبع كان هذا مجرد PoC سريع، وسيلة لنُظهر (لأنفسنا في الأغلب) أن حل LLM يعمل على الأقل بقدر الواجهات الجاهزة التي تقدمها Google.
باختصار (TL;DR)
بعد نقل الحركة من الواجهتين المُدارتين إلى الخدمة المصغّرة القائمة على LLM، انخفضت الفاتورة الشهرية لعبء العمل هذا بأكثر من 90%.
النتائج الأولى وأثرها
بمجرد جاهزية النسخة الأولى بلغة Python من PoC لدينا، وجدنا أن الترجمات دقيقة جداً (على الأقل في اللغات التي نتحدثها). أما بقية اللغات فاحتاجت إلى بعض التدقيق من وكالات ترجمة تابعة لأطراف ثالثة، لكن بوجه عام نجح جزء الترجمة جيداً.
وكان تحليل المشاعر نجاحاً أكبر، تجاوز ما كنا نأمله. والسبب الرئيسي أننا مع واجهة Google كنا مضطرين إلى تحليل الدرجات المُرجعة لبياناتنا بعمق وتحديد العتبة الدقيقة التي تكون “جيدة بما يكفي” لنا. أما مع حل LLM فاستطعنا بسهولة كتابة اختبارات كثيرة بأمثلة من الواقع وتعديل الـ prompt حتى يتصرف كما نريد. والأهم أننا استطعنا ابتكار مخرجات تقييم خاصة بنا، وكانت أسهل بكثير في الاستخدام ضمن منطق أعمالنا.
قد تستغرق الترجمة إلى لغات كثيرة وقتاً، لذا اخترنا جعلها غير متزامنة بالكامل باستخدام حل مراسلة كان لدينا بالفعل. ولذلك لا تمر طلبات الترجمة عبر نقطة نهاية REST؛ بل تُغلَّف في رسالة Pub/Sub، وحين يُعدّ Gemini AI الترجمات، تُنتَج رسالة جديدة وتُرسَل إلى الجهات المهتمة على عنقودنا.
وفي المجمل كانت المكاسب كبيرة مقارنة بحجم العمل الصغير. كما أظهرنا للأعمال أن دمج الذكاء الاصطناعي ليس صعباً، فيمكنهم البدء بالتفكير في حالات استخدام جديدة لاستخدام مزيد من الذكاء الاصطناعي على منصتهم.
وإذا بدأنا استخدام LLMs أكثر وشغّلناها داخلياً، فستكون هناك فائدة أخرى هي أن البيانات تبقى لدينا ولا تضطر إلى الذهاب إلى أي خدمات أطراف ثالثة ما لم نرد ذلك؛ وهذا ليس حرجاً في حالة الاستخدام هذه، لكنه قد يكون كذلك في حالات أخرى.
باختصار (TL;DR)
- جودة الترجمة: عالية في اللغات المدعومة (مع تدقيق عيّني من البشر عند الضرورة).
- المشاعر والسياسات: أسهل في التعديل، دون الاعتماد بعد الآن على تقييم ثابت من المورّد
- زمن الاستجابة: قفزات شبكية أقل بفضل دمج الخطوات في استدعاءات واحدة.
- الإنتاجية: الترجمة غير المتزامنة عبر Pub/Sub تبقي تجربة المستخدم سريعة الاستجابة.
ما تعلمناه
بمجرد أن طُرحت فكرة تكليف LLMs بترجماتنا، رأينا سريعاً أنها ثمرة دانية، وأيضاً وسيلة لنُري “الأعمال” ما تستطيع LLMs فعله لنا ومدى سرعة دمجها وسهولته.
ورغم أن التنفيذ كله استغرق أياماً قليلة، فقد استخلصنا كثيراً من “الدروس المستفادة” في الطريق.
أولاً، كتابة PoC بأسلوب vibe-coding رائعة، لكن احرص على ألا تعقّد الأمور. فالـ PoC موجود لإثبات أن شيئاً ما ممكن ويعمل. في البداية حاولنا دون داعٍ جعله أسرع ما يمكن باستخدام Python، بينما كان الحل كله بسيطاً بما يكفي لكتابته بـ Scala مباشرة دون الحاجة إلى إعادة كتابة. وكانت كتابة الـ PoC بأسلوب vibe-coding فكرة رائعة بالطبع، لكن في النهاية ما زال عليك مراقبة ما جرى توليده وتعديل الشيفرة وفق المعايير التي تريد أن تتبعها قاعدة شيفرتك.
لا تتصرف prompts الخاصة بـ LLMs دائماً كما هو متوقع من المحاولة الأولى. فهي تحتاج إلى ضبط، وقد يتطلب ذلك عدة تكرارات.
ومع LLMs، بدلاً من تتبع عدد طلبات واجهاتنا القديمة، علينا الآن تتبع استهلاك الرموز، وهو يأتي بجوانب جديدة يحتاج المطورون إلى تعلمها (السياق وحجم البيانات المطلوب معالجتها وما يجب إرجاعه).
باختصار (TL;DR)
ما نجح جيداً:
- معمارية أبسط ← صيانة أسهل.
- يمكن تحديث الـ prompts بمرونة دون لمس الشيفرة.
الصعوبات:
- استغرق ضبط الـ prompts عدة تكرارات.
- ارتفع استهلاك الرموز بصورة غير متوقعة عندما تضمنت المراجعات HTML أو تنسيقاً غريباً.
نصيحة:
- فرض مخطط JSON دائماً على مخرجات LLM.
- تتبع الكلفة لكل طلب بالرموز.
- إبقاء التزامن منخفضاً إلى أن تثق بالاستقرار.
خطط المستقبل
بعد أن كُتب الـ PoC واختُبر محلياً وأُطلق في الإنتاج خدمةً إضافية متاحة لتدفقات بيانات محددة مع خدمات مصغّرة أخرى، أصبح واضحاً أن تشغيل الخدمة القائمة على LLM سيكلف أقل بكثير. وقد فتح هذا أعين كثيرين في فريقنا، إذ يمكننا الآن التعامل مع الأفكار الجديدة مع “الأعمال” بطريقة مختلفة تماماً. وتحمّس كثيرون، ومن المؤكد أن أفكاراً جديدة ستتبع.
لم يكن خفض تكاليف الترجمة وتحليل المشاعر القائمة سوى جزء صغير من النجاح الكلي والأثر الذي تركه هذا الـ PoC الصغير على فريقنا وعلى الشركة التي نعمل لها.
الخاتمة
قد لا تبدو كتابة PoC بأسلوب vibe-coding في يومين عملاً كبيراً أو شيئاً يُفتخر به، لكن أثره الإجمالي تبين أنه أكبر مما توقعنا. فقد أنهينا تماماً تعاملنا مع واجهتين مكلفتين من Google واستخدامنا لهما. وحتى مع العدد المتواضع نسبياً من الطلبات التي كنا نرسلها إليهما، خفضنا التكاليف بنسبة 90% وانتهينا بجودة مساوية أو أفضل وحل أكثر مرونة بكثير.
وإذا كنت مطوراً أو CTO أو مديراً، فأحثك على التوقف لحظة والتفكير في كيف يمكن لـ LLMs أن تساعد في العمل الذي تقوم به أصلاً. فقد يتبين أنه يمكنك جعله أرخص عشر مرات، والارتقاء بحلك البرمجي إلى مستوى جديد تماماً، وتغيير عقلية فريقك قليلاً، لتلحق بركب الذكاء الاصطناعي وتستفيد منه إلى أقصى حد قبل منافسيك.
وإذا كان الأمر كذلك، وإذا بدا لك أي من هذا مألوفاً، فنحن هنا للمساعدة.