Avro vs Protobuf. տվյալների սերիալիզացիայի գործիքների համեմատություն
Այս հոդվածը համեմատում է Protobuf-ի և Avro-ի աշխատանքը մի քանի մետրիկներով՝ կոդավորման ժամանակ, վերծանման ժամանակ, սերիալիզացված չափ և թողունակություն։
Տվյալների սերիալիզացիան առանցքային դեր է խաղում ժամանակակից ծրագրային ապահովման մշակման մեջ՝ թույլ տալով հավելվածներին տվյալներ փոխանակել կոմպակտ, արդյունավետ և պլատֆորմից անկախ ձևաչափով։ Տվյալների սերիալիզացիայի երկու լայնորեն օգտագործվող համակարգեր են Google-ի Protocol Buffers-ը (Protobuf) և Apache-ի Avro-ն։ Նրանցից յուրաքանչյուրն ունի իր դրական և բացասական կողմերը, բայց արտադրողականությունը ամենակարևոր գործոններից մեկն է, որը ծրագրավորողները կշռադատում են Protobuf-ի և Avro-ի միջև ընտրելիս։ Այս գրառման մեջ մենք համեմատում ենք Protobuf-ի և Avro-ի աշխատանքը մի քանի մետրիկներով՝ կոդավորման ժամանակ, վերծանման ժամանակ, սերիալիզացված չափ և թողունակություն։
Այս թեստերի արդյունքները քննելով՝ ուզում եմ օգնել ծրագրավորողներին ավելի լավ հասկանալ, թե ինչպես է աշխատում յուրաքանչյուր համակարգ և ինչպես ընտրել այն, որը համապատասխանում է իրենց կոնկրետ պահանջներին։
Protobuf-ը և Avro-ն մի հայացքով
Protobuf-ը ստեղծել է Google-ը 2008 թվականին, և այն բաց կոդով ծրագրային ապահովում է։ Այն նպատակ ունի լինել պարզ, արագ և արդյունավետ, և աջակցում է բազմաթիվ ծրագրավորման լեզուների, այդ թվում՝ C++, Java, Python և Ruby։ Protobuf-ը տվյալների կառուցվածքը նկարագրում է սխեմայի սահմանման լեզվով, որը հետո կոմպիլացվում է կոդի, որը սերիալիզացնում և դեսերիալիզացնում է տվյալները։
Avro-ն ստեղծել է Apache-ը 2009 թվականին, և այն նույնպես բաց կոդով ծրագրային ապահովում է։ Avro-ն ստեղծվել է սխեմայի էվոլյուցիան նկատի ունենալով, այնպես որ տվյալները կարելի է սերիալիզացնել և դեսերիալիզացնել նույնիսկ սխեմայի փոփոխությունից հետո։ Avro-ն ընդգրկում է մոտավորապես նույն ծրագրավորման լեզուները, ինչ Protobuf-ը, Java-ի, Python-ի և Ruby-ի հատկապես լավ աջակցությամբ։ Այն նկարագրում է տվյալների կառուցվածքը JSON-ի վրա հիմնված սխեմայի սահմանման լեզվով, և սխեման կարող է պահվել տվյալների հետ միասին։
Protobuf-ը և Avro-ն համեմատելիս օգտակար է իմանալ, թե ինչպես է դրանցից յուրաքանչյուրը կիրառվում տարբեր ոլորտներում և հավելվածներում։ Ստորև բերված են երկու ձևաչափերի կիրառման օրինակներ։
Protobuf.
- Google-ը Protobuf-ը սկզբում ստեղծել է սեփական ներքին համակարգերի համար, ինչպիսիք են Google Search-ը, Google Maps-ը և Gmail-ը։
- gRPC՝ միկրոսերվիսների միջև հաղորդակցության համար։
- Ֆինանսական հաստատություններ՝ բարձր հաճախականությամբ առևտրի, ռիսկերի կառավարման և խարդախության հայտնաբերման համար։
- Խաղերի ծրագրավորողները օգտագործում են այն ցանցային արտադրողականությունը բարելավելու և թողունակության սպառումը կրճատելու համար։
- IoT հավելվածներ՝ սարքերի, ինչպիսիք են սենսորները, gateway-երը և ամպային սերվերները, միջև տվյալներ ուղարկելու համար։
- Ավտոմոբիլային հավելվածներ՝ մեքենաների և ենթակառուցվածքի, ինչպիսիք են լուսացույցները և կայանման հաշվիչները, միջև տվյալներ փոխանակելու համար։
Avro.
- Apache Hadoop-ը՝ բաց կոդով big data պլատֆորմը, օգտագործում է Avro-ն տվյալները սերիալիզացնելու և Hadoop-ի բաղադրիչների միջև փոխանակելու համար։
- Հաղորդագրությունների համակարգեր, ինչպիսիք են Apache Kafka-ն և Apache Pulsar-ը՝ հավելվածների և սերվիսների միջև տվյալների հոսքի համար։
- Վերլուծական պլատֆորմներ, ինչպիսիք են Apache Spark-ը և Apache Flink-ը՝ տվյալների մշակման և վերլուծության համար։
- Մեքենայական ուսուցման ֆրեյմվորքներ, ինչպիսիք են TensorFlow-ը և PyTorch-ը՝ տվյալները սերիալիզացնելու և մարզման ու inference-ի փուլերի միջև փոխանցելու համար։
- Լոգերի հավաքագրման գործիքներ, ինչպիսիք են Apache Flume-ը և Apache NiFi-ը՝ լոգերի տվյալները բազմաթիվ աղբյուրներից մեկ կենտրոնական վայր հոսքագրելու համար։
Ընդհանուր առմամբ՝ Protobuf-ը նախընտրելի է ցածր հապաղմամբ, բարձր արտադրողականության միջավայրերում, իսկ Avro-ն՝ big data-ի, բաշխված համակարգերի և վերլուծության ոլորտում։ Այդուհանդերձ, երկու ձևաչափերն էլ կարող են ծառայել բազմաթիվ տեսակի հավելվածների, և ճիշտ ընտրությունը կախված է տվյալ դեպքի կոնկրետ պահանջներից և սահմանափակումներից։
Նախապայմաններ
Protobuf-ի և Avro-ի արտադրողականությունը համեմատելու համար մենք օգտագործում ենք JMH-ը (Java Microbenchmark Harness)՝ Java կոդի benchmark-ի հայտնի գործիք։ JMH-ը տալիս է կոդի փոքր հատվածների աշխատանքը վերահսկվող միջավայրում չափելու հուսալի եղանակ, այնպես որ կարող ենք Protobuf-ը և Avro-ն ճշգրիտ համեմատել այնպիսի մետրիկներով, ինչպիսիք են կոդավորման ժամանակը, վերծանման ժամանակը, սերիալիզացված չափը և թողունակությունը։ Թեստային տվյալների համար ես ստեղծեցի օրինակ օբյեկտ, որը պետք է սերիալիզացվի և՛ Protobuf-ով, և՛ Avro-ով։ Դա գրադարանի պարզեցված մոդել է՝ address և books դաշտերով։ Յուրաքանչյուր գիրք ունի հեղինակ, էջեր և հասանելիություն, իսկ հեղինակն ունի անուն, ազգանուն և ազգություն։ Protobuf-ի և Avro-ի սխեմաների կարևոր տարբերությունը կայանում է կոլեկցիայի դաշտերը մշակելու եղանակում։ Protobuf-ը կոլեկցիայի դաշտերը հայտարարում է հատուկ շարահյուսությամբ՝ դաշտը նշելով որպես repeated, ինչպես ցույց է տալիս ստորև բերված հատվածը։
Այժմ ակտիվ օգտագործման մեջ են Protobuf-ի երկու տարբերակ՝ Proto2 և Proto3։ Ես ընտրեցի 3-րդ տարբերակը՝ 2-ի փոխարեն, քանի որ կարծում եմ, որ այն ավելի պարզ կառուցվածք ունի և ավելի հեշտ է օգտագործել։
syntax = "proto3";

package protobuf;

option java_multiple_files = true;
option java_package = "com.example.protobuf.proto.model";
option java_outer_classname = "LibraryProtos";

message Author {
 optional string name = 1;
 optional string surname = 2;
 optional string nationality = 3;
}

message Book {
 optional string title = 1;
 optional Author author = 2;
 optional int64 pages = 3;
 optional bool available = 4;
}

message Library {
 optional string address = 1;
 repeated Book books = 2;
}
Այս սահմանումից protocol buffer կոմպիլյատորը կարող է գեներացնել Java կոդ։
Avro-ն կոլեկցիաները սահմանում է որպես զանգված, այսինքն՝ տրված տիպի կոլեկցիա։ Նույն օբյեկտի համար Avro-ի սխեման ունի հետևյալ տեսքը.
{
 "type": "record",
 "name": "Library",
 "namespace": "com.example.avro.avro.model",
 "fields": [
   {
     "name": "address",
     "type": [
       "null",
       "string"
     ],
     "default": null
   },
   {
     "name": "books",
     "type": {
       "type": "array",
       "items": {
         "type": "record",
         "name": "Book",
         "fields": [
           {
             "name": "title",
             "type": [
               "null",
               "string"
             ],
             "default": null
           },
           {
             "name": "author",
             "type": {
               "type": "record",
               "name": "Author",
               "fields": [
                 {
                   "name": "name",
                   "type": [
                     "null",
                     "string"
                   ],
                   "default": null
                 },
                 {
                   "name": "surname",
                   "type": [
                     "null",
                     "string"
                   ],
                   "default": null
                 },
                 {
                   "name": "nationality",
                   "type": [
                     "null",
                     "string"
                   ],
                   "default": null
                 }
               ]
             }
           },
           {
             "name": "pages",
             "type": [
               "null",
               "long"
             ],
             "default": null
           },
           {
             "name": "available",
             "type": [
               "null",
               "boolean"
             ],
             "default": null
           }
         ]
       }
     }
   }
 ]
}
Avro Java API-ի միջոցով կարող ենք կառուցել վերը նշված սխեման և կոմպիլացնել այն Java-ի։
Benchmark-ների համար ես ընտրեցի Library օբյեկտի երկու տարբերակ՝ փոքր՝ մեկ գրքով, և մեծ՝ հազար գրքով։ JVM-ին ինչ-որ բան օպտիմալացնելով հեռացնելուց խանգարելու համար տողային դաշտերը ստանում են պատահական բովանդակություն և պատահական երկարություն (3-ից 13 նիշ)։ Արդյունավետությունը համեմատելիս սովորաբար պատահականությունից խուսափում են, բայց մեր դեպքում դրա ազդեցությունը աննշան է։ Ֆիքսված արժեքները օգտագործվել են միայն սերիալիզացված տվյալների չափը համեմատելու համար, քանի որ այնտեղ անհրաժեշտ են նույնական օբյեկտներ։
Նկատի ունեցեք, որ թեստերը կատարվել են միայն Java-ով։ Protobuf-ի և Avro-ի համեմատությունը այլ ծրագրավորման լեզուներում կարող է տարբեր արդյունքներ տալ, քանի որ սերիալիզացիայի գրադարանները, լեզվին հատուկ արտադրողականության հատկությունները և runtime միջավայրերը տարբեր են։ Լավ գաղափար է կատարել սեփական benchmark-ները և գնահատել արտադրողականությունը այն լեզվով, որն իրականում օգտագործում եք։
Թեստավորման ժամանակը
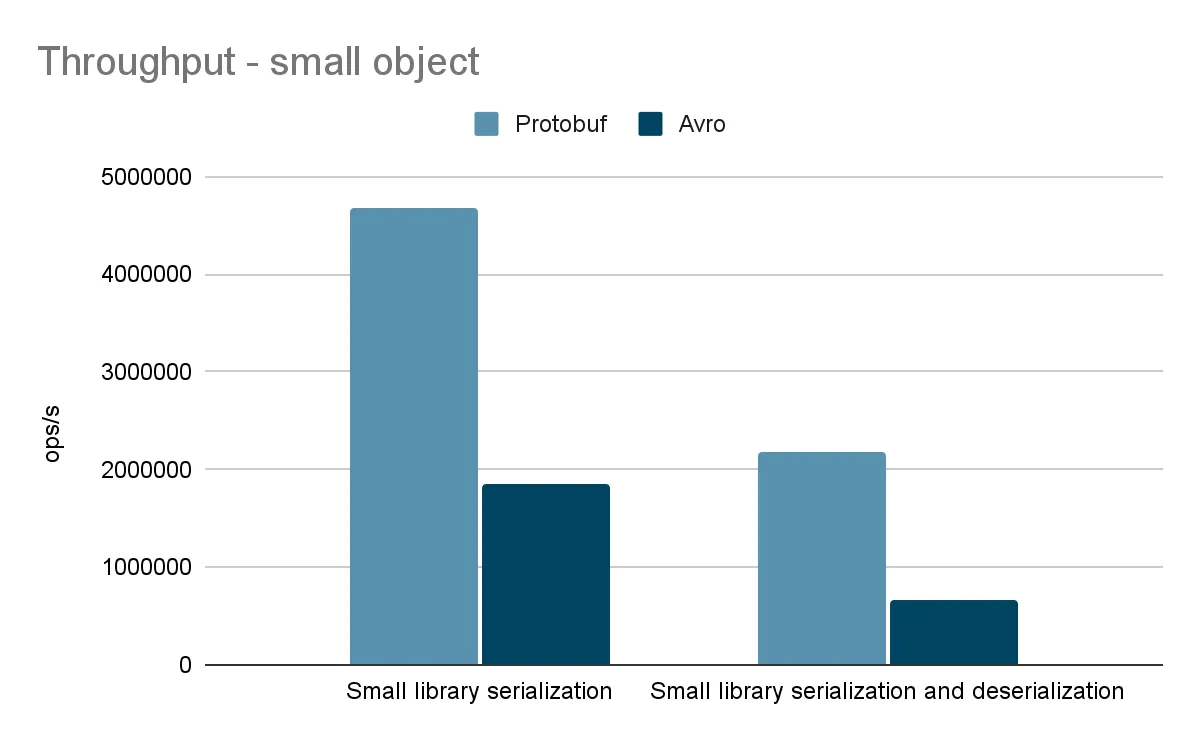
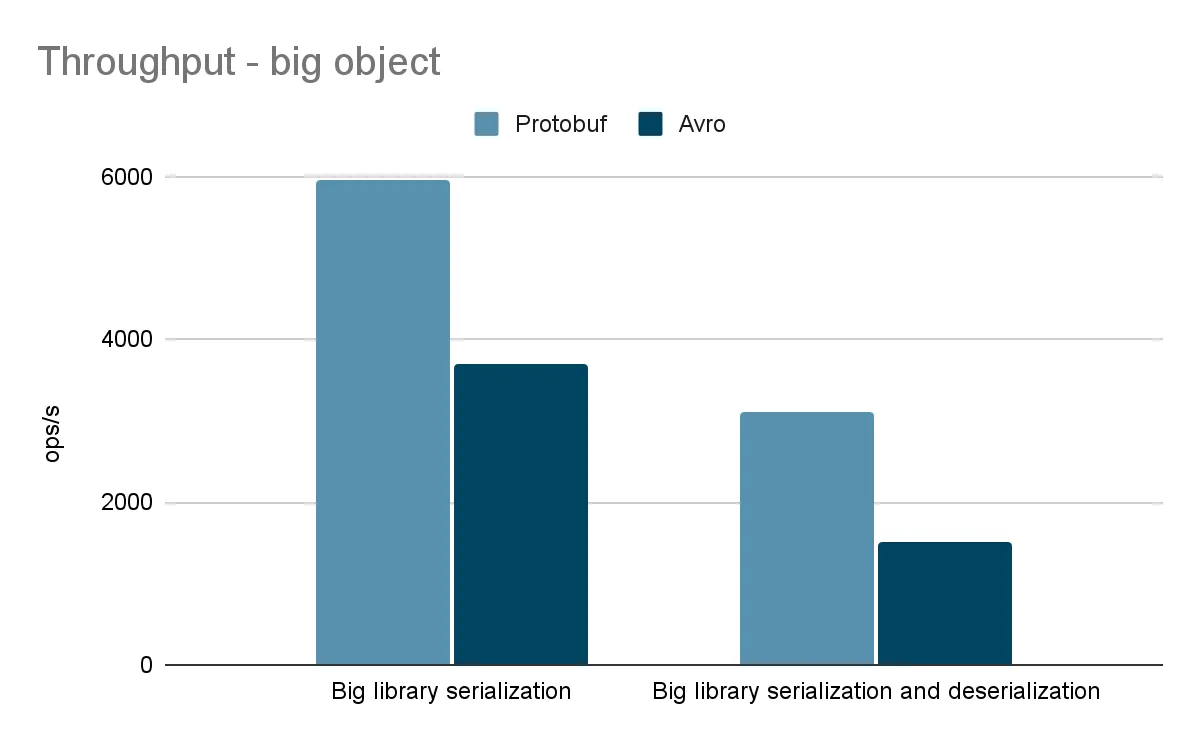
Ես կենտրոնացա թողունակության վրա, քանի որ գործողության միջին ժամանակը չափազանց կարճ էր՝ ֆրեյմվորքների միջև որևէ տարբերություն ցույց տալու համար։
Բոլորն օգտագործեցին JMH-ի նույն կարգավորումները.
@Warmup(iterations = 3, time = 3)
@Fork(3)
@Measurement(iterations = 100, time = 3)
Սա պահանջում է երեք warm-up գործարկում և հարյուր իտերացիայից բաղկացած երեք կատարում։ Warmup-ի և իտերացիաների ժամանակները տրվում են վայրկյաններով։
Յուրաքանչյուր խումբ ընդգրկում է չորս սցենար.
- փոքր գրադարանի սերիալիզացիա
- մեծ գրադարանի սերիալիզացիա
- փոքր գրադարանի սերիալիզացիա և դեսերիալիզացիա
- մեծ գրադարանի սերիալիզացիա և դեսերիալիզացիա
Բացի այդ, ես համեմատեցի մեկ, տասը, հազար և մեկ միլիոն գիրք պարունակող գրադարանների սերիալիզացված չափը։ Թեստերը կատարվել են Ubuntu 22.04.2 LTS-ով, 11th Gen Intel i9-11900H 2.50 GHz պրոցեսորով, 64GB DDR4 հիշողությամբ և OpenJDK 17.0.5 JVM-ով։
Ահա մեր ստացած արդյունքները.
| Գրքերը գրադարանում | Protobuf | Avro |
|---|---|---|
| Սերիալիզացված չափը, մեկ գիրք | 56 բայթ | 54 բայթ |
| Սերիալիզացված չափը, տասը գիրք | 479 բայթ | 441 բայթ |
| Սերիալիզացված չափը, հազար գիրք | 55441 բայթ | 51508 բայթ |
| Սերիալիզացված չափը, մեկ միլիոն գիրք | 68539057 բայթ | 64547317 բայթ |
Եզրակացություն
Մեր թեստերը ցույց են տալիս, որ Protobuf-ը հաղթում է սերիալիզացիայի և դեսերիալիզացիայի արագությամբ։ Avro-ն իր հերթին տալիս է մի փոքր ավելի կոմպակտ սերիալիզացված տվյալներ։ Թե որն ընտրել, մեծ մասամբ կախված է նրանից, թե ինչ է պետք ձեր բաշխված համակարգին։ Եթե արտադրողականությունը վճռորոշ է, Protobuf-ի արագությունն ու արդյունավետությունը կարող են այն դարձնել ավելի լավ տարբերակ։ Եթե ձեզ անհրաժեշտ են ավելի բարդ տվյալների կառուցվածքներ կամ ներկառուցված սեղմում, Avro-ն կարող է ավելի հարմար լինել ձեզ։
Ինչ սերիալիզացիայի ֆրեյմվորք էլ ընտրեք, հիշեք, որ սերիալիզացիան բաշխված համակարգի միայն մի մասն է։ Այլ ասպեկտներ, ինչպիսիք են ցանցային հապաղումը, տվյալների հետևողականությունը, CPU-ի օգտագործումը և օգտագործվող գրադարանները, նույնպես ազդում են ձեր համակարգի ընդհանուր արտադրողականության և հուսալիության վրա։ Այս բոլոր գործոնները խնամքով կշռադատելը և ձեր կարիքներին համապատասխանող սերիալիզացիայի ֆրեյմվորքն ընտրելը կօգնի ձեզ կառուցել արագ, արդյունավետ և հուսալի բաշխված համակարգ։