Avro مقابل Protobuf: مقارنة بين أدوات تسلسل البيانات
تقارن هذه المقالة أداء Protobuf وAvro وفق عدة مقاييس: زمن الترميز وزمن فك الترميز وحجم البيانات المتسلسلة والإنتاجية.
يؤدي تسلسل البيانات (data serialization) دورًا محوريًا في تطوير البرمجيات اليوم، إذ يتيح للتطبيقات تبادل البيانات بصيغة مدمجة وفعّالة لا تعتمد على المنصة. ومن أنظمة تسلسل البيانات الشائعة الاستخدام Protocol Buffers من Google (Protobuf) وAvro من Apache. ولكل منهما مزاياه وعيوبه، لكن الأداء من أهم ما يزنه المطورون عند المفاضلة بين Protobuf وAvro. في هذه المقالة نقارن أداء Protobuf وAvro وفق عدة مقاييس: زمن الترميز وزمن فك الترميز وحجم البيانات المتسلسلة والإنتاجية.
من خلال فحص نتائج هذه الاختبارات أريد مساعدة المطورين على فهم أداء كل نظام بشكل أفضل وكيفية اختيار النظام الذي يطابق متطلباتهم الخاصة.
نظرة سريعة على Protobuf وAvro
أنشأت Google نظام Protobuf عام 2008، وهو برنامج مفتوح المصدر. ويهدف إلى أن يكون بسيطًا وسريعًا وفعّالًا، ويدعم لغات برمجة كثيرة، منها C++ وJava وPython وRuby. ويصف Protobuf بنية البيانات بلغة تعريف مخططات (schema)، تُترجم بعد ذلك إلى كود يقوم بتسلسل البيانات وفك تسلسلها.
وأنشأت Apache نظام Avro عام 2009، وهو أيضًا برنامج مفتوح المصدر. وقد بُني Avro مع مراعاة تطور المخطط (schema evolution)، بحيث يمكن تسلسل البيانات وفك تسلسلها حتى بعد تغيّر المخطط. ويغطي Avro مجموعة اللغات نفسها تقريبًا التي يغطيها Protobuf، مع دعم جيد بشكل خاص لـ Java وPython وRuby. ويصف بنية البيانات بلغة تعريف مخططات قائمة على JSON، ويمكن تخزين المخطط مع البيانات.
عند المقارنة بين Protobuf وAvro، من المفيد معرفة كيف يُستخدم كل منهما في مختلف القطاعات والتطبيقات. فيما يلي أمثلة على حالات الاستخدام للصيغتين.
Protobuf:
- بنت Google نظام Protobuf أول الأمر لأنظمتها الداخلية، مثل Google Search وGoogle Maps وGmail.
- gRPC للتواصل بين الخدمات المصغّرة.
- المؤسسات المالية، في التداول عالي التردد وإدارة المخاطر وكشف الاحتيال.
- يستخدمه مطورو الألعاب لتحسين أداء الشبكة وتقليل استهلاك عرض النطاق.
- تطبيقات إنترنت الأشياء (IoT)، لإرسال البيانات بين أجهزة مثل المستشعرات والبوابات والخوادم السحابية.
- تطبيقات السيارات، لتبادل البيانات بين السيارات والبنية التحتية مثل إشارات المرور وعدادات الوقوف.
Avro:
- يستخدم Apache Hadoop، منصة البيانات الضخمة مفتوحة المصدر، نظام Avro لتسلسل البيانات وتبادلها بين مكونات Hadoop.
- أنظمة المراسلة مثل Apache Kafka وApache Pulsar، لبث البيانات بين التطبيقات والخدمات.
- منصات التحليلات مثل Apache Spark وApache Flink، لمعالجة البيانات وتحليلها.
- أطر تعلّم الآلة مثل TensorFlow وPyTorch، لتسلسل البيانات وتمريرها بين مرحلتي التدريب والاستدلال.
- أدوات جمع السجلات مثل Apache Flume وApache NiFi، لبث بيانات السجلات من مصادر كثيرة إلى مكان مركزي واحد.
بوجه عام، يُفضَّل Protobuf في البيئات منخفضة زمن الاستجابة وعالية الأداء، بينما يُفضَّل Avro في البيانات الضخمة والأنظمة الموزعة والتحليلات. ومع ذلك يمكن لكل من الصيغتين خدمة أنواع كثيرة من التطبيقات، ويعتمد الاختيار الصحيح على المتطلبات والقيود الخاصة بحالة الاستخدام المعنية.
المتطلبات المسبقة
لمقارنة أداء Protobuf وAvro نستخدم JMH (Java Microbenchmark Harness)، وهي أداة شائعة لقياس أداء كود Java. توفر JMH طريقة متينة وموثوقة لقياس أداء قطع صغيرة من الكود في بيئة خاضعة للتحكم، بحيث نستطيع المقارنة بين Protobuf وAvro بدقة وفق مقاييس مثل زمن الترميز وزمن فك الترميز وحجم البيانات المتسلسلة والإنتاجية. وبالنسبة إلى بيانات الاختبار، أنشأت كائنًا نموذجيًا يُسلسَل بكل من Protobuf وAvro. وهو نموذج مبسّط لمكتبة له حقلا address وbooks. لكل كتاب مؤلف وعدد صفحات وحالة توفر، وللمؤلف اسم ولقب وجنسية. ويكمن فرق مهم بين مخططي Protobuf وAvro في طريقة التعامل مع حقول المجموعات. فيعلن Protobuf عن حقول المجموعات بصياغة خاصة تُعلِّم الحقل بأنه repeated، كما يبين المقطع أدناه.
يوجد إصداران من Protobuf قيد الاستخدام النشط حاليًا – Proto2 وProto3. وقد اخترت الإصدار 3 بدلًا من 2، لأنني أرى أن بنيته أبسط وأسهل في الاستخدام.
syntax = "proto3";

package protobuf;

option java_multiple_files = true;
option java_package = "com.example.protobuf.proto.model";
option java_outer_classname = "LibraryProtos";

message Author {
 optional string name = 1;
 optional string surname = 2;
 optional string nationality = 3;
}

message Book {
 optional string title = 1;
 optional Author author = 2;
 optional int64 pages = 3;
 optional bool available = 4;
}

message Library {
 optional string address = 1;
 repeated Book books = 2;
}
انطلاقًا من هذا التعريف، يستطيع مترجم protocol buffer توليد كود Java.
يعرّف Avro المجموعات على أنها مصفوفة (array)، أي مجموعة من نوع معيّن. وبالنسبة إلى الكائن نفسه، يبدو مخطط Avro كما يلي:
{
 "type": "record",
 "name": "Library",
 "namespace": "com.example.avro.avro.model",
 "fields": [
   {
     "name": "address",
     "type": [
       "null",
       "string"
     ],
     "default": null
   },
   {
     "name": "books",
     "type": {
       "type": "array",
       "items": {
         "type": "record",
         "name": "Book",
         "fields": [
           {
             "name": "title",
             "type": [
               "null",
               "string"
             ],
             "default": null
           },
           {
             "name": "author",
             "type": {
               "type": "record",
               "name": "Author",
               "fields": [
                 {
                   "name": "name",
                   "type": [
                     "null",
                     "string"
                   ],
                   "default": null
                 },
                 {
                   "name": "surname",
                   "type": [
                     "null",
                     "string"
                   ],
                   "default": null
                 },
                 {
                   "name": "nationality",
                   "type": [
                     "null",
                     "string"
                   ],
                   "default": null
                 }
               ]
             }
           },
           {
             "name": "pages",
             "type": [
               "null",
               "long"
             ],
             "default": null
           },
           {
             "name": "available",
             "type": [
               "null",
               "boolean"
             ],
             "default": null
           }
         ]
       }
     }
   }
 ]
}
وباستخدام Avro Java API يمكننا بناء المخطط أعلاه وترجمته إلى Java.
لاختبارات الأداء اخترت نسختين من كائن Library: نسخة صغيرة تحتوي على كتاب واحد ونسخة كبيرة تحتوي على ألف كتاب. ولمنع JVM من إلغاء العمليات بالتحسين، تُعطى حقول النصوص محتوى عشوائيًا وطولًا عشوائيًا (بين 3 و13 حرفًا). يُفضَّل عادةً تجنب العشوائية عند مقارنة الأداء، لكن أثرها في حالتنا ضئيل. واستُخدمت قيم ثابتة فقط عند مقارنة حجم البيانات المتسلسلة، إذ نحتاج هناك إلى كائنات متطابقة.
تذكّر أن الاختبارات نُفذت بلغة Java فقط. وقد تعطي مقارنة Protobuf وAvro بلغات برمجة أخرى نتائج مختلفة، لأن مكتبات التسلسل وخصائص الأداء الخاصة بكل لغة وبيئات التشغيل تتفاوت. ومن الجيد إجراء اختبارات الأداء الخاصة بك وتقييم الأداء باللغة التي تستخدمها فعلًا.
وقت الاختبار
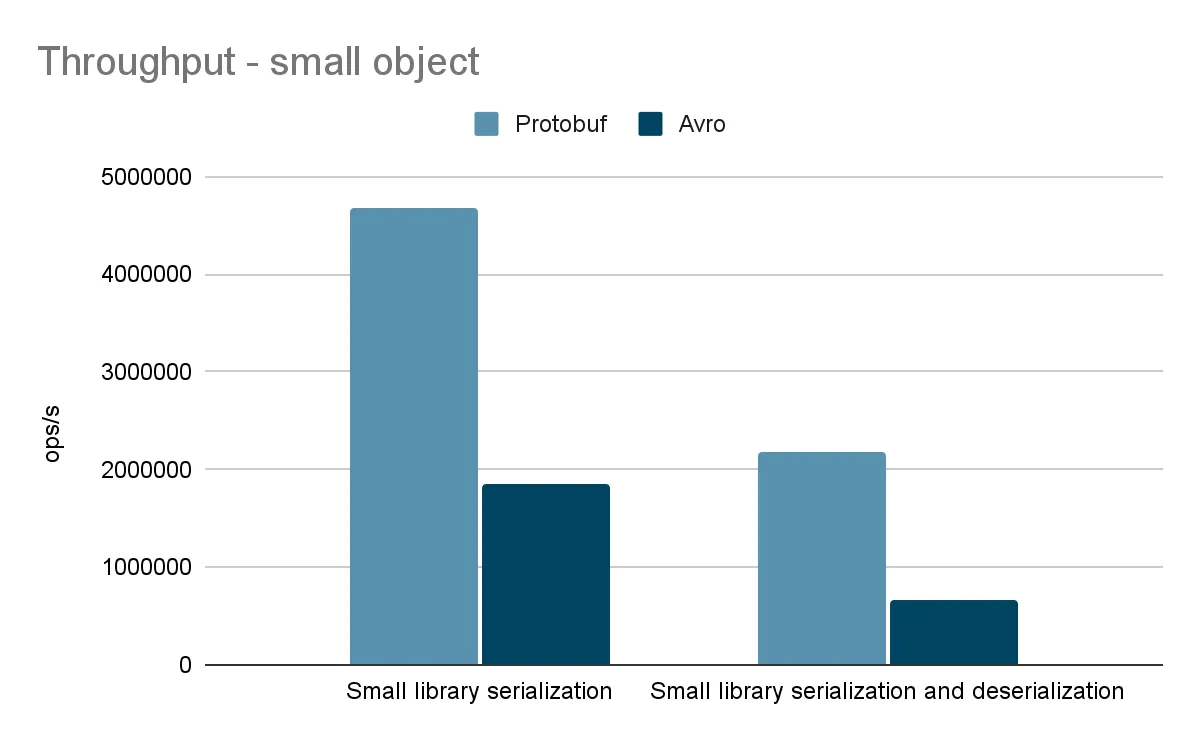
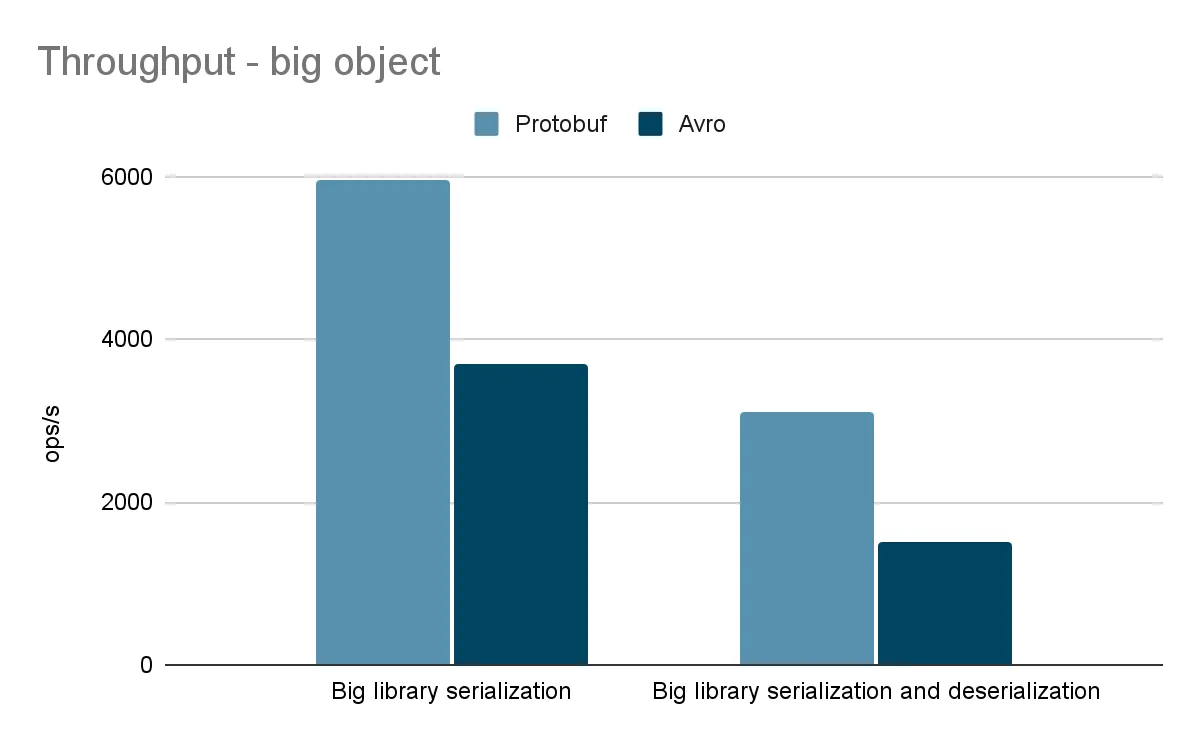
ركّزت على الإنتاجية، لأن متوسط زمن العملية كان أقصر من أن يُظهر أي فروق بين الأطر.
استخدمت جميعها خيارات JMH نفسها:
@Warmup(iterations = 3, time = 3)
@Fork(3)
@Measurement(iterations = 100, time = 3)
يطلب هذا ثلاث جولات إحماء وثلاث عمليات تنفيذ من مئة تكرار لكل منها. وتُعطى أزمنة الإحماء والتكرار بالثواني.
تغطي كل مجموعة أربعة سيناريوهات:
- تسلسل مكتبة صغيرة
- تسلسل مكتبة كبيرة
- تسلسل وفك تسلسل مكتبة صغيرة
- تسلسل وفك تسلسل مكتبة كبيرة
إضافة إلى ذلك، قارنت حجم البيانات المتسلسلة لمكتبات تحتوي على كتاب واحد وعشرة كتب وألف كتاب ومليون كتاب. وأُجريت الاختبارات على Ubuntu 22.04.2 LTS ومعالج Intel i9-11900H من الجيل الحادي عشر بتردد 2.50 GHz وذاكرة DDR4 سعتها 64GB وJVM من نوع OpenJDK 17.0.5.
وهذه هي النتائج التي حصلنا عليها:
| عدد الكتب في المكتبة | Protobuf | Avro |
|---|---|---|
| الحجم المتسلسل، كتاب واحد | 56 بايت | 54 بايت |
| الحجم المتسلسل، عشرة كتب | 479 بايت | 441 بايت |
| الحجم المتسلسل، ألف كتاب | 55441 بايت | 51508 بايت |
| الحجم المتسلسل، مليون كتاب | 68539057 بايت | 64547317 بايت |
الخلاصة
تُظهر اختباراتنا أن Protobuf يتفوق في سرعة التسلسل وفك التسلسل. أما Avro فينتج بدوره بيانات متسلسلة أكثر إحكامًا بقليل. ويعتمد الاختيار بينهما أساسًا على ما يحتاجه نظامك الموزع. فإذا كان الأداء حاسمًا، فقد تجعل سرعة Protobuf وكفاءته الخيار الأفضل. وإذا كنت تحتاج إلى بنى بيانات أكثر تعقيدًا أو ضغطًا مدمجًا، فقد يناسبك Avro أكثر.
وأيًّا كان إطار التسلسل الذي تعتمده، تذكّر أن التسلسل ليس سوى جزء واحد من النظام الموزع. فجوانب أخرى، مثل زمن استجابة الشبكة واتساق البيانات واستخدام المعالج والمكتبات المستخدمة، تؤثر أيضًا في الأداء العام لنظامك وموثوقيته. وسيساعدك وزن كل هذه العوامل بعناية واختيار إطار التسلسل الذي يناسب احتياجاتك على بناء نظام موزع سريع وفعّال وموثوق.