Ինչպես պատրաստվել AWS ML Specialty վկայագրին
Քննության համառոտ ուղեցույց, որը կօգնի ձեզ ստանալ AWS Machine Learning Specialty վկայագիրը։
Լինելով ML ինժեներ՝ ծրագրային ինժեներիայի ամուր փորձով, ես հաճախ բռնում եմ ինքս ինձ reinvent the wheel փորձելիս, ինչպես ասում են։ Մշակման բազմաթիվ ժամերից հետո ես պարբերաբար հայտնաբերում եմ պատրաստի լուծում, որն իմ կոդից ավելի լավ է աշխատում և, ինչը կարևոր է, հետագայում սպասարկում չի պահանջի։
Բնականաբար, պատրաստի լուծումները հաճախ ունենում են սահմանափակ կարգավորման հնարավորություններ և կարող են տուժել հեղինակների կատարած փոփոխություններից, բայց շատ դեպքերում դրանք թույլ են տալիս մեր լուծումը կառուցել ավելի քիչ աշխատանքով և ժամանակի մի մասում։
Սա լուծելու և նման լուծումների ուժեղ ու թույլ կողմերը մանրակրկիտ հասկանալու համար ես որոշեցի հանձնել AWS ML Speciality վկայագիրը։ Այն ինձ լայն պատկերացում է տալիս, թե ինչ կարող են անել AWS ML սերվիսները և որտեղ են թերանում (AWS-ը այն ամպն է, որի հետ ես ամենաշատ փորձն ունեի)։
Այս բլոգ գրառումը անցնում է քննության ուղեցույցով, ապա ներկայացնում է չորս հետաքրքիր AWS սերվիս, որոնք կարող են նկատելիորեն բարելավել ձեր ML pipeline-ը՝ կարգավորելուց րոպեներ անց։
Ինչո՞ւ է արժե այն ստանալ
Նախ՝ դուք հասկանում եք, թե ինչ է տեղի ունենում ներսում։ Երբ AI-ն ներդրվում է գրեթե ամենուր, ծրագրային ինժեներները շատ բան կարող են շահել՝ իմանալով, թե ինչպես են աշխատում հիմքում ընկած մոդելներն ու ճարտարապետությունները, և կարողանալով կառուցել ու շտկել դրանք պահանջներին համապատասխան։
Երկրորդ՝ նույնիսկ փորձառու մարդիկ կարող են նոր բան սովորել։ Որպես ML պրակտիկանտ՝ ես կարողացա կարգավորել իմ ML գիտելիքների այն ոլորտները, որտեղ ավելի քիչ գործնական փորձ ունեի, օր.՝ ժամանակային շարքերի որ լուծումն է ամենալավը համապատասխանում որ կարգավորմանը։
Երրորդ՝ վկայագիրը հաստատում է ձեր գիտելիքները և՛ ML-ի, և՛ AWS-ի վերաբերյալ։ Այն ազդանշան է պոտենցիալ գործատուին, որ դուք կարող եք զբաղվել ML թեմաներով և արագ տեղակայել դրանք AWS-ում։ Այս գրառման մեջ ես իրականում նկարագրում եմ մի քանի գործիք, որոնք ես հետաքրքիր և որոշ չափով անսովոր գտա (հաճախ ավելի հեռուն գնալով, քան պարզ մոդելների վարժեցումը Sagemaker-ում)՝ չնայած ոլորտում իմ տարիների փորձին։
Վերջապես, սովորելը ձեզ իրական ML խորհրդատուի զգացողություն է տալիս։ Իմ աշխատանքի մեծ մասը կայանում է ML-ին ավելի քիչ ծանոթ մարդկանց դրած պահանջներին լավագույնս համապատասխանող լուծում գտնելու մեջ։ Հարցերը հաճախ ձևակերպվում են իրական խնդրի պես (օր.՝ կառուցել Amazon Alexa նվազագույն ջանքով), և դուք պետք է հաճախորդին տաք ամենահարմար լուծումը (մտածեք e2e գործիքների համադրման մասին, ինչպիսիք են Lex-ը և Polly-ն)։
AWS ML ուսուցման ուղին
Այս մասնագիտացումը գտնվում է AWS-ի առաջարկած մեքենայական ուսուցման դասընթացների գագաթին։ Եթե սա կարդալուց հետո ինքներդ ձեզ ավելի քիչ առաջադեմ եք զգում, գուցե ցանկանաք նայել ավելի ցածր մակարդակի վկայագրերին, որոնք կարող են ավելի լավ համապատասխանել ձեր գիտելիքներին։ Նկատի ունեմ ML-ի հետ կապված 2 վկայագրեր (երկուսն էլ գրելու պահին դեռ beta տարբերակով).
- AI Practitioner (Foundational մակարդակ) լավ է աշխատում նաև ավելի քիչ տեխնիկական նախապատմություն ունեցող մարդկանց համար։
- Machine Learning Engineer (Associate մակարդակ) ընդգրկում է ML Speciality մակարդակի նյութի մեծ մասը, բայց ավելի հեշտ յուրացվող մանրամասներով և ավելի քիչ ML փորձառությամբ։
Բացի այդ, քանի որ ML դերերը շատ տեսակի են (MLOps, Prompt Engineer, Data Scientist կամ ML Engineer), ես կարող եմ խորհուրդ տալ այս ուղեցույցը (AWS-ի պաշտոնական կայքից).
Աղբյուր՝ AWS journey path
Քննության ձևաչափը և մանրամասները
ML Specialization քննությունը AWS վկայագրային քննություն է, որը բաղկացած է բազմակի ընտրությամբ հարցերից (որոնցից մի քանիսն ունեն մեկից ավելի ճիշտ պատասխան)։ Այս քննության համար դուք ունեք 180 րոպե՝ 65 հարցի պատասխանելու համար։ Այն լավ հավասարակշռված կերպով զուգակցում է ամպին վերաբերող գիտելիքները և ML-ին հատուկ փորձառությունը։
Հարցերը գալիս են հետևյալ ոլորտներից (domains).
Աղբյուր՝ [Պաշտոնական ML Specialty ուսումնական ուղեցույց](https://d1.awsstatic.com/training-and-certification/docs-ml/AWS Certified Machine Learning - Specialty_Exam Guide (1).pdf)
Անցողիկ միավորը 750-ից բարձր ցանկացած արդյունք է (100-1000 սանդղակով)։
Ուղեցույցը նշում է, որ ոլորտների ներսում հարցերը կարող են ընդգրկել հետևյալ թեմաները (մեջբերված է [AWS ուսումնական ուղեցույցից](https://d1.awsstatic.com/training-and-certification/docs-ml/AWS Certified Machine Learning - Specialty_Exam Guide (1).pdf)).
- Domain 1: Data Engineering
- 1.1 Կառուցել տվյալների պահոցներ մեքենայական ուսուցման համար։
- 1.2 Որոշել և իրականացնել տվյալների ներմուծման լուծում։
- 1.3 Որոշել և իրականացնել տվյալների փոխակերպման լուծում։
- Domain 2: Exploratory Data Analysis
- 2.1 Մաքրել և պատրաստել տվյալները մոդելավորման համար։
- 2.2 Կատարել feature engineering։
- 2.3 Վերլուծել և վիզուալիզացնել տվյալները մեքենայական ուսուցման համար։
- Domain 3: Modeling
- 3.1 Բիզնես խնդիրները ձևակերպել որպես մեքենայական ուսուցման խնդիրներ։
- 3.2 Տվյալ մեքենայական ուսուցման խնդրի համար ընտրել ճիշտ մոդել(ներ)ը։
- 3.3 Վարժեցնել մեքենայական ուսուցման մոդելներ։
- 3.4 Կատարել հիպերպարամետրերի օպտիմիզացիա։
- 3.5 Գնահատել մեքենայական ուսուցման մոդելները։
- Domain 4: Machine Learning Implementation and Operations
- 4.1 Նախագծել մեքենայական ուսուցման լուծումներ արտադրողականության, հասանելիության, մասշտաբավորման, դիմակայունության և սխալների հանդուրժողականության համար։
- 4.2 Տվյալ խնդրի համար առաջարկել և իրականացնել մեքենայական ուսուցման համապատասխան սերվիսներ և հնարավորություններ։
- 4.3 Մեքենայական ուսուցման լուծումներում կիրառել AWS անվտանգության հիմնարար պրակտիկաներ։
- 4.4 Տեղակայել և շահագործման հանձնել մեքենայական ուսուցման լուծումները։
Քանի որ այս պահանջները կարող են որոշ չափով աղոտ թվալ, հաջորդ բաժնում թվարկված են ուսումնասիրության որոշ օգտակար ռեսուրսներ։
Օգտակար ռեսուրսներ
Քննությանը պատրաստվելու համար ես անցա երկու դասընթաց՝ մեկը Whizlab-ից և դասընթաց Udemy-ում (Stephen Mareek-ի և Frank Kane-ի կողմից)։
Stephan Mareek-ի և Frank Kane-ի ML դասընթացը քննությունն անցնելու ամենաարդյունավետ ռեսուրսն է։ Նյութը բացատրվում է հստակ՝ շեշտը դնելով այն տեղեկատվության վրա, որը հավանաբար կհայտնվի քննության ժամանակ։
Whizlab-ի դասընթացը, ընդհակառակը, գերազանց է գործնական փորձ ձեռք բերելու համար (12-ից ավելի լաբորատորիաներով), ինչը օգնում է հասկանալ, թե ինչպես են որոշակի գործիքներն արտաքինից երևում AWS Console-ում և ինչ պարամետրեր են առաջարկում։
AWS Skill Builder-ը հիանալի հավելում է ձեր ուսումնասիրությանը և օգնում է գտնել գիտելիքներ ձեր հոդվածներում։
Վերջապես, կա AWS փաստաթղթերը (ML-ի, Sagemaker-ի կամ տվյալների հետ կապված այլ գործիքների համար), որոնք օգտակար եղան քննության մի շարք հարցերի համար։
Քննության խորհուրդներ
Ինչպես հավանաբար կարող եք նկատել, ես բավականին շատ փորձնական քննություններ հանձնեցի՝ պատրաստվելու և ինքնավստահություն ձեռք բերելու համար, ուստի ահա մի քանի խորհուրդ.
- Քննության ընթացքում հիշեք ժամանակային սահմանափակումները։ Փորձնական անցումներում ես միջինում ավարտում էի ժամանակի մոտ 60%-ում, բայց իրական քննության ժամանակ օգտագործեցի ամբողջ հասանելի ժամանակը։ Ոչ մայրենի լեզվով խոսողները կարող են խնդրել լրացուցիչ 30 րոպե։
- Մտածեք AWS-ի միջոցով փորձնական քննություն ամրագրելու մասին։ Այն ցույց է տալիս՝ արդյոք պատրաստ եք, և ավելի լավ պատկերացում է տալիս, թե ինչպիսին կլինի իրական քննությունը։
- Մի սահմանափակվեք միայն ամենահեշտ և ամենահայտնի հարցաշարերով։ Լուծեք նաև ավելի դժվար հարցեր, որպեսզի պատրաստ լինեք ավելի պահանջկոտ սցենարներին, որոնք նույնպես կարող են հանդիպել քննության ժամանակ։
AWS ML-ի ուշագրավ հնարավորություններ
Այս բաժինը նկարագրում է մի քանի AWS հնարավորություններ, որոնք ես հայտնաբերեցի վկայագրին պատրաստվելիս։
Sagemaker Canvas-ի երկու կողմերը
Sagemaker Canvas workflow-ը որպես no-code մոտեցում ML workflow-ների համար, աղբյուր՝ aws.amazon.com
Քանի որ ես սիրում եմ իմանալ, թե ինչպես են աշխատում հիմքում ընկած բաղադրիչները, թերահավատ էի AutoML-ի ամբողջ միտման նկատմամբ։ AWS SageMaker Canvas-ը, սակայն, բոլորովին այլ բան է։ Այն թույլ է տալիս քաշելով և թողնելով (drag and drop) կառուցել ML-ի ամբողջական end-to-end կյանքի ցիկլ։ Նման լուծումները տարածված են AI-ում. Roboflow-ը, Encord-ը և SuperAnnotate-ը առաջարկում են նմանատիպերը։
Թեև այն հավանաբար չի լինի հիմնական ընտրությունը փորձառու Machine Learning ինժեներների համար, ովքեր պետք է հատուկ կարգավորում ունենան, քանի որ դրա թիրախ լսարանն ավելի քիչ տեխնիկական է, այն դեռ կարող է ծառայել ավելի պարզ կիրառման դեպքերին, որոնք պետք է արագ առաջ շարժվեն։
Գինն ինքնին չափավոր է. մեկ instance-ը արժե 1.9$/ժ (գումարած փոքր լրացուցիչ վճարներ, երբ գերազանցում եք 5GB տվյալները)։
Այդուհանդերձ, ինչպես գիտի յուրաքանչյուրը, ով օգտագործել է AWS, ինչ-որ պահի կարող եք մոռանալ, որ որոշակի սերվիս դեռ աշխատում է, մինչդեռ ձեր AWS հաշիվը շարունակում է աճել։ Դա հաճախ է պատահում, բայց AWS Sagemaker Canvas-ի դեպքում կարող է է՛լ ավելի վատ լինել, քանի որ կան որոշ պատմություններ, թե ինչպես AWS-ը փոխել է իր հաշվարկման կանոնները և լրացուցիչ վճարներ առաջացրել թաքնված Canvas instance-ի համար։
Մի խոսքով, AWS Sagemaker Canvas-ը կարող է օգտակար գործիք լինել, երբ պետք է արագ առաքել լուծում, բայց պետք է հատկապես զգույշ լինել չօգտագործվող ռեսուրսները հեռացնելու և ծախսերին ուշադիր հետևելու հարցում։
Արդարության և կողմնապահության լուծումը AWS Clarify-ով
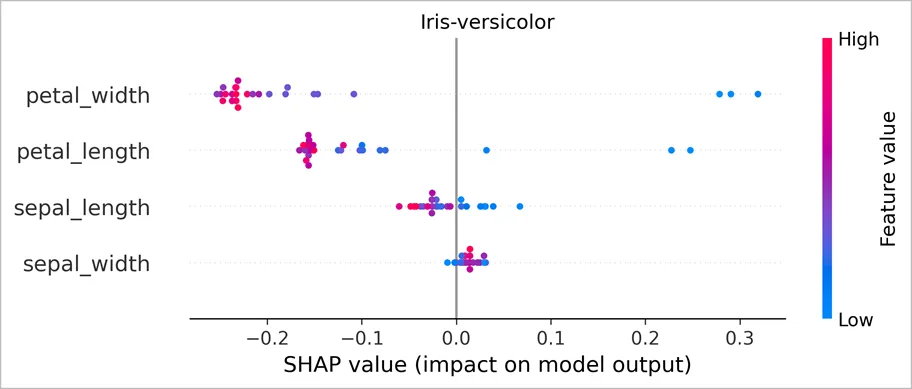
iris տվյալների հավաքածուի գլոբալ բացատրությունները՝ ստացված AWS Clarify-ով, աղբյուր՝ docs.aws.amazon.com
AWS Clarify-ը թույլ է տալիս գնահատել և մեկնաբանել մոդելի արդյունքները, ինչպես նաև ձեր տվյալների հավաքածուի հնարավոր կողմնապահությունները (bias)։ Այս ասպեկտներին ուշադրություն դարձնելը կարող է անհրաժեշտ լինել, երբ տվյալներ պատրաստելիս, մոդել կառուցելիս կամ արտադրական միջավայրում այն գործարկելիս հետևում եք այնպիսի ուղեցույցներին, ինչպիսին է ISO/IEC 42001-ը։
Կողմնապահությունը հայտնաբերելու համար նախ սահմանում եք դեմոգրաֆիական խմբեր (օր.՝ ռասա, սեռ, տարիք և այլն), ապա կարող եք կիրառել հասանելի մետրիկաներից մեկը.
- Class Imbalance – օր.՝ դասը կարող է թերներկայացված լինել։
- Demographic Parity Difference – չափում է, թե ինչպես են դրական արդյունքները տարբերվում դեմոգրաֆիական խմբերի միջև (օր.՝ արդյոք սպիտակ տղամարդիկ հակված են ավելի բարձր վարկային միավորներ ստանալու)։
- The difference in Positive/ Negative Outcome – չափում է, թե ինչպես են դրական և բացասական արդյունքների հավանականությունը տարբերվում խմբերի միջև։
- Disparity Impact – օր.՝ ստուգել, որ փոքրամասնությունների խմբերը անարդար անբարենպաստ վիճակում չեն դրվում։
- Equal opportunity difference – չափում է, թե ինչպես են իսկական դրական արդյունքների (true positive) մակարդակները տարբերվում խմբերի միջև։
- Average odds difference – համեմատում է կեղծ դրական (false positive) և իսկական դրական մակարդակների տարբերությունները խմբերի միջև։
- Conditional Demographic Parity – ստուգում է՝ արդյոք դրական արդյունքները արդար են խմբերի միջև՝ պայմանավորելով այլ հատկանիշներով։
Մոդելի մեկնաբանելիության համար AWS Clarify-ը տրամադրում է Kernel SHAP և՛ լոկալ մեկնաբանելիության (մեկ նմուշի համար), և՛ գլոբալ մեկնաբանելիության (մեկ տվյալների հավաքածուի համար)։ Այս արժեքները օգնում են բացատրել հատկանիշների ներդրումը և՛ վարժեցման, և՛ տեղակայման ընթացքում, ինչը կարող է ծառայել որպես ամուր մեկնարկային կետ տվյալների դրեյֆը (data drift) հայտնաբերելու համար։
Պիտակավորման ժամանակի հեշտ կրճատում AWS Ground Truth Autolabeling-ով
SageMaker Ground Truth-ը կիրառված LIDAR տվյալների վրա, աղբյուր՝ aws.amazon.com
Ինչ վերաբերում է պիտակավորման գործիքներին, AWS-ինը նման է մնացածին։ Այն, ինչ այն առանձնացնում է, active learning-ն է, որը պիտակավորումը դարձնում է հիբրիդային գործընթաց՝ զուգակցելով մարդ պիտակավորողների աշխատանքը ավտոմատ կերպով վերավարժեցվող մոդելի հետ։ AWS ամպում հասանելի մոդելների հսկայական շրջանակի հետ (Bedrock, նվիրված սերվիսներ կամ հատուկ տեղակայված մոդելներ) զուգակցվելիս սա կարող է շատ հզոր համադրություն դառնալ։
Կարգավորման մասով AWS-ը իր ուղեցույցում խորհուրդ է տալիս պիտակավորել առնվազն 1250 օբյեկտ (5000-ը՝ խստորեն առաջարկվում է)։ Այնուհետև workflow-ն վարժեցնում է մոդել տվյալ ոլորտի համար և գործարկում է այն փաթեթային (batch) ռեժիմով՝ տվյալների հավաքածուի չպիտակավորված մասը պիտակավորելու համար (երբ պիտակի վստահությունը գերազանցում է կարգավորված վստահության շեմը)։ Ցածր վստահությամբ օրինակները գնում են մարդ պիտակավորողներին։ Այս երկու վերջին քայլերը կրկնվում են, մինչև ցածր վստահությամբ օրինակներ չմնան։ Այս հիբրիդային workflow-ը կարող է զգալիորեն կրճատել պիտակավորման ժամանակը (մինչև 70%-ով, ըստ AWS-ի)։ Ավելի մանրամասների համար խորհուրդ եմ տալիս AWS-ի այս ուղեցույցը։
AWS Ground Truth-ը հայտնի է նաև իր էժան, ըստ պահանջի Mechanical Turk աշխատուժով։ Սակայն լուծումների մեծ մասը կամ պահանջում են մասնագիտացված ոլորտային գիտելիք, կամ ունեն տվյալների գաղտնիության խիստ պահանջներ, ինչը սահմանափակում է AWS աշխատուժի օգտակարությունը։
Մարդու կողմից վերանայում AWS Augmented AI-ով
Machine Learning լուծում նախագծելիս 100% ճշգրտության հասնելը գրեթե անհնար է։ Սովորաբար պետք է գտնել լավագույն հավասարակշռությունը կեղծ դրական և կեղծ բացասական արդյունքների միջև։ Բայց ի՞նչ, եթե դա անպայման կորած մարտ չէ։
AWS Augmented AI-ը թույլ է տալիս ցածր վստահությամբ նմուշների համար ավելացնել մարդու կողմից վերանայում՝ փաստորեն կառուցելով հիբրիդային համակարգ, որը ավելի դժվար օրինակների համար մարդկանց ներգրավում է գործընթացում (human in the loop)։
Համառոտ (մանրամասների համար տե՛ս այստեղ) քայլերը հետևյալն են.
- Sagemaker Ground Truth-ում կարգավորել պիտակավորման աշխատուժ (ընդամենը մի քանի սեղմում կոնսոլում)։
- A2I-ի միջոցով կարգավորել մարդկային workflow և կցել դրան պիտակավորման աշխատուժը (էլի մի քանի սեղմում)։
- Կանչել workflow-ն ցանկացած տեղ, որտեղ պատասխան է պահանջվում։
Ստորև բերված կոդը (քայլ 3) հայտնաբերում է զգայուն և մեծահասակների բովանդակություն AWS Recognition սերվիսով։ Եթե ձեր կիրառման դեպքի համար անհրաժեշտ է հատուկ առաջադրանք, նայեք այս ուսումնական նյութը։
response = client.detect_moderation_labels(
            Image={
                "S3Object":{
                    "Bucket": "amzn-s3-demo-bucket",
                    "Name": "image-name.png"
                }
            },
            HumanLoopConfig={
               "FlowDefinitionArn":"arn:aws:sagemaker:us-west-2:111122223333:flow-definition/flow-definition-name",
               "HumanLoopName":"human-loop-name",
               "DataAttributes":{
                    ContentClassifiers:["FreeOfPersonallyIdentifiableInformation"|"FreeOfAdultContent"]
                }
             })
Օրինակ կոդ human in the loop job սկսելու համար, աղբյուր՝ AWS-ի ուղեցույց A2I-ի մասին
Եզրակացություններ
Այս գրառումը տրամադրեց քննության համառոտ ուղեցույց՝ վկայագիրը ստանալու համար, և ներկայացրեց մի քանի գործիք, որոնք կարող են աջակցել ձեր ML տեղակայմանը՝ Sagemaker Canvas-ից, ML workflow-ներ կառուցելու no-code եղանակից, մինչև AWS Clarify՝ կողմնապահության և մեկնաբանելիության գործիք, և մինչև human-in-the-loop լուծումներ ML մոդելների պիտակավորման և տեղակայման համար։