Մեքենայական ուսուցման գրադարաններ, որոնք արժե օգտագործել ցանկացած նախագծում
Մեքենայական ուսուցման նախագծի համար ճիշտ գրադարանների ընտրությունը մեծ ջանք է պահանջում։ Ձեր ժամանակը խնայելու համար ահա ամենահետաքրքիրների ցանկը։
Մեքենայական ուսուցման նախագծերում կարելի է օգտագործել հսկայական թվով գրադարաններ։ Բնականաբար, դրանցից մի քանիսը տարիների ընթացքում ամուր հեղինակություն են ձեռք բերել և ակնհայտ ընտրություն են մեքենայական ուսուցման ալգորիթմների վրա հիմնված նոր նախագիծ սկսողների համար։ Այդուհանդերձ, դրանցից ճիշտ հավաքածուի (կամ ստեկի) կազմելը կարող է բավականին դժվար լինել։
Ինչու
Այս գրառմամբ ես ուզում եմ ներկայացնել մեքենայական ուսուցման գրադարանների ընդհանուր պատկերը և կիսվել այդ գործիքներն օգտագործելու վերաբերյալ մի քանի մտքերով։ Եթե նոր եք սկսում աշխատել մեքենայական ուսուցման գրադարանի հետ, այս տեքստը կտա առկա տարբերակների ընդհանուր պատկերացում և ավելի լավ մեկնարկային կետ հետագա ուսումնասիրության համար։
Ստորև նկարագրված գրադարանները խմբավորել եմ ըստ այն դերի, որ դրանք կարող են խաղալ ձեր նախագծում։
Ահա կատեգորիաները.
- Model Creation – մեքենայական ուսուցման մոդելներ ստեղծելու գրադարաններ
- Working With Data – feature engineering-ի, feature extraction-ի և feature-ների հետ կապված ցանկացած այլ գործողության գրադարաններ
- Hyperparameters Optimization – մոդելի հիպերպարամետրերը կարգավորելու գրադարաններ և գործիքներ
- Experiment Tracking – փորձերի հետևման գրադարաններ և գործիքներ
- Problem Specific Libraries – այնպիսի խնդիրների գրադարաններ, ինչպիսիք են ժամանակային շարքերի կանխատեսումը, համակարգչային տեսողությունը և տարածական տվյալների մշակումը
- Utils – գրադարաններ, որոնք խիստ առումով մեքենայական ուսուցման մասին չեն, բայց ես դրանք օգտակար եմ գտել իմ նախագծերում
Model Creation
PyTorch
Ստեղծվել է Facebook-ի ինժեներների կողմից և բաց ծածկագրով հրապարակվել 2017 թվականին։ Այն շուկայի ամենահայտնի մեքենայական ուսուցման գրադարաններից է և հիմնված է բաց ծածկագրով Torch փաթեթի վրա։ PyTorch էկոհամակարգը ծածկում է մեքենայական ուսուցման բոլոր տեսակի խնդիրները և առաջարկում է մասնագիտացված գրադարանների լայն ընտրանի, օրինակ՝ torchvision կամ torchaudio։
PyTorch-ի հիմնարար տվյալների կառուցվածքը Tensor օբյեկտն է, որը պահում է բազմաչափ տվյալները, որոնց հետ աշխատում է մեր մոդելը։ Գաղափարապես այն նման է NumPy-ի ndarray-ին։ PyTorch-ը կարող է նաև օգտագործել հաշվարկների արագացուցիչներ. այն աջակցում է CUDA-ով NVIDIA GPU-ներ, ROCm, Metal API և TPU։
PyTorch-ի հիմնական գրադարանի առանցքային բաղադրիչը nn modules-ն է, որը պարունակում է շերտեր և գործիքներ, որոնք հեշտացնում են բարդ մոդելների հավաքումը՝ շերտ առ շերտ։
class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.flatten = nn.Flatten()
        self.linear_relu_stack = nn.Sequential(
            nn.Linear(28*28, 512),
            nn.ReLU(),
            nn.Linear(512, 512),
            nn.ReLU(),
            nn.Linear(512, 10),
        )

    def forward(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
Պարզ PyTorch նեյրոնային ցանց՝ կազմված 3 գծային շերտից։
Բացի այդ, PyTorch 2.0-ն արդեն թողարկվել է, ինչն ավելի է լավացնում PyTorch-ը։ PyTorch-ն օգտագործում են նաև շատ ընկերություններ, այդ թվում՝ Uber-ը, Tesla-ն և Facebook-ը։
PyTorch Lighting
Այն կարելի է պատկերացնել որպես PyTorch-ի «հավելում», որի նպատակն է կտրուկ կրճատել մեր մոդելների հետ աշխատելու համար անհրաժեշտ ավելորդ կոդը։
Lightning-ը կառուցված է hook-երի շուրջ՝ ֆունկցիաներ, որոնք կանչվում են մոդելի train/eval ցիկլի որոշակի փուլերում։ Դրա շնորհիվ մենք կարող ենք տրամադրել callback ֆունկցիաներ, որոնք աշխատում են տվյալ պահին, օրինակ՝ երբ ավարտվում է մարզման քայլը։
Trainers-ում Lighting-ը ստանձնում է բազմաթիվ խնդիրներ, որոնք PyTorch-ում պետք է լուծեիք ինքներդ, ինչպես ցիկլը, սարքավորման կանչերը կամ zero grads-ը։
Ստորև կարող եք տեսնել PyTorch-ի (ձախ) և PyTorch Lightning-ի (աջ) մոտավորապես համարժեք կոդի հատվածները։
Աղբյուր՝ https://lightning.ai/docs/pytorch/latest/starter/introduction.html
TensorFlow
Այս գրադարանը, որը ստեղծվել է Google Brain-ի թիմի կողմից, առաջին անգամ թողարկվել է 2015 թվականին Apache 2.0 լիցենզիայով, իսկ 2.0 տարբերակը հայտնվել է 2019-ին։ Այն առաջարկում է կլիենտներ Java, C++, Python և նույնիսկ JavaScript լեզուներով։
Ինչպես PyTorch-ը, այն նույնպես լայնորեն կիրառվում է ոլորտում՝ այնպիսի ընկերությունների կողմից, ինչպիսիք են Google-ը (զարմանալի չէ), AirBnb-ն և Intel-ը։ Google-ը TensorFlow-ի շուրջ ստեղծել է նաև բավականին մեծ էկոհամակարգ, ներառյալ գործիքներ և գրադարաններ, ինչպիսիք են optimization toolkit-ը, TensorBoard-ը (այդ մասին՝ ստորև) կամ recommenders-ը։ TensorFlow-ի էկոհամակարգը նույնիսկ ունի վեբ վրա հիմնված sandbox, որտեղ կարելի է փորձարկել ձեր մոդելի վիզուալիզացիան։
Կրկին, tf.nn մոդուլն ամենակարևոր մասն է՝ տրամադրելով մեքենայական ուսուցման մոդելներ կառուցելու համար անհրաժեշտ բոլոր բաղադրիչները։ Tensorflow-ն իր սեփական Tensor (flow ;p) օբյեկտն է օգտագործում խորը ուսուցման մոդելների տվյալները պահելու համար։ Այն նաև աջակցում է բոլոր հայտնի հաշվարկային արագացուցիչները, ինչպիսիք են CUDA-ն կամ RoCm-ը (համայնքային), Metal API-ն և TPU-ն։
class NeuralNetwork(models.Model):
    def __init__(self):
        super().__init__()
        self.flatten = layers.Flatten()
        self.linear_relu_stack = models.Sequential([
            layers.Dense(512, activation='relu'),
            layers.Dense(512, activation='relu'),
            layers.Dense(10)
        ])
    def call(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
Հիշեք, որ TensorFlow-ն ու Keras-ը օգտագործում են Dense շերտը այնտեղ, որտեղ PyTorch-ը օգտագործում է Linear շերտը։ Մոդելի forward pass-ը նույնպես սահմանվում է call մեթոդում, այլ ոչ թե forward մեթոդում։
Keras
Իր նպատակով և ծագմամբ այս գրադարանը նման է PyTorch Lightning-ին, միայն թե ուղղված է TensorFlow-ին՝ տալով նրան ավելի բարձր մակարդակի ինտերֆեյս։ Ստեղծվել է François Chollet-ի կողմից և թողարկվել 2015 թվականին, ունի միայն Python կլիենտներ։ Keras-ն ունի նաև python գրադարանների իր սեփական հավաքածուն և խնդրին հատուկ գրադարաններ, ինչպիսիք են KerasCV-ն կամ KerasNLP-ն՝ ավելի մասնագիտացված սցենարների համար։
Մինչև 2.4 տարբերակը Keras-ն աշխատում էր TensorFlow-ից բացի մի քանի backend-ների հետ, սակայն այդ թողարկումից ի վեր TensorFlow-ը միակ աջակցվողն է։ Քանի որ Keras-ը ընդամենը ինտերֆեյս է TensorFlow-ի վրա, այն կիսում է ներքևի backend-ի հիմնական հասկացությունները, և նույնը վերաբերում է աջակցվող հաշվարկային արագացուցիչներին։ Keras-ն օգտագործում են այնպիսի ընկերություններ, ինչպիսիք են IBM-ը, PayPal-ը և Netflix-ը։
class NeuralNetwork(models.Model):
    def __init__(self):
        super().__init__()
        self.flatten = layers.Flatten()
        self.linear_relu_stack = models.Sequential([
            layers.Dense(512, activation='relu'),
            layers.Dense(512, activation='relu'),
            layers.Dense(10)
        ])
    def call(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
Հիշեք, որ TensorFlow-ն ու Keras-ը օգտագործում են Dense շերտը այնտեղ, որտեղ PyTorch-ը օգտագործում է Linear շերտը։ Մոդելի forward pass-ը նույնպես սահմանվում է call մեթոդում, այլ ոչ թե forward մեթոդում։
PyTorch vs. TensorFlow
Ինձ կողմից այդքան էլ արդար չէր լինի այս երկուսի համեմատությունը բաց թողնելը։
Ինչպես հենց նոր տեսաք, առաջարկվող հնարավորությունների և շրջակա էկոհամակարգերի առումով դրանք բավականին նման են։ Իհարկե, յուրաքանչյուրի աշխատանքի կամ առաջարկի մեջ կան փոքր տարբերություններ և առանձնահատկություններ, բայց ես դրանք քիչ թե շատ աննշան եմ համարում։
Իրականում դրանց տարբերում է այն, թե ինչպես են դրանք սահմանում և կատարում մեքենայական և խորը ուսուցման մոդելների հաշվարկային գրաֆները։
- PyTorch-ը հենվում է դինամիկ հաշվարկային գրաֆների վրա, այսինքն՝ գրաֆը կառուցվում է ուղղակի կոդի կատարման ընթացքում։ Սա ավելի մեծ ճկունություն է տալիս և դեբագն ավելի ինտուիտիվ է դարձնում, քանի որ մշակողները կարող են փոխել գրաֆը աշխատանքի ընթացքում և հեշտությամբ ստուգել միջանկյալ արդյունքները։ Թերությունն այն է, որ այն կարող է պակաս արդյունավետ լինել, քան ստատիկ գրաֆները, հատկապես բարդ մոդելների դեպքում։ Սակայն PyTorch 2.0-ը փորձում է լուծել այս խնդիրները torch.compile-ով և FX գրաֆներով։
- TensorFlow-ը հենվում է ստատիկ հաշվարկային գրաֆների վրա, որոնք կոմպիլյացվում են աշխատելուց առաջ։ Սա կատարումն ավելի արդյունավետ է դարձնում, քանի որ գրաֆը կարելի է օպտիմալացնել և զուգահեռացնել այն սարքավորման համար, որի վրա այն աշխատելու է։ Մյուս կողմից, դեբագը կարող է ավելի դժվար լինել, քանի որ միջանկյալ արդյունքներին հասանելիությունը հեշտ չէ։
Մեկ այլ նկատելի տարբերություն այն է, որ PyTorch-ը Keras-ից ավելի ցածր մակարդակի է թվում, բայց սովորական TensorFlow-ից՝ ավելի բարձր։ Այս դիրքավորումը PyTorch-ն ավելի ճկուն և պարզ է դարձնում շատ կարգավորումներով հատուկ մոդելներ կառուցելիս։
Մի կողմ թողնելով՝ երկու գրադարաններն էլ շուկայի մոտավորապես հավասար մասնաբաժին ունեն։ Նաև, թեև TensorFlow-ը հենվում է call մեթոդի, իսկ PyTorch-ը՝ forward մեթոդի վրա, երկուսն էլ աջակցում են call սեմանտիկան՝ որպես model(x)-ը կանչելու կրճատ ձև։
Աշխատանք տվյալների հետ
pandas
Եթե աշխատում եք python-ով, հաստատ լսել եք այս գրադարանի մասին։ Այն, ամենայն հավանականությամբ, ամենահայտնի python գրադարանն է ցանկացած տեսակի տվյալների մշակման համար։ Այն առաջին անգամ հայտնվել է 2008 թվականին, իսկ 1.0 տարբերակը եկել է 2012-ին։ Այն առաջարկում է ֆունկցիաներ տվյալների ֆիլտրման, ագրեգացման և ձևափոխման, ինչպես նաև մի քանի տվյալների հավաքածուներ համադրելու համար։
Գրադարանի հիմքում DataFrame օբյեկտն է՝ բազմաչափ աղյուսակ, որը կարող է պահել ցանկացած տիպի տվյալներ։ Գրադարանը մեծ շեշտ է դնում արդյունավետության վրա. դրա որոշ մասեր գրված են մաքուր C-ով՝ ավելի արագ աշխատելու համար։
Արդյունավետությանը զուգահեռ, pandas-ն առաջարկում է բազմաթիվ հնարավորություններ.
- տվյալների մաքրում և նախնական մշակում.
- կրկնօրինակների հեռացում,
- null կամ nan արժեքների լրացում։
- ժամանակային շարքերի վերլուծություն.
- resampling,
- windowing,
- time shift։
Այն կարող է նաև կատարել բազմաթիվ մուտքի/ելքի գործողություններ.
- .csv կամ .xlsx ֆայլերից կարդալ և դրանց գրել
- տվյալների բազայի հարցումներ կատարել
- տվյալներ բեռնել GCP BigQuery-ից (pandas-gbq-ի օգնությամբ)
numpy
Սա ևս մեկ հայտնի գրադարան է տվյալների հետ աշխատելու համար, հիմնականում թվային, data science տիպի։ Դրա ամենահայտնի տարրը ndarray-ն է՝ կառուցվածք, որը ներկայացնում է թվերի բազմաչափ զանգված։
ndarray-ից բացի, numpy-ն առաջարկում է բազմաթիվ բարձր մակարդակի մաթեմատիկական ֆունկցիաներ և գործողություններ այդ տվյալների հետ աշխատելու համար։ Այն, հավանաբար, նաև այս խմբի ամենահին գրադարանն է. դրա առաջին տարբերակը թողարկվել է 2005 թվականին։ Այն գրել է Travis Oliphant-ը՝ հիմնվելով էլ ավելի հին գրադարանի վրա, որը կոչվում էր numeric (թողարկվել է 1996-ին)։
Numpy-ը չափազանց կենտրոնացած է արդյունավետության վրա, և դրա մշակողները շարունակում են փորձել ավելին քամել արդեն իրականացված ալգորիթմներից՝ numpy ֆունկցիաների կատարման ժամանակն ավելի կրճատելու համար։
Ինչպես այստեղ քննարկվող յուրաքանչյուր գրադարան, numpy-ն էլ, բնականաբար, բաց ծածկագրով է և տարածվում է BSD լիցենզիայով։
scipy
Այս գրադարանը նվիրված է գիտական հաշվարկների աջակցությանը։ Թողարկվել է 2001 թվականին, այսինքն՝ numpy-ից (2005) էլ հին է։ Այն կառուցված է numpy-ի վրա, և ndarray-ը ծառայում է որպես հիմնարար տվյալների կառուցվածք ամբողջ scipy-ում։ Մյուս հնարավորությունների թվում այն ավելացնում է ֆունկցիաներ օպտիմիզացիայի, գծային հանրահաշվի, ազդանշանների մշակման, ինտերպոլացիայի և սակավ մատրիցների աջակցության համար։ Ընդհանուր առմամբ, այն numpy-ից ավելի բարձր մակարդակի է, ինչը թույլ է տալիս առաջարկել ավելի բարդ ֆունկցիաներ։
Hyperparameter optimizations
Ray-tune
Սա ray toolset-ի բաղադրիչ է՝ փոխկապակցված գրադարանների հավաքածու՝ բաշխված հավելվածներ կառուցելու համար՝ մեքենայական ուսուցման և Python-ի վրա շեշտադրմամբ։ ml գրադարանի Tune մասը նվիրված է հիպերպարամետրերի օպտիմիզացիային՝ առաջարկելով որոնման ալգորիթմների լայն ընտրանի, ինչպիսիք են grid search-ը, hyperband-ը կամ bayesian optimization-ը։
Ray-tune-ը կարող է աշխատել շուկայում առկա ծրագրավորման լեզուների մեծ մասով և գրադարաններով կառուցված մոդելների հետ։ Model creation բաժնում նշված յուրաքանչյուր գրադարան աջակցվում է ray-tune-ի կողմից։
Ray-tune-ի հիմնական հասկացություններն են.
- Trainables – tune-ի գործարկումներին փոխանցվող օբյեկտներ. դրանք այն մոդելն են, որի պարամետրերը ուզում ենք օպտիմալացնել
- Search space – պարունակում է բոլոր հիպերպարամետրերի արժեքները, որոնք ուզում ենք փորձարկել ընթացիկ trial-ում
- Tuner – օբյեկտ, որը կատարում է գործարկումները. tuner.fit()-ը կանչելով սկսվում է հիպերպարամետրերի լավագույն հավաքածուի որոնումը։ Նվազագույնը պետք է փոխանցել trainable օբյեկտ և search space
- Trial – յուրաքանչյուր trial ներկայացնում է trainable օբյեկտի մեկ գործարկում search space-ից վերցված պարամետրերի որոշակի հավաքածուով։ Trial-ները ստեղծվում են Ray Tune Tuner-ի կողմից։ Քանի որ այն tuner-ի գործարկման արդյունքն է, Trial-ը պարունակում է շատ տեղեկություն.
- այդ trial-ի համար օգտագործված config-ը,
- trial ID-ն,
- շատ այլ բաներ։
- Search algorithms – Tuner.fit-ի տվյալ կատարման ժամանակ կիրառվող ալգորիթմը։ Երբ ոչինչ նշված չէ, Ray Tune-ը լռելյայն օգտագործում է RadomSearch
- Schedulers – օբյեկտներ, որոնք պատասխանատու են գործարկումների կառավարման համար։ Նրանք կարող են դադարեցնել, կանգնեցնել և սկսել trial-ները գործարկման ընթացքում, ինչը կարող է բարձրացնել արդյունավետությունը և կրճատել գործարկման ժամանակը։ Եթե չընտրեք, Tune-ը լռելյայն օգտագործում է FIFO – գործարկումը կատարվում է տարրերով հերթականությամբ, ինչպես սովորական հերթում
- Run Analyses – օբյեկտ, որը պարունակում է Tuner.fit-ի կատարման արդյունքը որպես ResultGrid օբյեկտ։ Այն պարունակում է գործարկման մասին ողջ տվյալները, օրինակ՝ բոլոր trial-ների լավագույն արդյունքը կամ յուրաքանչյուր trial-ի տվյալները
BoTorch
Այս գրադարանը կառուցված է PyTorch-ի վրա և PyTorch էկոհամակարգի անդամ է։ Դրա միակ նպատակը հիպերպարամետրերի օպտիմիզացիան է՝ Bayesian Optimization-ի օգտագործմամբ։
Լինելով այս բաժնի միակ գրադարանը, որը նախատեսված է մեկ կոնկրետ մոդելային գրադարանի հետ աշխատելու համար, BoTorch-ը կարող է խնդրահարույց լինել PyTorch-ից բացի որևէ այլ բանի հետ օգտագործելիս։ Այն նաև միակն է, որը դեռ beta փուլում է և ինտենսիվ մշակման մեջ, ուստի կարող եք հանդիպել անսպասելի խնդիրների։
BoTorch-ի հիմնական ուժեղ կողմը PyTorch-ի հետ ինտեգրացիան է, ինչը դրանց համատեղ աշխատանքը շատ ավելի հեշտ է դարձնում։
Experiment Tracking
Neptune.ai
Այս վեբ վրա հիմնված գործիքը ծառայում է և՛ որպես փորձերի հետևիչ, և՛ որպես մոդելների ռեգիստր։ Այն աշխատում է ամպում՝ դասական SASS մոդելով, թեև եթե բավականաչափ վճռական եք, կարող եք օգտագործել նաև self-hosted տարբերակը։
Այն առաջարկում է dashboard՝ ձեր մոդելի մարզման արդյունքները դիտելու և համեմատելու համար։ Կարող եք օգտագործել նաև առանձին գործարկումների պարամետրերը պահելու համար։ Դրանից բացի, հեշտ է տարբերակավորել տվյալ գործարկման համար օգտագործված տվյալների հավաքածուն՝ ցանկացած մետատվյալների հետ միասին, որոնք օգտակար կհամարեք։
Այն նաև պարզեցնում է ձեր մոդելների տարբերակների կառավարումը։ Բնականաբար, գործիքը կախված չէ որևէ կոնկրետ գրադարանից և կարող է պահել դրանցից ցանկացածով կառուցված մոդելներ։ Ինտեգրացիան հնարավոր դարձնելու համար neptune-ն տրամադրում է REST ոճի API՝ իր սեփական կլիենտի հետ միասին, որը կարելի է ներբեռնել և տեղադրել pip-ով կամ python-ի ցանկացած այլ կախվածությունների կառավարչով։ API-ն բավականին լավ փաստաթղթավորված է և բավականին հեշտ հասկանալի։
Գործիքը վճարովի է, պարզ գնային պլանով՝ բաժանված երեք աստիճանի։ Սակայն եթե այն ձեզ պետք է միայն անձնական նախագծի համար կամ պատկանում եք հետազոտական կամ ակադեմիական ստորաբաժանման, կարող եք դիմել՝ այն անվճար օգտագործելու համար։
Neptune.ai-ը երիտասարդ գործիք է, ուստի կարող է պակասել որոշ հնարավորություններ, որոնք սովոր եք տեսնել փորձերի հետևման այլ գործիքներում։ Այնուամենայնիվ, neptune.ai-ի աջակցման թիմը պատրաստակամորեն արձագանքում է օգտատերերի հետադարձ կապին և ավելացնում է բացակայող ֆունկցիոնալությունը՝ գոնե այդպիսին էր մեր փորձը, քանի որ մենք մեր հաճախորդական նախագծերից մեկում մեծապես հենվում ենք Neptune.ai-ի վրա։
Weights&Biases
Կոչվում է նաև WandB կամ W&B. այս վեբ վրա հիմնված գործիքը տրամադրում է այն ամենը, ինչ պետք է փորձերի հետևման գործիքի և մոդելների ռեգիստրի դեր կատարելու համար։ Դրա հնարավորությունների հավաքածուն մոտավորապես համեմատելի է neptune.ai-ի հետ։
Այդուհանդերձ, weight and biases-ը, կարծես, ավելի լավ վիզուալիզացիաներ է առաջարկում և ընդհանուր առմամբ ավելի հասուն գործիք է, քան Neptune-ը։ WandB-ը նաև թվում է, թե ավելի շատ կենտրոնանում է առանձին նախագծերի և հետազոտողների վրա՝ պակաս շեշտ դնելով համագործակցության վրա։
Դրա գնային պլանը նույնպես պարզ է՝ բաժանված 3 աստիճանի, ներառյալ անվճար աստիճան անձնական օգտագործման համար։ W&B-ն նաև հետազոտողներին և ակադեմիական ստորաբաժանումներին վերաբերվում է այնպես, ինչպես Neptune-ը. նրանք միշտ կարող են օգտագործել Weights and Biases-ը անվճար։
Weight and Biases-ը նաև առաջարկում է REST-ի նման API՝ ինտեգրացիան պարզեցնելու համար։ Թվում է, թե այն ավելի լավ փաստաթղթավորված է և ավելի շատ հնարավորություններ է տալիս, քան Neptune.ai-ինը։ Հետաքրքիր է, որ նրանք առաքում են նաև Java-ով գրված կլիենտ գրադարան՝ այն դեպքի համար, եթե որևէ պատճառով ձեր մեքենայական ուսուցման մոդելը կառուցել եք Java-ով, այլ ոչ թե Python-ով։
TensorBoard
Սա վիզուալիզացիայի գործիքակազմ է, որը կառուցված է հատկապես TensorFlow էկոհամակարգի համար։ Այն նախատեսված է հիմնականում որպես փորձերի հետևման գործիք՝ մետրիկաների վիզուալիզացիայի վրա շեշտով։ Թեև այն TensorFlow-ին հատուկ գործիք է, կարող եք այն օգտագործել նաև Keras-ի (զարմանալի չէ) և PyTorch-ի հետ։
Այն նաև այս բաժնում քննարկվող երեք գործիքներից միակ անվճար տարբերակն է։ Այստեղ կարող եք հոսթ անել և հետևել ձեր փորձերին։ Սակայն Tensorbord-ին պակասում են մոդելների ռեգիստրի հնարավորությունները, ինչը կարող է բավականին անհարմար լինել և կարող է ստիպել դիմել որևէ երրորդ կողմի գործիքի՝ այդ բացը լրացնելու համար։ Իսկ մյուս կողմից, TensorFlow-ի էկոհամակարգը վստահաբար ունի դրա համար գործիք։
Քանի որ այն TensorFlow էկոհամակարգի անմիջական մասն է, այն Keras-ի կամ Tensorflow-ի հետ ինտեգրվում է շատ ավելի սահուն, քան նախորդ երկու գործիքներից որևէ մեկը։
Problem specific libraries
tsaug
Սա ժամանակային շարքերի augmentation-ի այն քիչ գրադարաններից մեկն է։ Այն բաց ծածկագրով է, ստեղծվել է և պահպանվում է մեկ մշակողի կողմից։ Թողարկվել է 2019 թվականին և այժմ 0.2.1 տարբերակի վրա է։ Այն առաջարկում է 9 augmentation-ների հավաքածու, այդ թվում՝ Crop, Add noise կամ TimeWrap։ Այս տեսակի նախագծի համար գրադարանը բավականին լավ փաստաթղթավորված է և պարզ օգտագործման։
Ցավոք, ինձ անհայտ պատճառներով, գրադարանը, կարծես, լքված է և 3 տարի թարմացում չի ստացել։ Բազմաթիվ issue-ներ մնում են բաց, առանց որևէ մեկի ուշադրության։ Ինձ համար սա բավականին ցավալի է, քանի որ քիչ այլ գրադարաններ են առաջարկում augmentation ժամանակային շարքերի տվյալների համար։
Եթե, այնուամենայնիվ, ձեզ ժամանակային շարք է պետք data mining-ի կամ augmentation-ի համար և կնախընտրեք ավելի արդի գրադարան, Tsfresh-ը կարող է լավ տարբերակ լինել։
Opencv
Այս գրադարանը կենտրոնանում է պատկերների մշակման և համակարգչային տեսողության ֆունկցիաների վրա։ Սկզբում կառուցվել է Intel-ի կողմից, այժմ բաց ծածկագրով է Apache 2 լիցենզիայով։
OpenCv-ն առաջարկում է ֆունկցիաների հավաքածու պատկերների և տեսանյութերի մշակման, պատկերների դասակարգման տվյալների վերլուծության և հետևման համար, ինչպես նաև պատրաստի մեքենայական ուսուցման մոդելներ՝ պատկերների և տեսանյութերի հետ աշխատելու համար։
Geopandas
Այս գրադարանը, որը կառուցված է pandas-ի վրա, նպատակ ունի առաջարկել ֆունկցիաներ տարածական տվյալների և տվյալների կառուցվածքների հետ աշխատելու համար։ Այն հեշտացնում է geojson և shapefile ձևաչափերով տվյալների կարդալն ու գրելը, կամ postgis համակարգերից տվյալներ կարդալը։ Բացի pandas-ից, այն կախված է տարածական տվյալների շատ այլ գրադարաններից, ինչպիսիք են pygeos-ը, geopy-ը կամ shapely-ն։
Գրադարանի հիմնական կառուցվածքներն են.
- GeoSeries – աշխարհատարածական տվյալների սյունակ, օրինակ՝ կետերի, գծերի կամ բազմանկյունների շարք
- GeoDataFrame – աղյուսակային կառուցվածք, որը պահում է GeoSeries-ների հավաքածու։
Utils
matplotlib
Ինչպես անունն է հուշում, սա գրադարան է ամեն տեսակի գծապատկերներ նկարելու համար ;p։ Պարզ գծապատկերներից, ինչպիսիք են գծերը կամ հիստոգրամները, բացի matplotlib-ը թույլ է տալիս կառուցել ավելի բարդերը՝ 3d ձևեր կամ բևեռային գծապատկերներ։ Բնականաբար, այն թույլ է տալիս նաև կարգավորել այնպիսի տարրեր, ինչպիսիք են գծապատկերի գույները կամ պիտակները։
Թեև այն բավականին հին է (թողարկվել է 2003-ին, ինչը գրելու պահին նշանակում է 20 տարեկան), այն դեռ ակտիվորեն պահպանվում և զարգանում է։ GitHub-ում մոտ 17 հազար աստղով այն ունի զգալի համայնք և, հավանաբար, երկրորդ ընտրությունն է յուրաքանչյուրի համար, ում տվյալների վիզուալիզացիայի գործիք է պետք։
Այն ունի լավ փաստաթղթավորում և բավականին հեշտ է նորեկների համար։ Արժե նաև նշել, որ matplotlib-ը ծառայում է որպես հիմք ավելի բարձր մակարդակի վիզուալիզացիայի գրադարանների համար։
seaborn
Այդ տեսակի ml գրադարանների մասին խոսելով՝ seaborn-ը մեկ այդպիսի օրինակ է։ Արդյունքում seaborn-ի առաջարկած ֆունկցիոնալությունը նման է matplotlib-ի տրամադրածին։
Սակայն API-ն ավելի բարձր մակարդակի է և համեմատելի արդյունքների համար պահանջում է ավելի քիչ ավելորդ կոդ։ Մյուս փոքր տարբերությունների թվում seaborn-ի գունապնակը ավելի մեղմ է, իսկ գծապատկերները՝ ավելի ժամանակակից և գրավիչ։ Seaborn-ը նաև ամենահեշտն է pandas-ի հետ ինտեգրելու համար, ինչը կարող է զգալի առավելություն լինել։
Ստորև բերված է heatmap նկարելու կոդը matplotlib-ով և seaborn-ով, ինչպես նաև ստացված գծապատկերները։ Import-ները ընդհանուր են։
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

data = np.random.rand(5, 5)

fig, ax = plt.subplots()
heatmap = ax.pcolor(data, cmap=plt.cm.Blues)

ax.set_xticks(np.arange(data.shape[0])+0.5, minor=False)
ax.set_yticks(np.arange(data.shape[1])+0.5, minor=False)

ax.set_xticklabels(np.arange(1, data.shape[0]+1), minor=False)
ax.set_yticklabels(np.arange(1, data.shape[1]+1), minor=False)

plt.title("Heatmap")
plt.xlabel("X axis")
plt.ylabel("Y axis")

cbar = plt.colorbar(heatmap)

plt.show()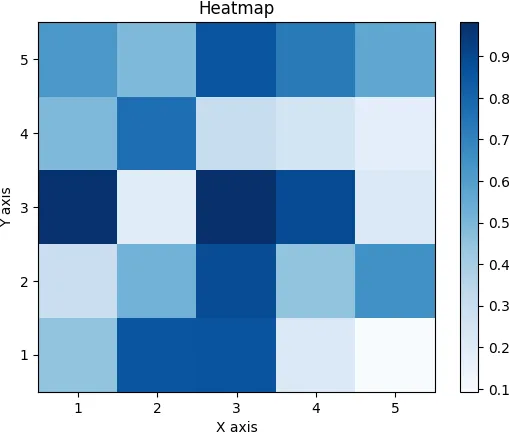
sns.heatmap(data, cmap="Blues", annot=True)
# Set plot title and axis labels
plt.title("Heatmap")
plt.xlabel("X axis")
plt.ylabel("Y axis")
# Show plot
plt.show()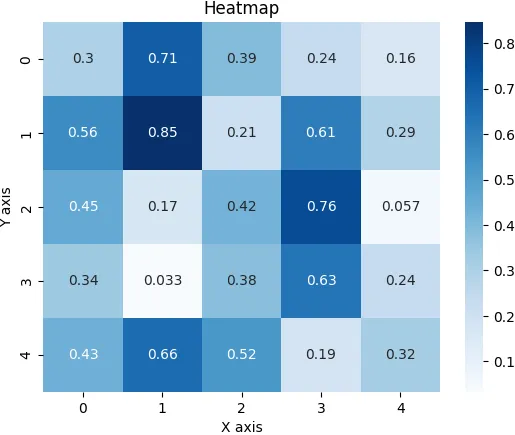
hydra
Ցանկացած նախագիծ վաղ թե ուշ հասնում է մի պահի, երբ ինչ-որ արժեք պետք է դառնա կարգավորելի։ Եթե աշխատում եք jupyter-ի նման գործիքով, դա բավականին պարզ է. պարզապես տվյալ արժեքը տեղափոխում եք .env ֆայլ՝ և ահա, այն արդեն կարգավորելի է։
Սակայն ավելի սովորական հավելված կառուցելիս այդքան հեշտ չէ։ Այստեղ է, որ Hydra-ն դուրս է գալիս իր տգեղ (բայց բավականին հարմար) դեմքով։ Սա բաց ծածկագրով գործիք է Python-ի վրա հիմնված հավելվածների կոնֆիգուրացիաները կառավարելու և գործարկելու համար։
Այն կառուցված է Omega-Conf գրադարանի վրա, և իր գլխավոր էջի խոսքերով՝ “Its central feature is the ability to build a hierarchical configuration dynamically through composition and to override it via config files and the command line.”
Այդ մեջբերման մեջ նշված հնարավորությունը՝ հիերարխիկ կոնֆիգուրացիան, ինձ համար շատ հարմար ստացվեց։ Իմ դեպքում այն լավ կատարեց իր գործը և թույլ տվեց ավելի մաքուր բաժանել կոնֆիգուրացիոն ֆայլերը։
coolname
Ձեր մարզումների գործարկումներին եզակի նույնացուցիչ տալը միշտ խելացի քայլ է։ Եթե որևէ պատճառով UUID-ը ձեզ դուր չի գալիս կամ պարզապես ուզում եք, որ ձեր id-ները մարդու համար ընթեռնելի լինեն, coolname-ը ձեզ կօգնի։ Այն ստեղծում է եզակի, այբբենական, բառերի վրա հիմնված նույնացուցիչներ՝ 2-ից 4 բառ երկարությամբ։
Համադրությունների թիվը մոտավորապես հետևյալն է.
- 4 բառ երկարությամբ նույնացուցիչն ունի 1010 համադրություն
- 3 բառ երկարությամբ նույնացուցիչն ունի 108 համադրություն
- 2 բառ երկարությամբ նույնացուցիչն ունի 105 համադրություն
Դա զգալիորեն քիչ է, քան UUID-ի դեպքում, ինչը նշանակում է բախման ավելի մեծ հավանականություն։ Սակայն երկուսի համեմատությունն այս տեքստի թեման չէ։
Ստեղծողները բառապաշարն ընտրել են ձեռքով և նկարագրում են այն որպես դրական և չեզոք (նախագծի README-ն ավելի մանրամասն նկարագրում է բառացանկերը), ուստի երբեք չեք ստանա you-ugly-unwise-human-being նման նույնացուցիչ։ Բնականաբար, գրադարանը լիովին բաց ծածկագրով է։
tqdm
Այս գրադարանը ձեր հավելվածին ավելացնում է progress bar-ի ֆունկցիոնալություն։ Այդպիսի տեղեկատվության ցուցադրումը գուցե ամենակարևորը չէ, բայց դա դեռ հաճելի է դիտել և թույլ է տալիս հետևել ձեր հավելվածի առաջընթացին, երբ այն կատարում է կարևոր առաջադրանք։
Tqdm-ը նաև հենվում է բարդ ալգորիթմների վրա՝ գնահատելու համար, թե որքան ժամանակ է մնացել առաջադրանքին, ինչը կարող է խաղը փոխող լինել և օգնել ձեր ժամանակը պլանավորելիս։ Tqdm-ը նաև պնդում է, որ իր արդյունավետության վրա ազդեցությունը հազիվ նկատելի է՝ նանվայրկյանների սահմաններում։
Դրանից բացի, այն լիովին ինքնավար է և աշխատելու համար ոչինչ չի պահանջում բացի python-ից, ուստի ձեր սկավառակի վրա կեսը ինտերնետը չի բերի։
jupyter-notebook (+JupyterLab)
Notebook-ները հիանալի միջոց են արդյունքներով կիսվելու և նախագծի վրա համագործակցելու համար։ Բջիջների գաղափարի շնորհիվ հեշտ է առանձնացնել ձեր կոդի տարբեր մասերն ու պատասխանատվությունները։
Այն, որ մեկ notebook ֆայլը կարող է կողք կողքի պահել կոդ, պատկերներ և հարուստ տեքստային ելքեր (աղյուսակներ), միայն ավելացնում է դրա արդեն առկա ուժեղ կողմերը։
Notebook-ները թույլ են տալիս նաև pip install-ն անմիջապես բջիջներում գործարկել և կոնֆիգուրացիայի համար օգտագործել .env ֆայլեր։ Սա ձեր վրայից հանում է ծրագրային ճարտարագիտության շատ բարդություն։
Ամփոփում
Սա այն ամենն է, ինչ ուզում էի ներկայացնել մեքենայական ուսուցման տարբեր գրադարանների մասին։ Իմ նպատակն էր յուրաքանչյուր գրադարանի և դրա հնարավոր կիրառությունների ընդհանուր պատկերն տալ՝ լրացված դրանց հետ աշխատելու իմ փորձի կարճ նշումներով։ Հուսով եմ՝ դա հաջողվեց, և այս հոդվածը ընդլայնեց ձեր պատկերացումը մեքենայական ուսուցման գրադարանների ոլորտի մասին։
Շնորհակալություն ձեր ժամանակի համար։