مكتبات تعلّم الآلة التي تستحق الاستخدام في أي مشروع
اختيار المكتبات المناسبة لمشروع تعلّم الآلة يستهلك جهدًا كبيرًا. وللتوفير عليك الوقت، إليك قائمة بأكثرها إثارة للاهتمام.
يمكن توظيف عدد ضخم من المكتبات في مشاريع تعلّم الآلة. وبطبيعة الحال، اكتسبت قلّة منها سمعة راسخة على مرّ السنين، وهي الخيار البديهي لكل من يبدأ مشروعًا جديدًا يقوم على خوارزميات تعلّم الآلة. ومع ذلك، قد يكون تجميع المجموعة (أو الحزمة) المناسبة منها أمرًا صعبًا إلى حدّ ما.
لماذا هذا المقال
أريد من خلال هذا المقال تقديم نظرة عامة واسعة على مشهد مكتبات تعلّم الآلة، ومشاركة بعض تأملاتي في استخدام هذه الأدوات. إذا كنت قد بدأت للتوّ مع مكتبة لتعلّم الآلة، فقد يمنحك هذا النص خلفية عامة عن الخيارات المتاحة ونقطة انطلاق أفضل لمواصلة التعلّم.
لقد صنّفت المكتبات الموصوفة أدناه بحسب الدور الذي يمكن أن تؤديه في مشروعك.
وهذه هي الفئات:
- بناء النماذج – مكتبات لبناء نماذج تعلّم الآلة
- العمل مع البيانات – مكتبات لهندسة الميزات واستخلاصها وكل عملية أخرى تتعامل مع الميزات
- تحسين المعاملات الفائقة – مكتبات وأدوات لضبط المعاملات الفائقة للنماذج
- تتبّع التجارب – مكتبات وأدوات لتتبّع التجارب
- مكتبات مخصصة لمسائل محددة – مكتبات لمهام مثل التنبؤ بالسلاسل الزمنية والرؤية الحاسوبية ومعالجة البيانات المكانية
- أدوات مساعدة – مكتبات ليست متعلقة بتعلّم الآلة بالمعنى الدقيق، لكنني وجدتها مفيدة في مشاريعي
بناء النماذج
PyTorch
طوّرها مهندسون في Facebook وأُتيحت كمصدر مفتوح عام 2017، وهي من أشهر مكتبات تعلّم الآلة في السوق، وتقوم على حزمة Torch مفتوحة المصدر. يغطي النظام البيئي لـ PyTorch كل أنواع مسائل تعلّم الآلة، ويوفر مجموعة واسعة من المكتبات المتخصصة مثل torchvision أو torchaudio.
بنية البيانات الأساسية في PyTorch هي الكائن Tensor، الذي يخزّن البيانات متعددة الأبعاد التي يعمل عليها نموذجنا. ومن الناحية المفاهيمية يشبه ndarray في NumPy. كما يمكن لـ PyTorch الاستفادة من مسرّعات الحوسبة: فهي تدعم وحدات GPU من NVIDIA المتوافقة مع CUDA، وROCm، وMetal API، وTPU.
المكوّن الأساسي في مكتبة PyTorch الجوهرية هو nn modules، الذي يضم الطبقات والأدوات التي تسهّل تجميع نماذج معقدة طبقة بعد طبقة.
class NeuralNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.flatten = nn.Flatten()
        self.linear_relu_stack = nn.Sequential(
            nn.Linear(28*28, 512),
            nn.ReLU(),
            nn.Linear(512, 512),
            nn.ReLU(),
            nn.Linear(512, 10),
        )

    def forward(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
شبكة عصبية بسيطة في PyTorch مكوّنة من 3 طبقات خطية.
وفوق ذلك، صدر بالفعل PyTorch 2.0 (الإصدارات)، مما جعل PyTorch أفضل. كما تستخدم PyTorch شركات كثيرة، منها Uber وTesla وFacebook.
PyTorch Lighting
يمكنك اعتبارها «إضافة» لـ PyTorch هدفها تقليل الشيفرة النمطية اللازمة للعمل مع نماذجنا تقليلًا كبيرًا.
تقوم Lightning على الخطّافات (hooks) – وهي دوال تُستدعى في مراحل معينة من حلقة تدريب النموذج وتقييمه. بفضل ذلك يمكننا تقديم دوال استدعاء تعمل في لحظة محددة، مثلًا عند انتهاء خطوة تدريب.
وتتولى Lighting عبر المدرّبات (Trainers) مهام كثيرة كان عليك معالجتها بنفسك في PyTorch، مثل الحلقة التكرارية واستدعاءات العتاد وتصفير التدرجات.
فيما يلي مقطعان متكافئان تقريبًا من الشيفرة في PyTorch (يسارًا) وPyTorch Lightning (يمينًا).
المصدر: https://lightning.ai/docs/pytorch/latest/starter/introduction.html
TensorFlow
أنشأ هذه المكتبة فريق في Google Brain، وصدرت أول مرة عام 2015 بموجب رخصة Apache 2.0، ثم تبعها الإصدار 2.0 عام 2019. وتوفر عملاء بلغات Java وC++ وPython وحتى JavaScript.
وكما هو الحال مع PyTorch، تُستخدم على نطاق واسع في القطاع، من شركات مثل Google (وهذا غير مفاجئ) وAirBnb وIntel. كما بنت Google نظامًا بيئيًا كبيرًا حول TensorFlow، يشمل أدوات ومكتبات مثل مجموعة أدوات التحسين وTensorBoard (نتناوله أدناه) وأنظمة التوصية. بل يأتي النظام البيئي لـ TensorFlow بمنطقة تجارب على الويب يمكنك فيها تجربة تصوير نموذجك.
مرة أخرى، تُعدّ الوحدة tf.nn أهم قطعة، إذ توفر كل لبنات البناء اللازمة لإنشاء نماذج تعلّم الآلة. وتعتمد Tensorflow على كائن Tensor الخاص بها (Tensor flow ;p) لتخزين البيانات التي تستخدمها نماذج التعلّم العميق. كما تدعم جميع مسرّعات الحوسبة الشائعة، مثل CUDA أو RoCm (من المجتمع) وMetal API وTPU.
class NeuralNetwork(models.Model):
    def __init__(self):
        super().__init__()
        self.flatten = layers.Flatten()
        self.linear_relu_stack = models.Sequential([
            layers.Dense(512, activation='relu'),
            layers.Dense(512, activation='relu'),
            layers.Dense(10)
        ])
    def call(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
تذكّر أن TensorFlow وKeras تستخدمان الطبقة Dense حيث تستخدم PyTorch الطبقة Linear. كما أن التمرير الأمامي للنموذج يُعرَّف في الدالة call لا في الدالة forward.
Keras
تشبه هذه المكتبة PyTorch Lightning في غايتها وأصلها، إلا أنها تستهدف TensorFlow وتمنحها واجهة أعلى مستوى. أنشأها François Chollet وصدرت عام 2015، وتأتي بعملاء Python فقط. ولدى Keras أيضًا مجموعتها الخاصة من مكتبات Python والمكتبات المخصصة لمسائل محددة مثل KerasCV أو KerasNLP للسيناريوهات الأكثر تخصصًا.
حتى الإصدار 2.4 كانت Keras تعمل مع عدة واجهات خلفية إلى جانب TensorFlow، لكن منذ ذلك الإصدار أصبحت TensorFlow هي الوحيدة المدعومة. ولأن Keras مجرد واجهة فوق TensorFlow، فهي تشترك في المفاهيم الأساسية للواجهة الخلفية التي تحتها، وينطبق الأمر نفسه على مسرّعات الحوسبة المدعومة. وتستخدم Keras شركات مثل IBM وPayPal وNetflix.
class NeuralNetwork(models.Model):
    def __init__(self):
        super().__init__()
        self.flatten = layers.Flatten()
        self.linear_relu_stack = models.Sequential([
            layers.Dense(512, activation='relu'),
            layers.Dense(512, activation='relu'),
            layers.Dense(10)
        ])
    def call(self, x):
        x = self.flatten(x)
        logits = self.linear_relu_stack(x)
        return logits
تذكّر أن TensorFlow وKeras تستخدمان الطبقة Dense حيث تستخدم PyTorch الطبقة Linear. كما أن التمرير الأمامي للنموذج يُعرَّف في الدالة call لا في الدالة forward.
PyTorch مقابل TensorFlow
لن يكون من الإنصاف أن أتجاوز المقارنة بين هاتين المكتبتين.
كما رأيت للتوّ، فهما متشابهتان إلى حدّ كبير في الميزات التي تقدمانها والأنظمة البيئية المحيطة بهما. صحيح أن هناك بعض الاختلافات والخصائص الصغيرة في طريقة عمل كل منهما أو فيما تقدمه، لكنني أعدّها أمرًا هامشيًا إلى حدّ ما.
ما يميّزهما فعلًا هو كيفية تعريفهما وتشغيلهما للرسوم الحسابية لنماذج تعلّم الآلة والتعلّم العميق.
- تعتمد PyTorch على رسوم حسابية ديناميكية، أي أن الرسم يُبنى أثناء تنفيذ الشيفرة. وهذا يمنح مرونة أكبر ويجعل تصحيح الأخطاء أكثر بداهة، لأن المطورين يستطيعون تغيير الرسم أثناء التشغيل وفحص المخرجات الوسيطة بسهولة. أما العيب فهو أنها قد تكون أقل كفاءة من الرسوم الثابتة، خاصة في النماذج المعقدة. غير أن PyTorch 2.0 تحاول معالجة هذه المشكلات عبر torch.compile ورسوم FX.
- تعتمد TensorFlow على رسوم حسابية ثابتة تُترجَم قبل تشغيلها. وهذا يجعل التنفيذ أكثر كفاءة، لأن الرسم يمكن تحسينه وتوزيعه على التوازي بحسب العتاد المستهدف. وفي المقابل، قد يكون تصحيح الأخطاء أصعب، لأن الوصول إلى المخرجات الوسيطة ليس سهلًا.
ومن الفروق الظاهرة أيضًا أن PyTorch تبدو أدنى مستوى من Keras، لكنها أعلى مستوى من TensorFlow الخالصة. ويجعل هذا الموضع PyTorch أكثر مرونة وأسهل استخدامًا عند بناء نماذج مخصصة تتطلب تعديلات كثيرة.
وعلى سبيل الاستطراد، تحتل المكتبتان حصة سوقية متساوية تقريبًا. وأيضًا، رغم أن TensorFlow تعتمد على الدالة call وPyTorch على الدالة forward، فإن كلتيهما تدعم دلالات call كاختصار لاستدعاء model(x).
العمل مع البيانات
pandas
إذا كنت تعمل مع python فلا بد أنك سمعت بهذه المكتبة. فهي على الأرجح أشهر مكتبات python للتعامل مع البيانات بأنواعها. ظهرت أول مرة عام 2008، وصدر الإصدار 1.0 عام 2012. وتوفر دوال للتصفية والتجميع وتحويل البيانات، وكذلك لدمج عدة مجموعات بيانات.
في قلب المكتبة يوجد الكائن DataFrame، وهو جدول متعدد الأبعاد يمكنه احتواء بيانات من أي نوع. وتركّز المكتبة بقوة على الأداء، وبعض أجزائها مكتوب بلغة C الخالصة لتسريعها.
وإلى جانب تركيزها على الأداء، توفر pandas ميزات كثيرة من أجل:
- تنظيف البيانات ومعالجتها المسبقة:
- حذف التكرارات،
- ملء القيم الفارغة أو قيم nan.
- تحليل السلاسل الزمنية:
- إعادة التشكيل (resampling)،
- النوافذ (windowing)،
- الإزاحة الزمنية.
كما تستطيع التعامل مع عمليات إدخال/إخراج كثيرة:
- القراءة من ملفات .csv أو .xlsx والكتابة إليها
- تنفيذ استعلامات قواعد البيانات
- تحميل البيانات من GCP BigQuery (باستخدام pandas-gbq)
numpy
هذه مكتبة أخرى معروفة للعمل مع البيانات، وخاصة البيانات العددية الخاصة بعلم البيانات. وأشهر عناصرها هو ndarray – بنية تمثل مصفوفة متعددة الأبعاد من الأعداد.
وإلى جانب ndarray، توفر numpy دوال وعمليات رياضية كثيرة عالية المستوى للعمل مع تلك البيانات. وهي على الأرجح أقدم مكتبة في هذه المجموعة، إذ صدر أول إصدار منها عام 2005. كتبها Travis Oliphant استنادًا إلى مكتبة أقدم منها تُسمى numeric (صدرت عام 1996).
وتتميز numpy بتوجهها الشديد نحو الأداء، ويواصل المساهمون فيها محاولة انتزاع مزيد من الكفاءة من الخوارزميات المنفذة أصلًا لتقليل زمن تنفيذ دوال numpy أكثر.
ومثل كل مكتبة نتناولها هنا، فإن numpy مفتوحة المصدر بطبيعة الحال، وتُوزَّع برخصة BSD.
scipy
هذه المكتبة مخصصة لدعم الحوسبة العلمية. صدرت عام 2001، فهي أقدم حتى من numpy (2005). وهي مبنية فوق numpy، وتُستخدم ndarray كبنية بيانات أساسية في scipy كلها. وهي تضيف، من بين أمور أخرى، دوالَّ للتحسين والجبر الخطي ومعالجة الإشارات والاستيفاء ودعم المصفوفات المتناثرة. وعمومًا فهي أعلى مستوى من numpy، مما يتيح لها تقديم دوال أكثر تعقيدًا.
تحسين المعاملات الفائقة
Ray-tune
هذا مكوّن من أدوات ray، وهي مجموعة من المكتبات المترابطة لبناء تطبيقات موزّعة مع التركيز على تعلّم الآلة وPython. ويختص جزء Tune من مكتبة تعلّم الآلة بتحسين المعاملات الفائقة، ويوفر مجموعة من خوارزميات البحث مثل البحث الشبكي وhyperband والتحسين البايزي.
يستطيع Ray-tune التعامل مع نماذج مبنية بمعظم لغات البرمجة والمكتبات الموجودة في السوق. وكل مكتبة ذُكرت في قسم بناء النماذج مدعومة في ray-tune.
المفاهيم الأساسية في ray-tune هي:
- Trainables – كائنات تُمرَّر إلى عمليات tune؛ وهي النموذج الذي نريد تحسين معاملاته
- Search space – يضم كل قيم المعاملات الفائقة التي نريد اختبارها في التجربة الحالية
- Tuner – كائن ينفّذ التشغيلات؛ واستدعاء tuner.fit() يبدأ البحث عن أفضل مجموعة من المعاملات الفائقة. وعلى الأقل عليك تمرير كائن trainable ومساحة بحث إليه
- Trial – تمثل كل تجربة تشغيلًا واحدًا لكائن trainable بمجموعة محددة من المعاملات مأخوذة من مساحة البحث. وتنتج التجارب عن Ray Tune Tuner. ولأنها تمثل نتيجة تشغيل الـ tuner، فإن Trial تحمل معلومات كثيرة:
- الإعدادات المستخدمة في تلك التجربة،
- معرّف التجربة،
- أشياء كثيرة أخرى.
- Search algorithms – الخوارزمية المطبقة في تنفيذ معين لـ Tuner.fit. وعند عدم تحديد أي منها، تعتمد Ray Tune افتراضيًا على RadomSearch
- Schedulers – كائنات مسؤولة عن إدارة التشغيلات. تستطيع إيقاف التجارب مؤقتًا أو إيقافها أو بدءها ضمن التشغيل، مما قد يحسّن الكفاءة ويقصّر زمن التشغيل. وإن لم تختر واحدًا، فإن Tune تعتمد افتراضيًا على FIFO – أي يُنفَّذ التشغيل عنصرًا بعد عنصر كما في طابور عادي
- Run Analyses – الكائن الذي يحمل نتيجة تنفيذ Tuner.fit في صورة كائن ResultGrid. ويضم كل البيانات عن التشغيل، مثل أفضل نتيجة بين كل التجارب أو بيانات كل تجربة
BoTorch
هذه المكتبة مبنية فوق PyTorch وهي عضو في النظام البيئي لـ PyTorch. ويقتصر تركيزها على تحسين المعاملات الفائقة باستخدام التحسين البايزي (Bayesian Optimization).
ولأنها المكتبة الوحيدة في هذا القسم المصممة للعمل مع مكتبة نماذج واحدة بعينها، فقد يكون استخدام BoTorch مع أي شيء غير PyTorch مزعجًا. وهي أيضًا الوحيدة التي ما زالت في مرحلة بيتا وتخضع لتطوير مكثف، لذا قد تواجه مشكلات غير متوقعة.
وتتمثل نقطة قوة BoTorch الرئيسية في تكاملها مع PyTorch، مما يجعل العمل بالاثنتين معًا أسهل بكثير.
تتبّع التجارب
Neptune.ai
هذه أداة عبر الويب تعمل بوصفها أداة لتتبّع التجارب وسجلًّا للنماذج في آن واحد. وتعمل في السحابة وفق نموذج SASS التقليدي، وإن كنت مصممًا بما يكفي فيمكنك أيضًا استخدام نسخة مستضافة ذاتيًا.
توفر لوحة لعرض نتائج تدريب نموذجك ومقارنتها. ويمكنك أيضًا استخدامها لحفظ معاملات كل تشغيل. وإضافة إلى ذلك، من السهل إدارة إصدارات مجموعة البيانات المستخدمة في تشغيل معين مع أي بيانات وصفية تراها مفيدة.
كما تجعل التحكم في إصدارات نماذجك أمرًا بسيطًا. وبطبيعة الحال، لا تعتمد الأداة على مكتبة بعينها ويمكنها استضافة نماذج مبنية بأي منها. ولتمكين التكامل، توفر neptune واجهة API على نمط REST مع عميل خاص بها يمكنك تنزيله وتثبيته عبر pip أو أي مدير تبعيات آخر في python. وتوثيق الـ API جيد نسبيًا وسهل الفهم إلى حد كبير.
الأداة مدفوعة، بخطة تسعير واضحة مقسّمة إلى ثلاث فئات. لكن إن كنت تحتاجها لمشروع شخصي فقط أو تنتمي إلى وحدة بحثية أو أكاديمية، فيمكنك التقدم لاستخدامها مجانًا.
Neptune.ai أداة فتية، لذا قد تفتقد بعض الميزات المألوفة من أدوات تتبّع التجارب الأخرى. ومع ذلك، فإن فريق دعم neptune.ai حريص على الاستجابة لملاحظات المستخدمين وإضافة الوظائف الناقصة – على الأقل هذه كانت تجربتنا، إذ نعتمد بشدة على Neptune.ai في أحد مشاريع عملائنا.
Weights&Biases
تُسمى أيضًا WandB أو W&B، وتوفر هذه الأداة عبر الويب كل ما يلزم لتكون أداة تتبّع تجارب وسجلًّا للنماذج. ومجموعة ميزاتها قابلة للمقارنة تقريبًا بميزات neptune.ai.
ومع ذلك، يبدو أن weight and biases تقدم تصويرًا أفضل للبيانات وهي عمومًا أداة أكثر نضجًا من Neptune. كما يبدو أن WandB تركّز أكثر على المشاريع الفردية والباحثين، وتعطي وزنًا أقل للتعاون.
وخطة التسعير فيها بسيطة أيضًا، مقسّمة إلى 3 فئات، من بينها فئة مجانية للاستخدام الخاص. وتعامل W&B الباحثين والوحدات الأكاديمية كما تفعل Neptune – إذ يمكنهم دائمًا استخدام Weights and Biases مجانًا.
وتوفر Weight and Biases أيضًا واجهة API شبيهة بـ REST لتبسيط التكامل. ويبدو أنها موثّقة بشكل أفضل وتقدم ميزات أكثر من تلك الخاصة بـ Neptune.ai. ومن المثير للاهتمام أنها توفر أيضًا مكتبة عميل مكتوبة بلغة Java، في حال كنت، لسبب ما، قد بنيت نموذج تعلّم الآلة بلغة Java بدلًا من Python.
TensorBoard
هذه مجموعة أدوات للتصوير مبنية خصيصًا للنظام البيئي لـ TensorFlow. وهي مخصصة أساسًا لتكون أداة لتتبّع التجارب مع التركيز على تصوير المقاييس. ورغم أنها أداة خاصة بـ TensorFlow، يمكنك استخدامها أيضًا مع Keras (وهذا غير مستغرب) ومع PyTorch.
وهي أيضًا الخيار المجاني الوحيد بين الأدوات الثلاث التي نتناولها في هذا القسم. هنا يمكنك استضافة تجاربك ومتابعتها. غير أن Tensorbord تفتقر إلى ميزات سجل النماذج، وهو ما قد يكون مزعجًا وقد يدفعك إلى استخدام أداة طرف ثالث لسدّ هذه الفجوة. ومع ذلك، فمن المؤكد أن النظام البيئي لـ TensorFlow يحوي أداة لذلك.
وبما أنها جزء مباشر من النظام البيئي لـ TensorFlow، فهي تتكامل مع Keras أو Tensorflow بسلاسة أكبر بكثير من الأداتين السابقتين.
مكتبات مخصصة لمسائل محددة
tsaug
هذه إحدى المكتبات القليلة لتعزيز بيانات السلاسل الزمنية (time series augmentation). وهي مفتوحة المصدر، أنشأها مطوّر واحد ويتولى صيانتها. صدرت عام 2019 وهي حاليًا في الإصدار 0.2.1. وتقدم مجموعة من 9 عمليات تعزيز، منها Crop وAdd noise وTimeWrap. ومقارنةً بمشروع من هذا النوع، فهي موثّقة بشكل معقول وسهلة الاستخدام.
للأسف، ولأسباب لا أعرفها، يبدو أن المكتبة مهجورة ولم تتلقَّ تحديثًا منذ 3 سنوات. وما زالت قضايا كثيرة مفتوحة دون أن ينظر فيها أحد. وأجد هذا مؤسفًا، إذ لا توجد مكتبات أخرى كثيرة تقدم تعزيزًا لبيانات السلاسل الزمنية.
لكن إن كنت تحتاج سلسلة زمنية لتعدين البيانات أو لتعزيزها وتفضّل مكتبة أحدث، فقد تكون Tsfresh خيارًا جيدًا.
Opencv
تركّز هذه المكتبة على دوال معالجة الصور والرؤية الحاسوبية. بُنيت في الأصل على يد Intel، وهي الآن مفتوحة المصدر برخصة Apache 2.
وتوفر OpenCv مجموعة من الدوال لمعالجة الصور والفيديو وتحليل بيانات تصنيف الصور وتتبّع الأجسام، إلى جانب نماذج تعلّم آلة جاهزة للتعامل مع الصور والفيديو.
Geopandas
تهدف هذه المكتبة، المبنية فوق pandas، إلى توفير دوال للتعامل مع البيانات المكانية وبنياتها. وهي تسهّل قراءة البيانات وكتابتها بصيغتي geojson وshapefile، أو قراءة البيانات من أنظمة postgis. وإلى جانب pandas، تعتمد على مكتبات كثيرة أخرى للبيانات المكانية، مثل pygeos وgeopy وshapely.
البنى الأساسية في المكتبة هي:
- GeoSeries – عمود من البيانات الجغرافية المكانية، مثل سلسلة من النقاط أو الخطوط أو المضلعات
- GeoDataFrame – بنية جدولية تضم مجموعة من GeoSeries.
أدوات مساعدة
matplotlib
كما يوحي اسمها، هذه مكتبة لرسم أنواع المخططات كافة ;p. وإلى جانب المخططات البسيطة مثل الخطوط أو المدرّجات التكرارية، تتيح matplotlib بناء مخططات أكثر تعقيدًا – أشكال ثلاثية الأبعاد أو مخططات قطبية. وبطبيعة الحال تتيح أيضًا ضبط عناصر مثل ألوان المخططات أو تسمياتها.
ورغم أنها قديمة نسبيًا (صدرت عام 2003، أي أن عمرها 20 عامًا وقت كتابة هذا المقال)، فإنها ما زالت تُصان وتُطوَّر بنشاط. ومع نحو 17 ألف نجمة على GitHub، لها مجتمع كبير وهي على الأرجح الخيار الثاني لكل من يحتاج أداة لتصوير البيانات.
وتوثيقها جيد وهي سهلة التعلّم نسبيًا للمبتدئين. ويجدر ذكر أن matplotlib تشكّل الأساس لمكتبات التصوير الأعلى مستوى.
seaborn
وبالحديث عن مكتبات تعلّم الآلة من هذا النوع، فإن seaborn مثال عليها. ونتيجة لذلك، فإن الوظائف التي تقدمها seaborn مشابهة لما توفره matplotlib.
غير أن واجهتها البرمجية أعلى مستوى وتحتاج شيفرة نمطية أقل للحصول على نتائج مماثلة. ومن بين فروق صغيرة أخرى، فإن لوحة ألوان seaborn أنعم ومخططاتها تبدو أحدث وأجمل. كما أن seaborn هي الأسهل تكاملًا مع pandas، وقد يكون ذلك ميزة كبيرة.
فيما يلي شيفرة رسم خريطة حرارية في matplotlib وفي seaborn، مع المخططات الناتجة. عمليات الاستيراد مشتركة.
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

data = np.random.rand(5, 5)

fig, ax = plt.subplots()
heatmap = ax.pcolor(data, cmap=plt.cm.Blues)

ax.set_xticks(np.arange(data.shape[0])+0.5, minor=False)
ax.set_yticks(np.arange(data.shape[1])+0.5, minor=False)

ax.set_xticklabels(np.arange(1, data.shape[0]+1), minor=False)
ax.set_yticklabels(np.arange(1, data.shape[1]+1), minor=False)

plt.title("Heatmap")
plt.xlabel("X axis")
plt.ylabel("Y axis")

cbar = plt.colorbar(heatmap)

plt.show()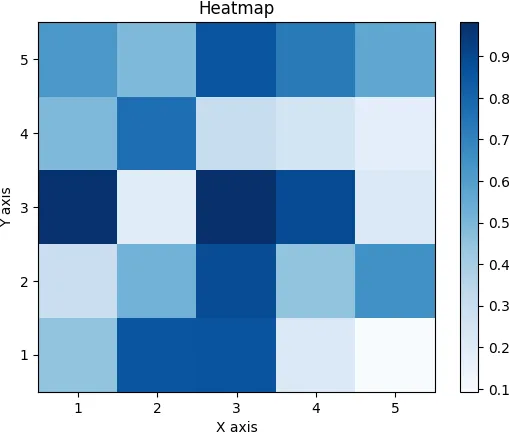
sns.heatmap(data, cmap="Blues", annot=True)
# Set plot title and axis labels
plt.title("Heatmap")
plt.xlabel("X axis")
plt.ylabel("Y axis")
# Show plot
plt.show()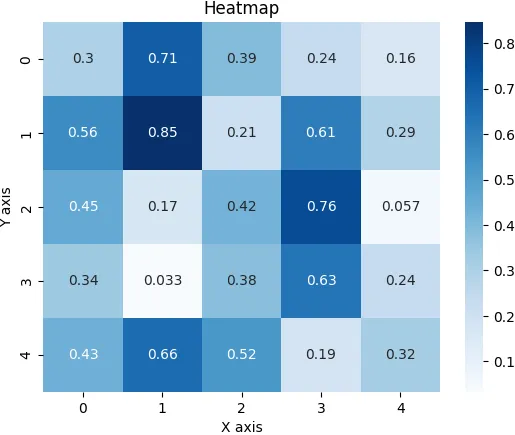
hydra
يصل كل مشروع في النهاية إلى نقطة تحتاج فيها قيمة ما إلى أن تصبح قابلة للضبط. وإذا كنت تعمل مع أداة مثل jupyter فهذا بسيط جدًا: تنقل القيمة المعنية إلى ملف .env – وها قد أصبحت قابلة للضبط.
أما عند بناء تطبيق تقليدي أكثر، فالأمر ليس بهذه السهولة. وهنا تظهر Hydra بوجهها القبيح (لكنه مفيد جدًا). وهي أداة مفتوحة المصدر لإدارة إعدادات التطبيقات المبنية بـ Python وتشغيلها.
وهي مبنية على مكتبة Omega-Conf، وبحسب ما جاء في صفحتها الرئيسية: «ميزتها المركزية هي القدرة على بناء إعدادات هرمية ديناميكيًا عبر التركيب (composition) وتجاوزها عبر ملفات الإعدادات وسطر الأوامر.»
وقد تبيّن أن القدرة المذكورة في هذا الاقتباس – الإعدادات الهرمية – مفيدة جدًا لي. ففي حالتي أدّت الغرض جيدًا وسمحت لي بفصل ملفات الإعدادات بشكل أنظف.
coolname
إعطاء تشغيلات التدريب لديك معرّفًا فريدًا فكرة ذكية دائمًا. وإذا كنت، لسبب ما، لا تحب UUID أو تريد ببساطة أن تكون معرّفاتك مقروءة للبشر، فإن coolname تلبّي حاجتك. فهي تنتج معرّفات فريدة قائمة على الكلمات والحروف الهجائية بطول يتراوح بين 2 و4 كلمات.
وعدد التراكيب تقريبًا كما يلي.
- معرّف بطول 4 كلمات له 1010 تراكيب
- معرّف بطول 3 كلمات له 108 تراكيب
- معرّف بطول كلمتين له 105 تراكيب
وهذا أقل بكثير مما في UUID، أي أن احتمال التصادم أعلى. لكن المقارنة بين الاثنين ليست موضوع هذا النص.
اختار المنشئون المفردات يدويًا ويصفونها بأنها إيجابية ومحايدة (يصف ملف README الخاص بالمشروع قوائم الكلمات بمزيد من التفصيل)، لذا لن تحصل أبدًا على معرّف مثل you-ugly-unwise-human-being. وبطبيعة الحال، المكتبة مفتوحة المصدر بالكامل.
tqdm
تضيف هذه المكتبة وظيفة أشرطة التقدم إلى تطبيقك. قد لا يكون عرض هذا النوع من المعلومات أهم ما تحتاجه، لكنه يظل ممتعًا للمشاهدة ويتيح لك متابعة تقدم تطبيقك أثناء تنفيذه مهمة مهمة.
كما تعتمد Tqdm على خوارزميات متطورة لتقدير الوقت المتبقي للمهمة، وقد يشكّل ذلك نقلة نوعية ويساعدك على تخطيط وقتك. وتزعم Tqdm أيضًا أن كلفة أدائها بالكاد تُلاحَظ – في حدود النانو ثانية.
وفوق ذلك، فهي مستقلة تمامًا ولا تحتاج إلا إلى python لتعمل، فلن تجرّ نصف الإنترنت إلى قرصك.
jupyter-notebook (+JupyterLab)
الدفاتر (Notebooks) وسيلة ممتازة لمشاركة النتائج والتعاون في مشروع. وبفضل فكرة الخلايا، من السهل فصل أجزاء الشيفرة ومسؤولياتها المختلفة.
كما أن قدرة ملف دفتر واحد على احتواء الشيفرة والصور والمخرجات النصية الغنية (الجداول) جنبًا إلى جنب تضيف إلى نقاط قوته القائمة.
وتتيح الدفاتر أيضًا تشغيل pip install مباشرة في الخلايا واستخدام ملفات .env للإعدادات. وهذا يزيل عن كاهلك قدرًا كبيرًا من التعقيد الهندسي البرمجي.
الخلاصة
بهذا نختم عرض مكتبات تعلّم الآلة المختلفة التي أردت تقديمها لك. كان هدفي تقديم نظرة عامة واسعة عن كل مكتبة وحالات استخدامها المحتملة، مدعومة بملاحظات موجزة من تجربتي الشخصية في العمل بها. آمل أنني نجحت في ذلك، وأن هذا المقال وسّع فهمك لمشهد مكتبات تعلّم الآلة.
شكرًا لوقتك.