Երբ Project Loom-ը հանդիպում է Quarkus-ին
Տեսեք, թե ինչպես են Project Loom-ը և Quarkus-ը աշխատում միասին և ինչպես գործարկել Postgres-ով Quarkus հավելված վիրտուալ թելերի (virtual threads) վրա։ Ներառված են նաև այս հավելվածի բեռնվածքային թեստերի արդյունքները։
Java 19-ը Project Loom-ը ներկայացրեց որպես Preview հնարավորություն։
Loom-ի նպատակը հետևյալն է.
“(..) to drastically reduce the effort of writing, maintaining, and observing high-throughput concurrent applications that make the best use of available hardware”Ron Pressler, May 2020
Դեռ երկար կպահանջվի, մինչև Loom-ը դուրս գա Preview փուլից և դառնա լիարժեք թողարկում։ Սակայն քանի որ այն արդեն կարելի է օգտագործել, Quarkus-ի թիմը որոշեց փորձարկել այն Version 2.10.0 Final-ում։ Վիրտուալ թելերի շուրջ նրանց վաղ աշխատանքը թույլ է տալիս փորձել Loom-ը ավելի բարդ օրինակների վրա։
Այս հոդվածում ներկայացնում ենք Project Loom-ը և Quarkus-ը և բացատրում, թե ինչպես գործարկել Postgres-ով Quarkus հավելված վիրտուալ թելերի վրա։ Նաև կիսվում ենք այդ հավելվածի վրա կատարված բեռնվածքային թեստերի արդյունքներով։
Ինչու Project Loom
Java-ում զուգահեռ և համաժամանակյա հաշվարկները ավանդաբար իրականացվել են թելերի (threads) միջոցով։
Java-ի թելերի հիմքում գործառնական համակարգի թելերն են։ VM-ում ստեղծված յուրաքանչյուր թել ունի իր սեփական համակարգային թելը, որը կատարում է Thread.run() մեթոդը։ Հետևաբար թելերի աշխատանքը ապահովում է ՕՀ-ն։
Ինչ էլ լինի, յուրաքանչյուր թել զբաղեցնում է հիշողություն և պահանջում պրոցեսորի ժամանակ։ Երբ ՕՀ-ն բազմախնդրություն է իրականացնում բազմակորիզ պրոցեսորի վրա, բոլոր թելերը պետք է պայքարեն սարքավորման ռեսուրսների հասանելիության համար։ Ուստի բազմախնդրությունը արդյունավետ օգտագործելը պահանջում է մի շարք խնդիրների լուծում՝ թելերի արգելափակում, թելերի պլանավորում և դրանց միջև համաժամեցում։
Թելերը Java-ի մաս են եղել առաջին օրվանից։ Տարիների ընթացքում դրանք շարունակաբար զարգացել և հարմարվել են նոր սարքավորումների հնարավորություններին։ Սկզբում դրանք Green Threads էին, շուտով լռելյայն դարձան պլատֆորմային թելեր (platform threads), իսկ հետո ընդլայնվեցին Java 1.5-ում ավելացված Concurrency API-ով։ Այդ ժամանակից ի վեր Java-ի թելային մոդելը՝ Future, ExecutorService, ForkJoinPool, Concurrent_ maps և շատ ուրիշ գործիքներով, հասունացել է։
Այդուհանդերձ, ժամանակի ընթացքում IT աշխարհը պահանջում է գնալով ավելի շատ հաշվողական հզորություն։ Բարձր թողունակությունը այն չափանիշն է, որով գնահատվում են շատ ծրագրային համակարգեր։ Դա պահանջում է ռեսուրսների հնարավորինս արդյունավետ օգտագործում՝ հնարավորինս քիչ ժամանակում։
Աճող բեռին դիմակայող ցանկացած սերվերի համար հարցը հանգում է նուրբ հավասարակշռության՝ քանի թել է մրցում ռեսուրսների համար և որքան արագ է սերվերը պատասխանում։
Քիչ թելերով փուլը (pool) կարող է խեղդվել հարցումների երկար հերթից։ Իսկ չափից շատ պարապուրդ կանգնած թելերով փուլը, ընդհակառակը, զբաղեցնում է ՕՀ-ի թելային ռեսուրսներ, որոնք կարող էին պետք լինել այլ պրոցեսներին։
“Java Concurrency in Practice” գրքում Brian Goetz-ը թելերի փուլի չափը որոշելու համար առաջարկում է հետևյալ բանաձևը.
Number of threads = Number of CPUs * Target CPU utilization * (1 + Wait time / Compute time)Սակայն սա խնդիրը չի վերացնում։ Այն պարզապես թույլ է տալիս չափել՝ գուշակելու փոխարեն։
JVM-ում նոր թելեր ստեղծելը բավականին թանկ է։ Այն ներառում է java stack-ի և համակարգային stack-ի ստեղծում, համակարգային կանչեր և callback-ներ։ Դա ավելի թանկ է, քան «սովորական» օբյեկտների ստեղծումը, հատկապես այն սերվերի համար, որը պետք է սպասարկի բազմաթիվ կարճատև հարցումներ և յուրաքանչյուրի համար կստեղծեր նոր թել։ Մշակման միջավայրում սա կարևոր չէ, բայց բարձր թողունակությամբ արտադրական միջավայրում այն կրիտիկական է։
Ինչու՞ պետք է ուշադրություն դարձնել Loom-ին
Project Loom-ը փորձում է այս խնդիրները նվազեցնել կամ վերացնել վիրտուալ թելերի միջոցով։
Գաղափարը Java թել է, որը կապված չէ պլատֆորմային թելի հետ։ Այսպիսի վիրտուալ թելը ՕՀ-ի ռեսուրսներ կամ պրոցեսորի ժամանակ չի օգտագործում, մինչև իրոք անհրաժեշտ չդառնա, ուստի պլատֆորմային թելը մնում է հասանելի այլ աշխատանքի համար։ Սակայն երկար աշխատող, պրոցեսորը ծանրաբեռնող թելը կամրացվի (pin) պլատֆորմային թելին և կդառնա խոչընդոտ։ Դա այն պատճառով է, որ վիրտուալ թելերը սովորական թելերից արագ չեն. նրանք բարելավում են այն, թե ինչպես են օգտագործվում պլատֆորմային թելերը։
Վիրտուալ թելերը լուծում են բարձր թողունակության կարիքներ, որոնց սովորական թելերը չեն կարողանում բավարարել պրոցեսորի կորիզների սահմանափակ քանակի պատճառով։ Հաշվարկի արագացումը կամ ցածր հապաղումը (latency) այն չէ, ինչի համար դրանք ստեղծվել են։
Java-ի պլատֆորմային թելերը պլանավորվում են գործառնական համակարգի կողմից, իսկ վիրտուալ թելերը՝ JDK-ի կողմից։ JDK-ի պլանավորիչը վիրտուալ թելերը համապատասխանեցնում է պլատֆորմային թելերին «շատերը շատերի հետ» սկզբունքով, ինչպես ցույց է տրված ստորև նկարում։
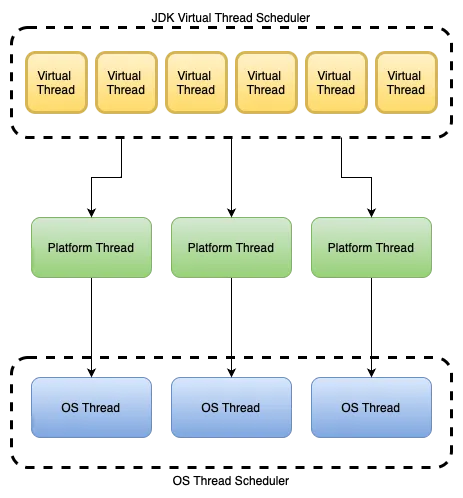
Հաջորդ բաժիններում ցույց ենք տալիս վիրտուալ թելերը գործողության մեջ՝ կառուցելով Quarkus հավելված և բեռնվածքային թեստեր անցկացնելով տարբեր կոնֆիգուրացիաներով։
Quarkus և վիրտուալ թելեր
Quarkus-ը Java ստեկ է, որը ստեղծվել է հիմնականում ամպային տեղակայման համար։ Այն գովազդում է արագ մեկնարկ և փոքր հիշողության ծավալ։ Այն լավ համագործակցում է Kubernetes-ի հետ և թույլ է տալիս հավելվածներին աշխատել ինչպես OpenJDK HotSpot-ի, այնպես էլ GraalVM-ի վրա։ Quarkus-ը առաջարկում է և իմպերատիվ, և ռեակտիվ ծրագրավորում, ընդ որում առաջինն իրականացվում է բնիկ կերպով Netty-ի և Mutiny-ի միջոցով։
Նախապայմաններ
Օրինակային հավելվածը հիմնվում է հետևյալ գործիքների վրա, որոնք պետք է տեղադրեք նախքան շարունակելը.
- Java OpenJDK HotSpot 19
- Docker
- Quarkus
- siege – ռեգրեսիոն թեստավորման և բենչմարկինգի ծրագիր
Օրինակային հավելվածի ստեղծում
Սկսեք Quarkus հավելվածի ստեղծումից
quarkus create app loom-quarkusԿախվածություններ
Maven-ի կախվածություններին պետք է ավելացնել մի քանի լրացուցիչ գրադարան։
quarkus-agroal, quarkus-jdbc-postgresql, quarkus-reactive-pg-client տվյալների աղբյուրի գրադարաններ են, որոնք համապատասխանաբար զբաղվում են արգելափակող և ոչ արգելափակող կապերով։
quarkus-resteasy-reactive-jackson-ը հնարավորություն է տալիս ստեղծել REST ծառայություններ, որոնք վերադարձնում են JSON։
<dependency>
    <groupId>io.quarkus</groupId>
    <artifactId>quarkus-agroal</artifactId>
</dependency>
<dependency>
<groupId>io.quarkus</groupId>
<artifactId>quarkus-reactive-pg-client</artifactId>
</dependency>
<dependency>
<groupId>io.quarkus</groupId>
<artifactId>quarkus-jdbc-postgresql</artifactId>
</dependency>
<dependency>
<groupId>io.quarkus</groupId>
<artifactId>quarkus-resteasy-reactive-jackson</artifactId>
</dependency>Վիրտուալ թելերի միացում
Java19-ի հետ առաքվող վիրտուալ թելերը լռելյայն անջատված են, ուստի Java-ին պետք է հստակ ասել, որ միացնի դրանք։ Դա կարելի է անել Maven-ի կոնֆիգուրացիոն ֆայլում –enable-preview պարամետրով։ Բացի այդ, թողարկման տարբերակը դրեք 19։
<plugin>
    <artifactId>maven-compiler-plugin</artifactId>
    <version>${compiler-plugin.version}</version>
    <configuration>
        <compilerArgs>
            <arg>--enable-preview</arg>
        </compilerArgs>
        <release>19</release>
    </configuration>
</plugin>
Տվյալների աղբյուրի կոնֆիգուրացիա
Quarkus-ը տրամադրում է Dev Services, որոնք հեշտացնում են մշակումը։ Ի թիվս այլ բաների, դրանք կարող են ավտոմատ կերպով ստեղծել և կարգավորել Postgresql տվյալների բազա։ Այդ դեպքում Quarkus-ը զբաղվում է տվյալների աղբյուրի կոնֆիգուրացիայով թե՛ արգելափակող, թե՛ ոչ արգելափակող հասանելիության համար, ինչը լիովին բավարար է այս օրինակային հավելվածի համար։
Միացրեք տվյալների բազայի dev services-ը application.properties-ում.
quarkus.datasource.devservices.enabled=trueREST ծառայություն
Այս ծառայությունը ցույց է տալիս, թե ինչպես են օգտագործվում վիրտուալ թելերը։ Quarkus-ը ծառայություններն իրականացնում է ռեակտիվ եղանակով լռելյայն, ուստի ծառայությունը պահանջում է մանրակրկիտ կարգավորում՝ հիմնված @Blocking, @NonBlocking և @UseVirtualThreads անոտացիաների վրա։
@Path("/sandbox")
@Produces(MediaType.APPLICATION_JSON)
@NoCache()
@Blocking
public class LoomSandboxResource {

    BlogpostsRepository repository;

    @Inject
    public LoomSandboxResource(BlogpostsRepository repository) {
        this.repository = repository;
    }

    @GET
    @Path("/blocking/jdbc")
    public List<Blogpost> blogPostsBlockingJDBC() {
        return repository.findAllJdbc();
    }

    @GET
    @RunOnVirtualThread
    @Path("/loom/jdbc")
    public List<Blogpost> blogPostsLoomJdbc() {
        return repository.findAllJdbc();
    }
}
Տվյալների պահոց
Հավելվածն օգտագործում է ընդամենը մեկ պահոց (repository)։ Սակայն այդ պահոցը աշխատում է և՛ արգելափակող AgroalDataSource, և՛ ոչ արգելափակող PgPool տվյալների աղբյուրների հետ։
@ApplicationScoped
public class BlogpostsRepository {
    final PgPool client; //This is nonblocking postgres driver
    final AgroalDataSource agroalDataSource; //This is standard blocking postgres driver
    private final String SELECT_ALL = "SELECT * FROM blogposts";

    @Inject
    public BlogpostsRepository(final PgPool client, final AgroalDataSource agroalDataSource) {
        this.client = client;
        this.agroalDataSource = agroalDataSource;
    }

    public List<Blogpost> findAllJdbc() {
        var quotesList = new ArrayList<Blogpost>();
        try (Connection connection = agroalDataSource.getConnection();
            PreparedStatement preparedStatement = connection.prepareStatement(SELECT_ALL);
            ResultSet resultSet = preparedStatement.executeQuery();) {
            while (resultSet.next()) {
                quotesList.add(BlogpostMapper.toBlogpost(resultSet));
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        return quotesList;
    }

    public Uni<List<Blogpost>> findAllReactiveUni() {
        return client.query(SELECT_ALL)
                .execute()
                .onItem().transform(BlogpostMapper::toBlogpost);
    }

    public Multi<Blogpost> findAllReactiveMulti() {
        return client.query(SELECT_ALL)
                .execute()
                .onItem().transformToMulti(set -> Multi.createFrom().iterable(set))
                .onItem().transform(BlogpostMapper::toBlogpost);
    }
}
Հավելվածի գործարկում
Հավելվածը գործարկելու ամենահեշտ ձևը Quarkus cli-ն է
%>quarkus devԴուք պետք է տեսնեք մոտավորապես հետևյալ արդյունքը.
Այս պահին հավելվածը պետք է աշխատի և միացած լինի Docker-ի ներսում գտնվող Postgresql տվյալների բազային։
Օրինակային տվյալների ներմուծում
Այժմ կբեռնենք որոշ օրինակային տվյալներ, որպեսզի կարողանանք մի քանի թեստ կատարել և համոզվել, որ հավելվածը միանում է տվյալների բազային։
Պատճենեք օրինակային տվյալների ֆայլը main/resources/ թղթապանակ։
Հետո ստեղծում ենք InitDb դասը, որի խնդիրն է կարդալ տվյալները main/resources/sample-data.json-ից և բեռնել դրանք տվյալների բազա։
Դասը հավելվածի յուրաքանչյուր մեկնարկի ժամանակ վերստեղծում է բազայի սխեման, որպեսզի յուրաքանչյուր թեստ կատարվի ճիշտ նույն տվյալների հավաքածուի վրա։
@ApplicationScoped
public class InitDb {
    boolean schemaCreate;
    final PgPool client;

    @Inject
    public InitDb(@ConfigProperty(name = "blogposts.schema.create", defaultValue = "true") boolean schemaCreate,
                PgPool client) {
        this.schemaCreate = schemaCreate;
        this.client = client;
    }

    void config(@Observes StartupEvent ev) {
        if (schemaCreate) {
            run();
        }
    }

    private void run() {
        List<Tuple> batch = prepareData();
        client.query("DROP TABLE IF EXISTS blogposts").execute()
                .flatMap(r -> client.query("CREATE TABLE blogposts (id SERIAL PRIMARY KEY, author VARCHAR(256) NOT NULL, content TEXT NOT NULL , tags VARCHAR(256))").execute())
                .await().indefinitely();
        client.preparedQuery("INSERT INTO blogposts (author, content, tags) VALUES ($1, $2, $3)")
                .executeBatch(batch)
                .await().indefinitely();

    }

    private List<Tuple> prepareData() {
        try {
            InputStream in = getClass().getResourceAsStream("/sample-data.json");
            String result = new BufferedReader(new InputStreamReader(in))
                    .lines().collect(Collectors.joining("\n"));

            ObjectMapper mapper = new ObjectMapper();
            TypeReference<List<Blogpost>> documentMapType =
                    new TypeReference<>() {
                    };

            var document = mapper.readValue(result, documentMapType);

            return document.stream().map(i -> Tuple.of(i.author(), i.content(), i.tags())).toList();

        } catch (IOException e) {
            throw new RuntimeException(e);
        }
    }
}
Վերագործարկումից հետո հավելվածը պետք է պարունակի օրինակային տվյալները։ Դա կարող եք ստուգել՝ կանչելով նրա url-ներից մեկը՝ http://localhost:8080/sandbox/blocking/jdbc ։
Թեստավորում
Թեստերի նպատակն էր ստուգել, թե ինչպես է հավելվածն օգտագործում պրոցեսորը, հիշողությունը և թելերը բեռի տակ, և արդյոք պլատֆորմային ու վիրտուալ թելերը տարբեր կերպ են վարվում։
Թեստային միջավայր.
- Պրոցեսորի կորիզներ/թելեր – 10/10
- 64 GB RAM
- Postgresql Docker-ում
- Quarkus հավելված dev ռեժիմում Java OpenSDK Hot Spot 19-ի վրա
Թեստավորման գործիք է ծառայել Siege-ը։ Դա պարզ հրամանային տողի ծրագիր է, որի հստակ ամփոփագիրը բավական է այս թեստերի կարիքների համար։
Յուրաքանչյուր թեստ ուղարկում է 1000 հարցում՝ յուրաքանչյուրից առաջ սպասելով 1 վրկ։
Յուրաքանչյուր պատասխան պարունակում է մոտավորապես 1,2MiB JSON տվյալներ։
Թելերի փուլի սահման՝ 10
Այստեղ թե՛ թելերի փուլի սահմանը, թե՛ vertx worker pool-ի չափը սահմանվել էր 10 թել։
Տվյալների բազայի կապերի նվազագույն և առավելագույն քանակները նույնպես կարգավորվել էին՝ տվյալների կորուստը հնարավորինս ցածր պահելու համար։
quarkus.vertx.worker-pool-size=10
quarkus.thread-pool.max-threads=10
quarkus.datasource.jdbc.min-size = 60
quarkus.datasource.jdbc.max-size = 90
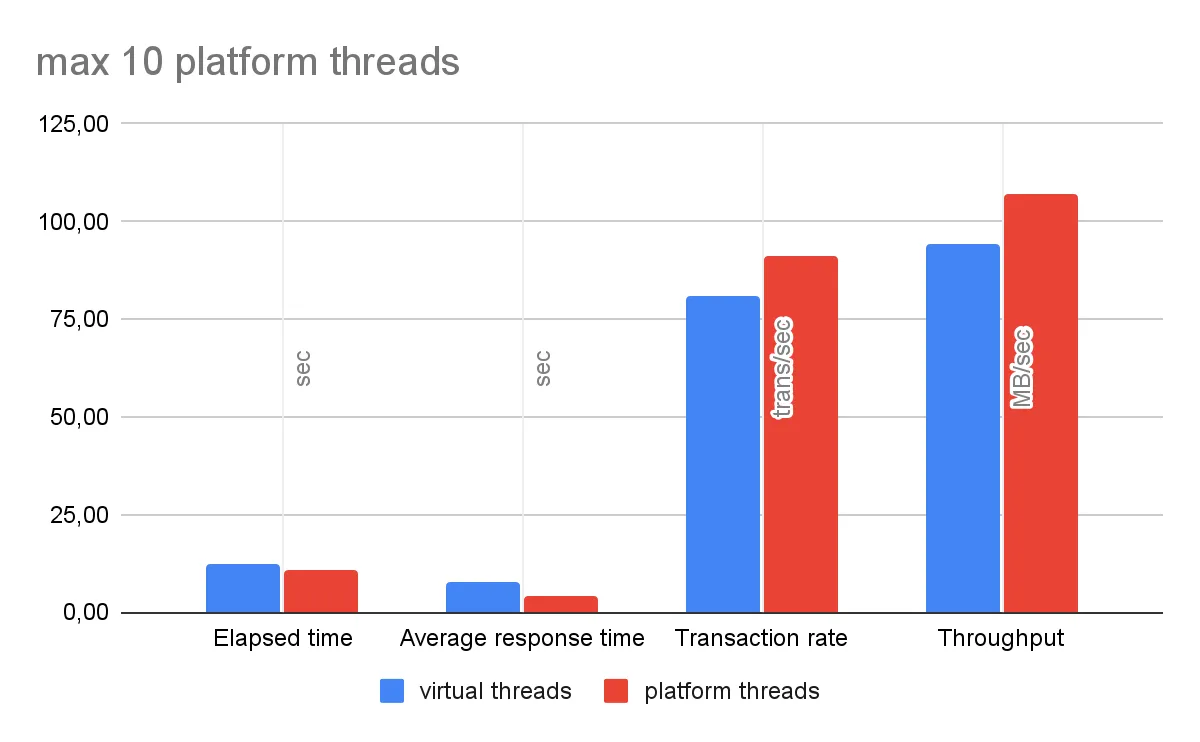
Siege թեստի արդյունքներ
| վիրտուալ թելեր | պլատֆորմային թելեր | ||
|---|---|---|---|
| Անցած ժամանակ | 12,38 | 10,94 | վրկ |
| Միջին պատասխանի ժամանակ | 7,56 | 4,11 | վրկ |
| Տրանզակցիաների արագություն | 80,78 | 91,41 | տրանզ/վրկ |
| Թողունակություն | 94,47 | 106,91 | MB/վրկ |
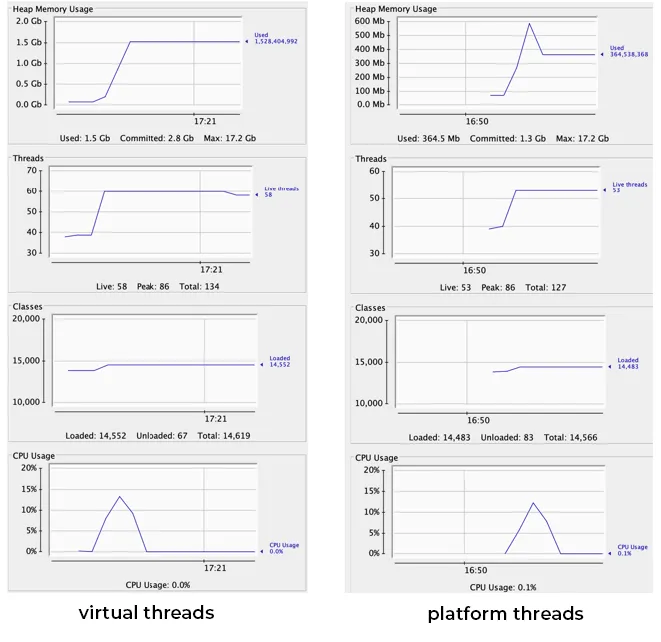
Հիշողության և պրոցեսորի օգտագործում
Թելերի փուլի սահման՝ 100
Այստեղ թե՛ թելերի փուլի սահմանը, թե՛ vertx worker pool-ի չափը սահմանվել էր 100 թել։
Կրկին տվյալների բազայի կապերի նվազագույն և առավելագույն քանակները կարգավորվել էին՝ տվյալների կորուստը հնարավորինս ցածր պահելու համար։
quarkus.vertx.worker-pool-size=100
quarkus.thread-pool.max-threads=100
quarkus.datasource.jdbc.min-size = 60
quarkus.datasource.jdbc.max-size = 90
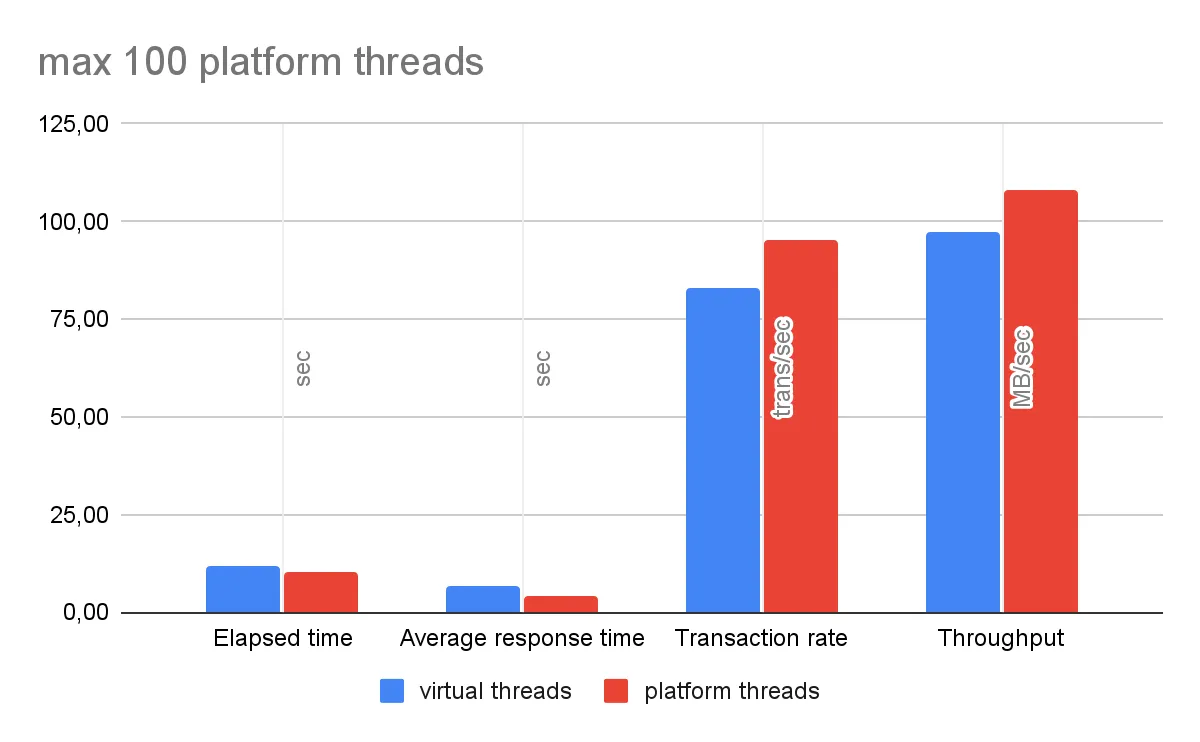
Siege թեստի արդյունքներ
| վիրտուալ թելեր | պլատֆորմային թելեր | ||
|---|---|---|---|
| Անցած ժամանակ | 12,02 | 10,50 | վրկ |
| Միջին պատասխանի ժամանակ | 6,89 | 4,07 | վրկ |
| Տրանզակցիաների արագություն | 83,19 | 95,24 | տրանզ/վրկ |
| Թողունակություն | 97,30 | 108,27 | MB/վրկ |
Հիշողության և պրոցեսորի օգտագործում
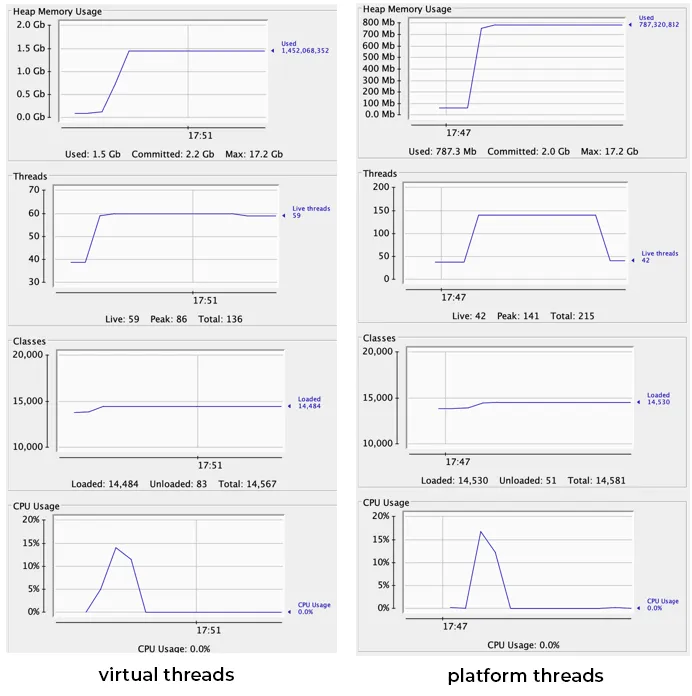
Թելերի փուլի սահման՝ 300
Այստեղ թե՛ թելերի փուլի սահմանը, թե՛ vertx worker pool-ի չափը սահմանվել էր 300 թել։
Siege թեստի արդյունքներ
| վիրտուալ թելեր | պլատֆորմային թելեր | ||
|---|---|---|---|
| Անցած ժամանակ | 12,07 | 10,23 | վրկ |
| Միջին պատասխանի ժամանակ | 6,99 | 3,92 | վրկ |
| Տրանզակցիաների արագություն | 82,85 | 97,75 | տրանզ/վրկ |
| Թողունակություն | 96,90 | 114,33 | MB/վրկ |
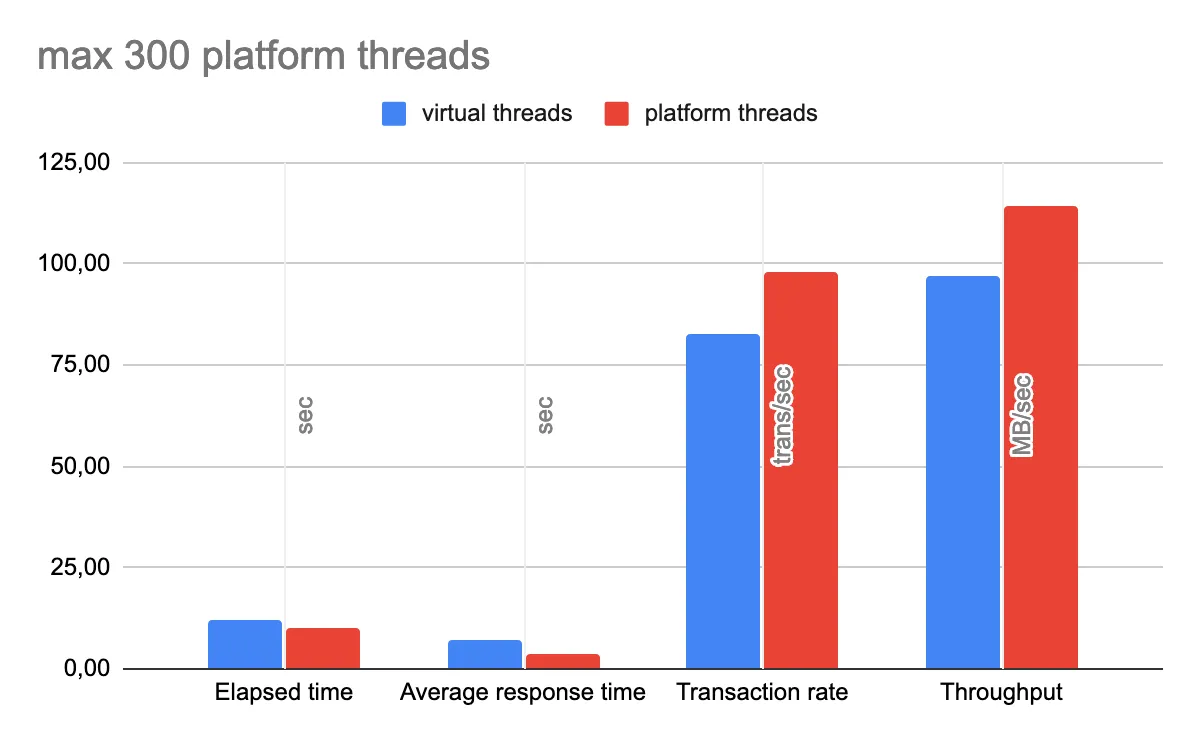
Հիշողության և պրոցեսորի օգտագործում
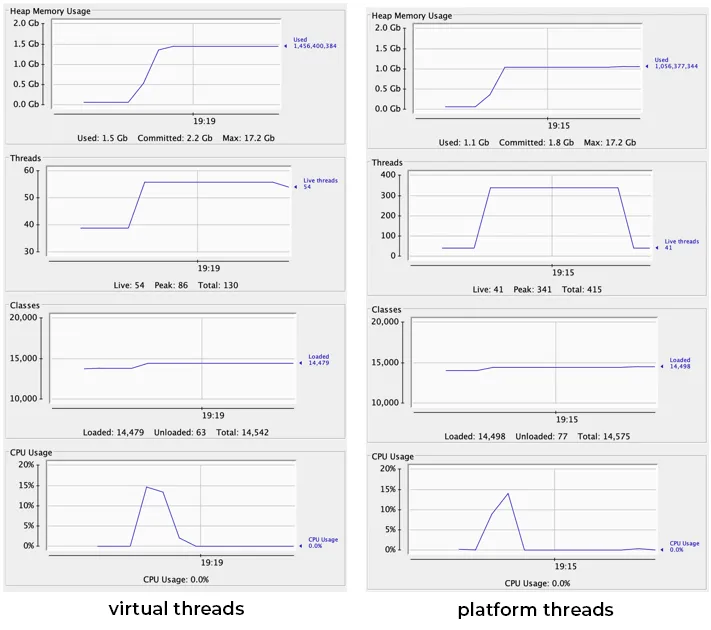
Թելերի փուլի սահման՝ 10 և երկար աշխատող առաջադրանք
Այս թեստում դիտարկում ենք, թե ինչպես են վիրտուալ թելերը վարվում երկար աշխատող առաջադրանքների հետ՝ պլատֆորմային թելերի համեմատ։ Նման առաջադրանքը մոդելավորելու համար սկզբնական BlogpostsRepository-ն պետք է փոփոխվի Thread.sleep()-ով։ Արդյունքում յուրաքանչյուր հարցում պահվում է 2 վայրկյան, մինչև արժեքը վերադարձվի։
public List<Blogpost> findAllJdbc() {
        var quotesList = new ArrayList<Blogpost>();
        try (Connection connection = agroalDataSource.getConnection();
            PreparedStatement preparedStatement = connection.prepareStatement(SELECT_ALL);
            ResultSet resultSet = preparedStatement.executeQuery();) {
            while (resultSet.next()) {
                quotesList.add(BlogpostMapper.toBlogpost(resultSet));
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        try {
            Thread.sleep(2000);
        } catch (InterruptedException e) {
            throw new RuntimeException(e);
        }
        return quotesList;
    }
Siege թեստի արդյունքներ
| վիրտուալ թելեր | պլատֆորմային թելեր | ||
|---|---|---|---|
| Անցած ժամանակ | 13,34 | 213,81 | վրկ |
| Միջին պատասխանի ժամանակ | 8,15 | 106,56 | վրկ |
| Տրանզակցիաների արագություն | 74,96 | 4,68 | տրանզ/վրկ |
| Թողունակություն | 87,68 | 5,47 | MB/վրկ |
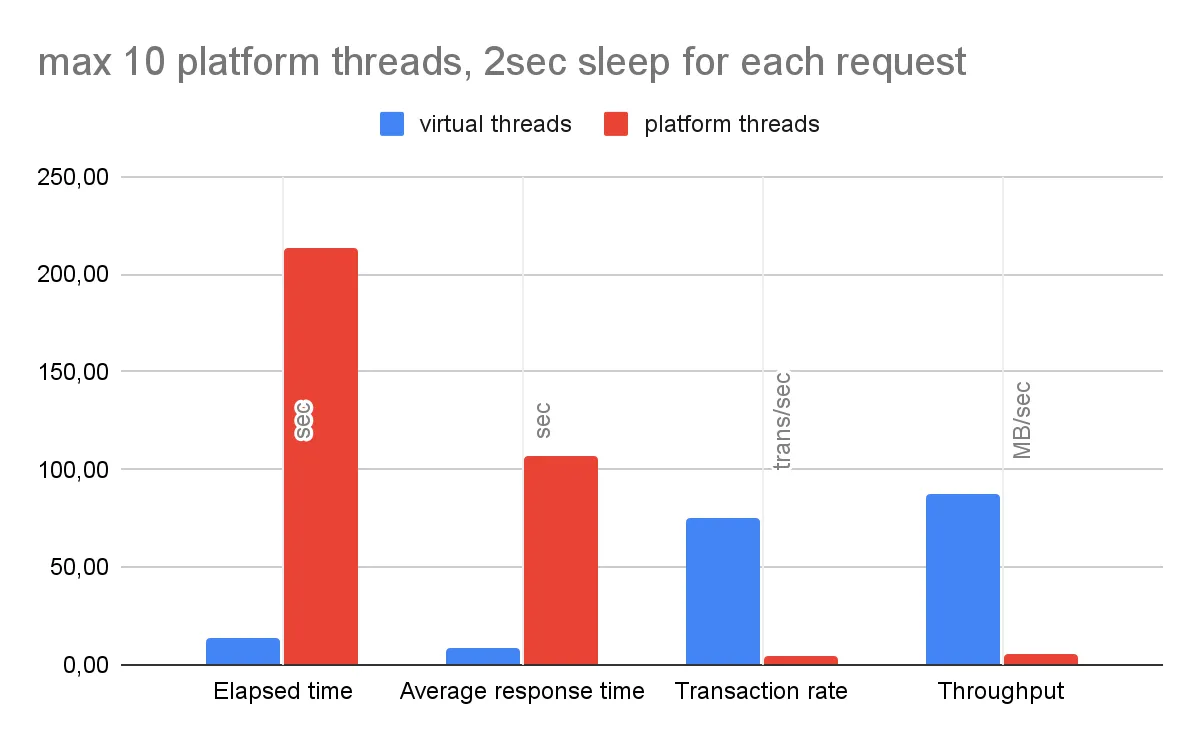
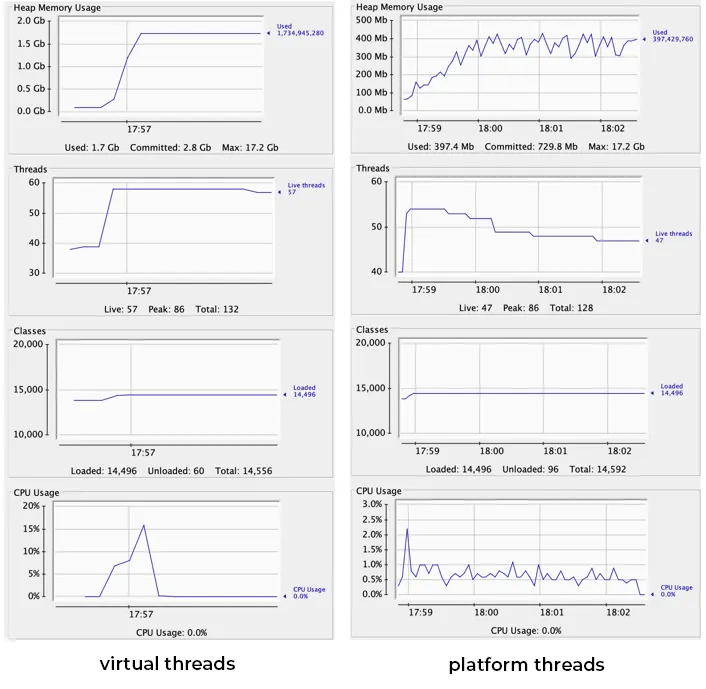
Հիշողության և պրոցեսորի օգտագործում
Ամփոփում
Արդյունքների առաջին հայացքից թվում է, թե վիրտուալ թելերը աշխատում են մոտավորապես նույնքան, որքան պլատֆորմային թելերը։ Սակայն առաջին երկու թեստերը ցույց են տալիս, որ թելերի փուլի մեծացմանը զուգընթաց պլատֆորմային թելերը ավելի լավ են աշխատում, մինչդեռ վիրտուալ թելերը մնում են գրեթե նույն մակարդակի վրա։ 300 չափի փուլով թեստը կշեռքի նժարը էլ ավելի թեքում է պլատֆորմային թելերի կողմը։ Ապա ինչու՞ մտահոգվել վիրտուալ թելերով, եթե դրանք ավելի դանդաղ են և ի լրումն օգտագործում են պլատֆորմային թելերից երկու անգամ ավելի շատ heap հիշողություն։
Վերջին թեստը բացահայտում է, թե ինչի են իրոք ընդունակ վիրտուալ թելերը։ Արդյունքներին ավելի ուշադիր նայելով՝ տեսնում ենք, որ 10 թելանոց փուլի դեպքում պլատֆորմային թելերը դժվարանում են սպասարկել բոլոր երկար աշխատող հարցումները. նրանց պահանջվեց ավելի քան 200 վայրկյան ավարտելու համար։ Վիրտուալ թելերը, ընդհակառակը, չափազանց արագ են և ավարտում են 13 վայրկյանից։
Սա վիրտուալ թելերի ոչ արգելափակող բնույթի շնորհիվ է։ Դրանք չեն կապվում պլատֆորմային թելին, եթե դա անհրաժեշտ չէ, ուստի պլատֆորմային թելը ազատ է մնում այլ հարցումներ սպասարկելու համար, ինչը ապահովում է բարձր թողունակություն։
Սա շատ խրախուսող է թվում, բայց պետք է հիշել, որ Loom-ը դեռ իր սաղմնային փուլում է, և մենք դեռ չենք բացահայտել նրա բոլոր թակարդները։
Իմ կարծիքով՝ ծրագրավորողները Loom-ը ուղղակիորեն չեն օգտագործի իրենց առօրյա աշխատանքում։ Ավելի կարևոր է այն պահը, երբ գրադարանների և ֆրեյմվորքների մեծ էկոհամակարգը կավելացնի Loom-ի աջակցություն։
Մյուս կողմից, դա կարող է նաև ծնունդ տալ նոր նախագծերի, որոնք սկզբից նախագծված են Loom-ի համար, և մենք կարող ենք տեսնել օգտագործվող գրադարանների փոփոխություն՝ առնվազն միկրոսերվիսներում, որտեղ բարձր թողունակությունը էական է։