عندما يلتقي Project Loom بـ Quarkus
تعرّف على سلوك Project Loom وQuarkus معًا وكيفية تشغيل تطبيق Quarkus مدعوم بـ Postgres على الخيوط الافتراضية. ونتائج اختبارات الحمل لهذا التطبيق مرفقة أيضًا!
Java 19 أطلقت Project Loom كميزة تجريبية (Preview).
يضع Loom لنفسه الهدف التالي:
“(..) to drastically reduce the effort of writing, maintaining, and observing high-throughput concurrent applications that make the best use of available hardware”Ron Pressler, May 2020
سيمضي وقت قبل أن يخرج Loom من مرحلة Preview ويصبح إصدارًا كاملًا. ولأنه صار قابلًا للاستخدام منذ الآن، قرر فريق Quarkus تجربته في الإصدار 2.10.0 Final. وعملهم المبكر على الخيوط الافتراضية يتيح لنا تجربة Loom على أمثلة أكثر تعقيدًا.
في هذه المقالة نعرّف بـ Project Loom وQuarkus ونشرح كيفية تشغيل تطبيق Quarkus مع Postgres فوق الخيوط الافتراضية. كما نشارك نتائج اختبارات الحمل التي أُجريت على ذلك التطبيق.
لماذا Project Loom
في Java، جرت العادة على معالجة الحسابات المتوازية والمتزامنة بالخيوط (threads).
تعتمد الخيوط في Java في جوهرها على خيوط نظام التشغيل. فكل خيط يُنشأ في الآلة الافتراضية يسنده خيط نظام خاص به، ينفّذ الدالة Thread.run(). ونتيجة لذلك، فإن تشغيل الخيوط مهمة نظام التشغيل.
مهما حدث، يستهلك كل خيط ذاكرة ويطلب وقتًا من المعالج. وعندما ينفّذ نظام التشغيل مهام متعددة على معالج متعدد الأنوية، تتنافس جميع الخيوط على الوصول إلى موارد العتاد. لذلك يتطلب استخدام تعدد المهام بكفاءة حل عدد من المشكلات – منها قفل الخيوط وجدولتها والمزامنة بينها.
الخيوط جزء من Java منذ اليوم الأول. وعلى مر السنين ظلت تتطور وتتكيف مع ما يقدمه العتاد الجديد. بدأت كخيوط خضراء (Green Threads)، ثم صارت قريبًا خيوط منصة افتراضيًا، ثم وُسّعت بواجهة Concurrency API التي أُضيفت في Java 1.5. ومنذ ذلك الحين نضجت خيوط Java – مع Future وExecutorService وForkJoinPool وConcurrent_ maps وغيرها الكثير.
ومع ذلك، ومع مرور الوقت، يطلب عالم تقنية المعلومات المزيد والمزيد من القدرة الحاسوبية. فالإنتاجية العالية هي المعيار الذي تُقاس به أنظمة برمجية كثيرة. وهذا يتطلب استخدام الموارد بأعلى كفاءة ممكنة وفي أقصر وقت ممكن.
أما بالنسبة لأي خادم يجب أن يتحمل حملًا متزايدًا، فالأمر يرجع إلى توازن دقيق بين عدد الخيوط المتنافسة على الموارد وسرعة استجابة الخادم.
قد يغرق مجمّع (pool) صغير الخيوط في طابور طويل من الطلبات. وعلى الجانب الآخر، فإن مجمّعًا فيه خيوط خاملة كثيرة جدًا يحتجز موارد خيوط نظام التشغيل التي قد تحتاجها عمليات أخرى.
في كتابه “Java Concurrency in Practice” يقترح Brian Goetz الصيغة التالية لتحديد حجم مجمّع الخيوط:
Number of threads = Number of CPUs * Target CPU utilization * (1 + Wait time / Compute time)لكن هذا لا يلغي المشكلة. إنه فقط يتيح لك القياس بدلًا من التخمين.
إنشاء خيوط جديدة في JVM مكلف نسبيًا. فهو يتضمن إعداد مكدس java ومكدس نظام، واستدعاءات نظام واستدعاءات عكسية. وهذا أغلى من إنشاء كائنات ‘عادية’، خاصة بالنسبة لخادم يجب أن يخدم الكثير من الطلبات قصيرة العمر وسينشئ خيطًا جديدًا لكل واحد منها. في بيئة التطوير لا يهم هذا، لكنه في بيئة الإنتاج عالية الإنتاجية أمر حاسم.
لماذا نهتم بـ Loom
يحاول Project Loom تقليل هذه المشكلات أو إزالتها بالخيوط الافتراضية.
الفكرة هي خيط Java غير مرتبط بخيط منصة. فهذا الخيط الافتراضي لا يستهلك موارد نظام التشغيل أو المعالج إلا عندما يضطر لذلك فعلًا، فيبقى خيط المنصة متاحًا لعمل آخر. أما الخيط طويل التشغيل الذي يستهلك المعالج بكثافة فسيثبّت نفسه على خيط المنصة ويصبح عنق زجاجة. وذلك لأن الخيوط الافتراضية ليست أسرع من الخيوط العادية – ما تحسّنه هو كيفية استخدام خيوط المنصة.
تلبي الخيوط الافتراضية احتياجات الإنتاجية العالية التي لا تستطيع الخيوط العادية تلبيتها بسبب العدد المحدود لأنوية المعالج. فتسريع الحساب أو تحقيق زمن استجابة منخفض ليس ما صُممت من أجله.
تتولى جدولة خيوط المنصة في Java نظام التشغيل، بينما تتولى JDK جدولة الخيوط الافتراضية. ويربط مجدوِل JDK الخيوط الافتراضية بخيوط المنصة بنمط متعدد إلى متعدد، كما في الصورة أدناه.
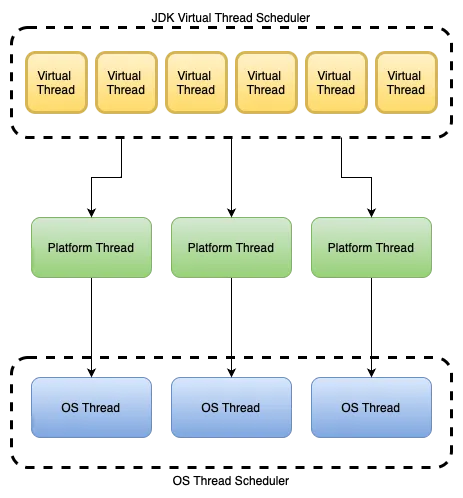
في الأقسام التالية نعرض الخيوط الافتراضية أثناء العمل ببناء تطبيق Quarkus واختباره تحت الحمل بإعدادات مختلفة.
Quarkus والخيوط الافتراضية
Quarkus حزمة Java بُنيت والنشر السحابي هدف أساسي لها. وتعلن عن بدء تشغيل سريع وبصمة ذاكرة صغيرة. وهي تعمل جيدًا مع Kubernetes وتتيح تشغيل التطبيقات على كل من OpenJDK HotSpot وGraalVM. وتقدم Quarkus البرمجة الأمرية والتفاعلية على حد سواء، والأولى منفّذة أصلًا بـ Netty وMutiny.
المتطلبات المسبقة
يعتمد التطبيق النموذجي على الأدوات التالية، التي يجب تثبيتها قبل المتابعة:
- Java OpenJDK HotSpot 19
- Docker
- Quarkus
- siege - أداة لاختبار الانحدار وقياس الأداء
تهيئة التطبيق النموذجي
ابدأ بتهيئة تطبيق Quarkus
quarkus create app loom-quarkusالاعتماديات
يجب إضافة بعض المكتبات الإضافية إلى اعتماديات Maven.
quarkus-agroal وquarkus-jdbc-postgresql وquarkus-reactive-pg-client هي مكتبات مصدر البيانات التي تتولى الاتصالات الحاجبة وغير الحاجبة على التوالي.
quarkus-resteasy-reactive-jackson تتيح بناء خدمات REST تعيد JSON.
<dependency>
    <groupId>io.quarkus</groupId>
    <artifactId>quarkus-agroal</artifactId>
</dependency>
<dependency>
<groupId>io.quarkus</groupId>
<artifactId>quarkus-reactive-pg-client</artifactId>
</dependency>
<dependency>
<groupId>io.quarkus</groupId>
<artifactId>quarkus-jdbc-postgresql</artifactId>
</dependency>
<dependency>
<groupId>io.quarkus</groupId>
<artifactId>quarkus-resteasy-reactive-jackson</artifactId>
</dependency>تفعيل الخيوط الافتراضية
الخيوط الافتراضية المرفقة مع Java19 معطلة افتراضيًا، لذا يجب إبلاغ Java صراحةً بتشغيلها. يمكنك فعل ذلك بالمعامل –enable-preview في ملف إعدادات Maven. واضبط رقم الإصدار (release) على 19 أيضًا.
<plugin>
    <artifactId>maven-compiler-plugin</artifactId>
    <version>${compiler-plugin.version}</version>
    <configuration>
        <compilerArgs>
            <arg>--enable-preview</arg>
        </compilerArgs>
        <release>19</release>
    </configuration>
</plugin>
إعداد مصدر البيانات
توفر Quarkus Dev Services التي تسهّل التطوير. ومن بين ما تفعله أنها تستطيع تجهيز قاعدة بيانات Postgresql وإعدادها تلقائيًا. وفي هذه الحالة تتولى Quarkus إعداد مصدر البيانات للوصول الحاجب وغير الحاجب، وهو كافٍ تمامًا لهذا التطبيق النموذجي.
فعّل خدمات التطوير لقاعدة البيانات في application.properties:
quarkus.datasource.devservices.enabled=trueخدمة REST
توضح هذه الخدمة كيفية استخدام الخيوط الافتراضية. تشغّل Quarkus الخدمات بطريقة تفاعلية افتراضيًا، لذا تحتاج الخدمة إلى إعداد دقيق يعتمد على التعليقات التوضيحية @Blocking و@NonBlocking و@UseVirtualThreads.
@Path("/sandbox")
@Produces(MediaType.APPLICATION_JSON)
@NoCache()
@Blocking
public class LoomSandboxResource {

    BlogpostsRepository repository;

    @Inject
    public LoomSandboxResource(BlogpostsRepository repository) {
        this.repository = repository;
    }

    @GET
    @Path("/blocking/jdbc")
    public List<Blogpost> blogPostsBlockingJDBC() {
        return repository.findAllJdbc();
    }

    @GET
    @RunOnVirtualThread
    @Path("/loom/jdbc")
    public List<Blogpost> blogPostsLoomJdbc() {
        return repository.findAllJdbc();
    }
}
مستودع البيانات
يستخدم التطبيق مستودعًا واحدًا فقط. ومع ذلك يعمل هذا المستودع مع مصدري البيانات معًا: AgroalDataSource الحاجب وPgPool غير الحاجب.
@ApplicationScoped
public class BlogpostsRepository {
    final PgPool client; //This is nonblocking postgres driver
    final AgroalDataSource agroalDataSource; //This is standard blocking postgres driver
    private final String SELECT_ALL = "SELECT * FROM blogposts";

    @Inject
    public BlogpostsRepository(final PgPool client, final AgroalDataSource agroalDataSource) {
        this.client = client;
        this.agroalDataSource = agroalDataSource;
    }

    public List<Blogpost> findAllJdbc() {
        var quotesList = new ArrayList<Blogpost>();
        try (Connection connection = agroalDataSource.getConnection();
            PreparedStatement preparedStatement = connection.prepareStatement(SELECT_ALL);
            ResultSet resultSet = preparedStatement.executeQuery();) {
            while (resultSet.next()) {
                quotesList.add(BlogpostMapper.toBlogpost(resultSet));
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        return quotesList;
    }

    public Uni<List<Blogpost>> findAllReactiveUni() {
        return client.query(SELECT_ALL)
                .execute()
                .onItem().transform(BlogpostMapper::toBlogpost);
    }

    public Multi<Blogpost> findAllReactiveMulti() {
        return client.query(SELECT_ALL)
                .execute()
                .onItem().transformToMulti(set -> Multi.createFrom().iterable(set))
                .onItem().transform(BlogpostMapper::toBlogpost);
    }
}
تشغيل التطبيق
أسهل طريقة لبدء التطبيق هي Quarkus cli
%>quarkus devيجب أن ترى مخرجات مشابهة لما يلي:
بحلول هذه المرحلة يجب أن يكون التطبيق قيد التشغيل ومتصلًا بقاعدة بيانات Postgresql داخل Docker.
استيراد بيانات نموذجية
سنحمّل الآن بعض البيانات النموذجية لنتمكن من إجراء بعض الاختبارات والتأكد من أن التطبيق يتصل بقاعدة البيانات.
انسخ ملف البيانات النموذجية إلى المجلد main/resources/.
ثم ننشئ الفئة InitDb التي تتمثل مهمتها في قراءة البيانات من main/resources/sample-data.json وتحميلها في قاعدة البيانات.
تعيد الفئة إنشاء مخطط قاعدة البيانات عند كل بدء للتطبيق، بحيث يعمل كل اختبار على مجموعة البيانات نفسها بالضبط.
@ApplicationScoped
public class InitDb {
    boolean schemaCreate;
    final PgPool client;

    @Inject
    public InitDb(@ConfigProperty(name = "blogposts.schema.create", defaultValue = "true") boolean schemaCreate,
                PgPool client) {
        this.schemaCreate = schemaCreate;
        this.client = client;
    }

    void config(@Observes StartupEvent ev) {
        if (schemaCreate) {
            run();
        }
    }

    private void run() {
        List<Tuple> batch = prepareData();
        client.query("DROP TABLE IF EXISTS blogposts").execute()
                .flatMap(r -> client.query("CREATE TABLE blogposts (id SERIAL PRIMARY KEY, author VARCHAR(256) NOT NULL, content TEXT NOT NULL , tags VARCHAR(256))").execute())
                .await().indefinitely();
        client.preparedQuery("INSERT INTO blogposts (author, content, tags) VALUES ($1, $2, $3)")
                .executeBatch(batch)
                .await().indefinitely();

    }

    private List<Tuple> prepareData() {
        try {
            InputStream in = getClass().getResourceAsStream("/sample-data.json");
            String result = new BufferedReader(new InputStreamReader(in))
                    .lines().collect(Collectors.joining("\n"));

            ObjectMapper mapper = new ObjectMapper();
            TypeReference<List<Blogpost>> documentMapType =
                    new TypeReference<>() {
                    };

            var document = mapper.readValue(result, documentMapType);

            return document.stream().map(i -> Tuple.of(i.author(), i.content(), i.tags())).toList();

        } catch (IOException e) {
            throw new RuntimeException(e);
        }
    }
}
بعد إعادة التشغيل يجب أن يحتوي التطبيق على البيانات النموذجية. يمكنك التحقق من ذلك باستدعاء أحد عناوينه: http://localhost:8080/sandbox/blocking/jdbc .
الاختبار
كان الغرض من الاختبارات التحقق من كيفية استخدام التطبيق للمعالج والذاكرة والخيوط تحت الحمل، وما إذا كانت خيوط المنصة والخيوط الافتراضية تتصرف بشكل مختلف.
بيئة الاختبار:
- أنوية/خيوط المعالج - 10/10
- 64 GB من الذاكرة RAM
- Postgresql في Docker
- تطبيق Quarkus في وضع التطوير على Java OpenSDK Hot Spot 19
استُخدمت siege أداةً للاختبار. وهي أداة سطر أوامر بسيطة يكفي ملخصها الواضح لما تحتاجه هذه الاختبارات.
يُطلق كل اختبار 1000 طلب، مع انتظار ثانية واحدة قبل كل طلب.
يحمل كل رد نحو 1.2MiB من بيانات JSON.
حد مجمّع الخيوط 10
هنا ضُبط كل من حد مجمّع الخيوط وحجم مجمّع عمّال vertx على 10 خيوط.
كما ضُبط الحدان الأدنى والأقصى لعدد اتصالات قاعدة البيانات، لإبقاء فقدان البيانات عند أدنى مستوى.
quarkus.vertx.worker-pool-size=10
quarkus.thread-pool.max-threads=10
quarkus.datasource.jdbc.min-size = 60
quarkus.datasource.jdbc.max-size = 90
نتائج اختبار Siege
| الخيوط الافتراضية | خيوط المنصة | ||
|---|---|---|---|
| الزمن المنقضي | 12,38 | 10,94 | ثانية |
| متوسط زمن الاستجابة | 7,56 | 4,11 | ثانية |
| معدل المعاملات | 80,78 | 91,41 | معاملة/ثانية |
| الإنتاجية | 94,47 | 106,91 | MB/ثانية |
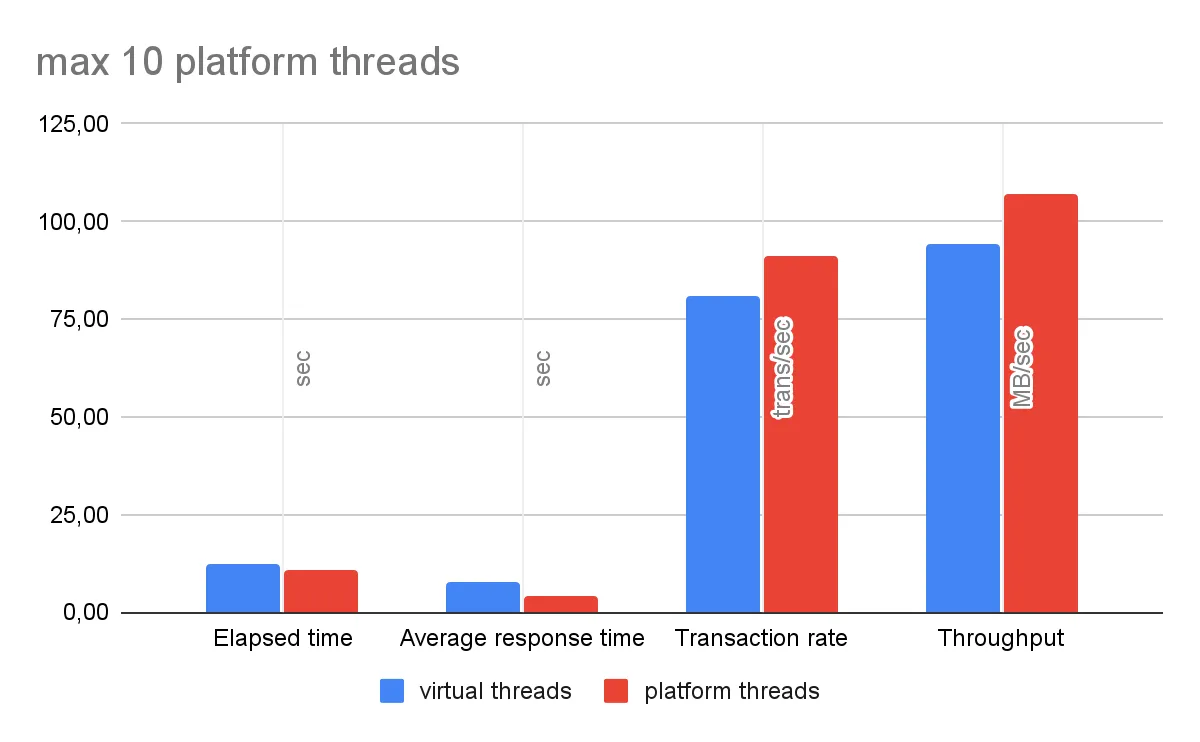
استخدام الذاكرة والمعالج
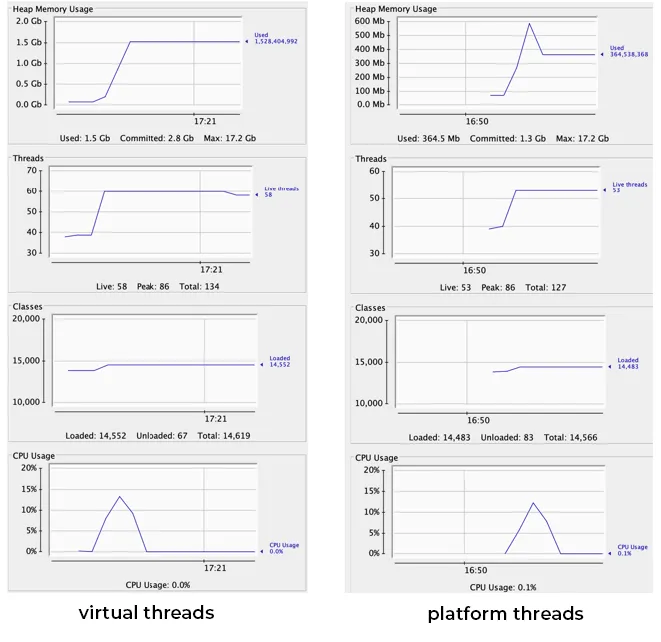
حد مجمّع الخيوط 100
هنا ضُبط كل من حد مجمّع الخيوط وحجم مجمّع عمّال vertx على 100 خيط.
ومرة أخرى ضُبط الحدان الأدنى والأقصى لعدد اتصالات قاعدة البيانات لإبقاء فقدان البيانات عند أدنى مستوى.
quarkus.vertx.worker-pool-size=100
quarkus.thread-pool.max-threads=100
quarkus.datasource.jdbc.min-size = 60
quarkus.datasource.jdbc.max-size = 90
نتائج اختبار Siege
| الخيوط الافتراضية | خيوط المنصة | ||
|---|---|---|---|
| الزمن المنقضي | 12,02 | 10,50 | ثانية |
| متوسط زمن الاستجابة | 6,89 | 4,07 | ثانية |
| معدل المعاملات | 83,19 | 95,24 | معاملة/ثانية |
| الإنتاجية | 97,30 | 108,27 | MB/ثانية |
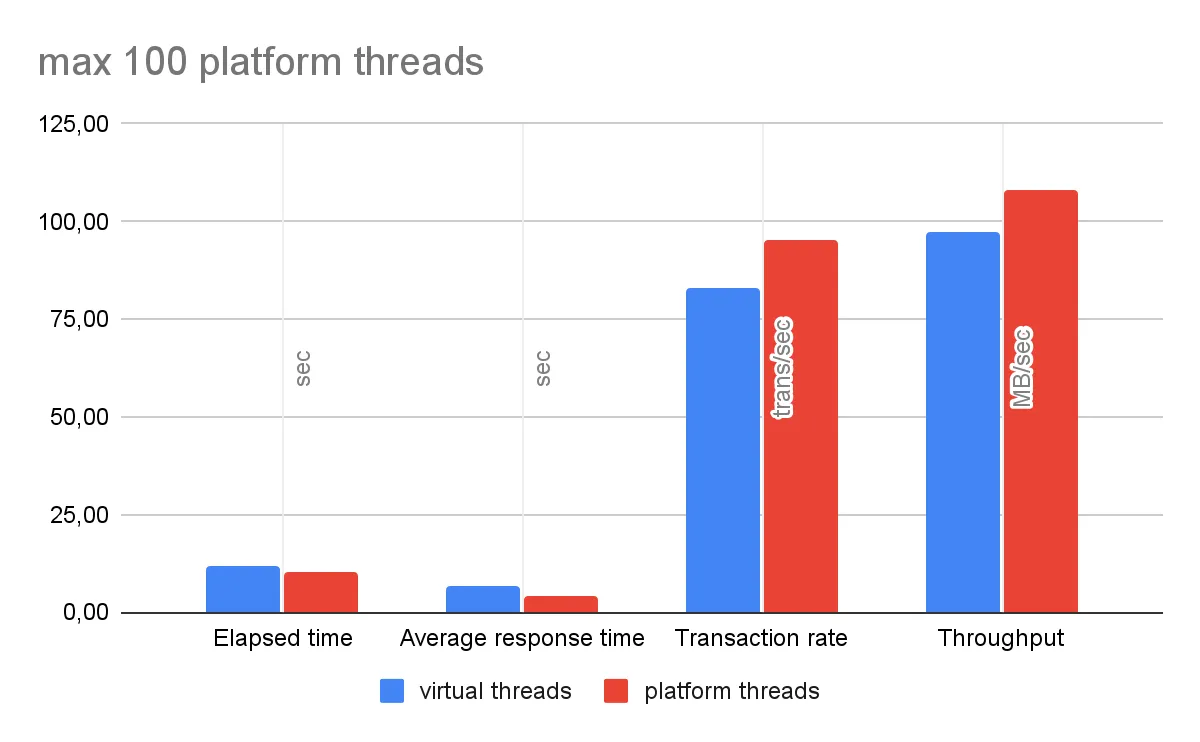
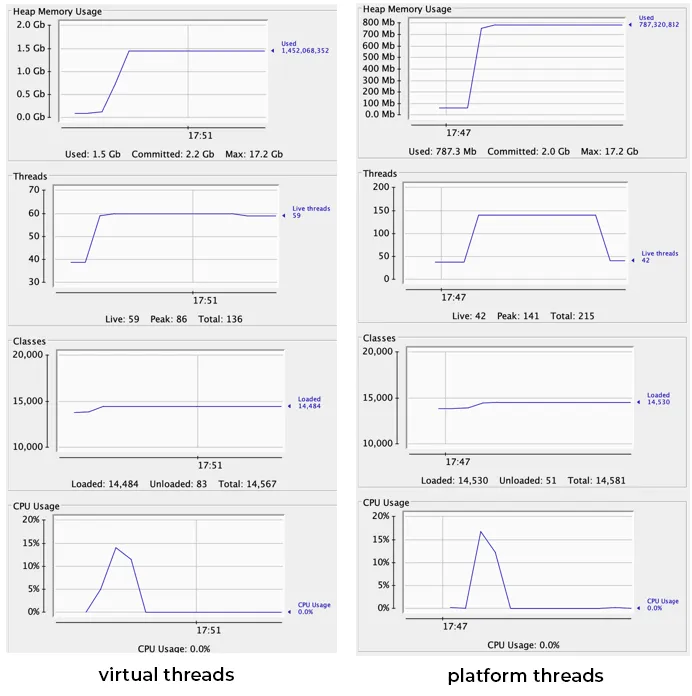
استخدام الذاكرة والمعالج
حد مجمّع الخيوط 300
هنا ضُبط كل من حد مجمّع الخيوط وحجم مجمّع عمّال vertx على 300 خيط.
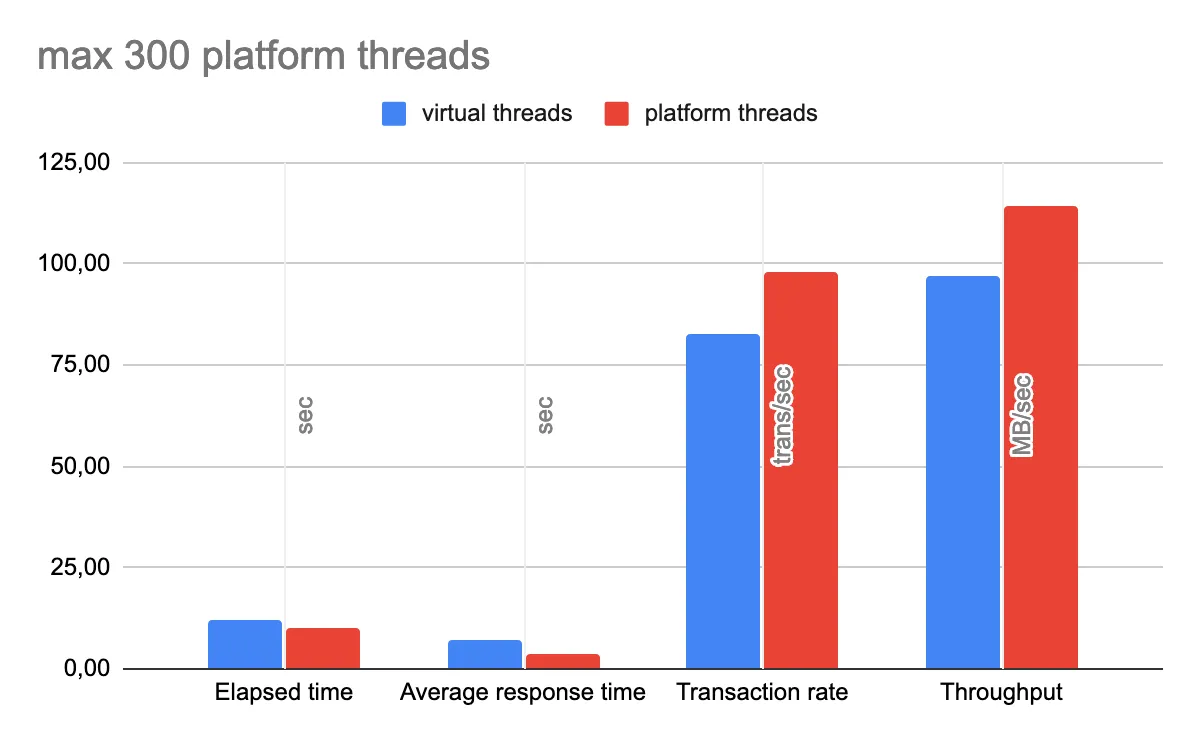
نتائج اختبار Siege
| الخيوط الافتراضية | خيوط المنصة | ||
|---|---|---|---|
| الزمن المنقضي | 12,07 | 10,23 | ثانية |
| متوسط زمن الاستجابة | 6,99 | 3,92 | ثانية |
| معدل المعاملات | 82,85 | 97,75 | معاملة/ثانية |
| الإنتاجية | 96,90 | 114,33 | MB/ثانية |
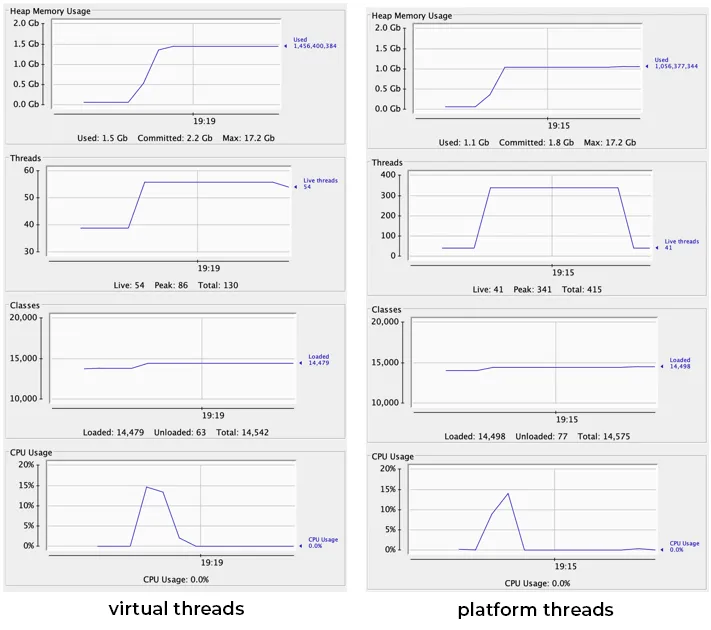
استخدام الذاكرة والمعالج
حد مجمّع الخيوط 10 ومهمة طويلة التشغيل
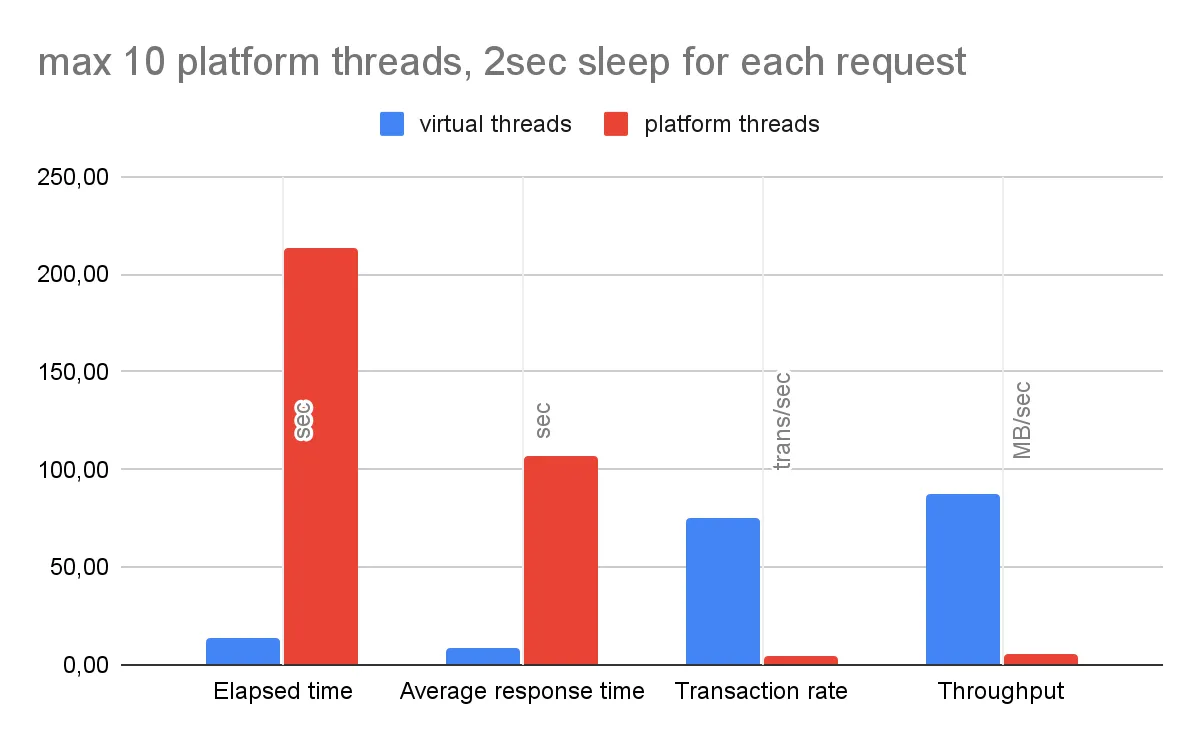
في هذا الاختبار نراقب كيف تتعامل الخيوط الافتراضية مع المهام طويلة التشغيل مقارنةً بخيوط المنصة. ولمحاكاة مهمة كهذه يجب تعديل BlogpostsRepository الأصلي بإضافة Thread.sleep(). ونتيجة لذلك يُحتجز كل طلب لمدة ثانيتين قبل إعادة القيمة.
public List<Blogpost> findAllJdbc() {
        var quotesList = new ArrayList<Blogpost>();
        try (Connection connection = agroalDataSource.getConnection();
            PreparedStatement preparedStatement = connection.prepareStatement(SELECT_ALL);
            ResultSet resultSet = preparedStatement.executeQuery();) {
            while (resultSet.next()) {
                quotesList.add(BlogpostMapper.toBlogpost(resultSet));
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        try {
            Thread.sleep(2000);
        } catch (InterruptedException e) {
            throw new RuntimeException(e);
        }
        return quotesList;
    }
نتائج اختبار Siege
| الخيوط الافتراضية | خيوط المنصة | ||
|---|---|---|---|
| الزمن المنقضي | 13,34 | 213,81 | ثانية |
| متوسط زمن الاستجابة | 8,15 | 106,56 | ثانية |
| معدل المعاملات | 74,96 | 4,68 | معاملة/ثانية |
| الإنتاجية | 87,68 | 5,47 | MB/ثانية |
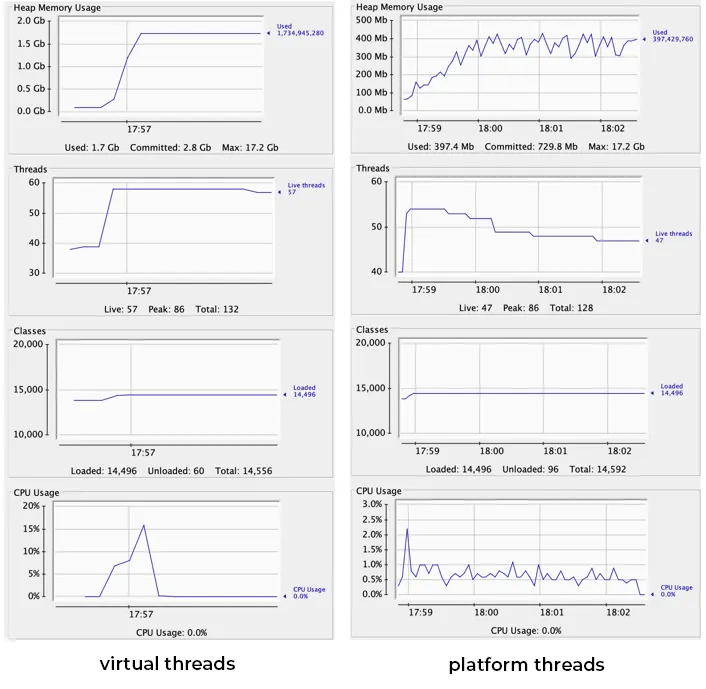
استخدام الذاكرة والمعالج
الخلاصة
للوهلة الأولى تشير النتائج إلى أن الخيوط الافتراضية تؤدي تقريبًا مثل خيوط المنصة. غير أن الاختبارين الأولين يكشفان أن خيوط المنصة يتحسن أداؤها مع نمو مجمّع الخيوط، بينما تبقى الخيوط الافتراضية عند المستوى نفسه تقريبًا. واختبار المجمّع بحجم 300 يرجّح الكفة أكثر نحو خيوط المنصة. فلماذا نكلّف أنفسنا عناء الخيوط الافتراضية أصلًا إذا كانت أبطأ، وفوق ذلك تستخدم ضعف ذاكرة الكومة (heap) التي تستخدمها خيوط المنصة؟
يكشف الاختبار الأخير ما تستطيعه الخيوط الافتراضية حقًا. فبالنظر عن كثب إلى النتائج نرى أنه مع مجمّع بحجم 10 تعاني خيوط المنصة في خدمة جميع الطلبات طويلة التشغيل – إذ احتاجت إلى أكثر من 200 ثانية لتنتهي. أما الخيوط الافتراضية، بالمقابل، فتثبت سرعتها الفائقة وتنتهي بعد 13 ثانية.
وهذا بفضل الطبيعة غير الحاجبة للخيوط الافتراضية. فهي لا تثبّت نفسها على خيط منصة إلا عند الضرورة، فيكون خيط المنصة حرًا لخدمة طلبات أخرى، مما يؤدي إلى إنتاجية عالية.
يبدو هذا مشجعًا جدًا، لكن علينا أن نتذكر أن Loom لا يزال في مهده، وأننا لم نكتشف بعد كل مزالقه.
في رأيي، لن يستخدم المبرمجون Loom مباشرةً في عملهم اليومي. الأهم هو اللحظة التي يضيف فيها النظام البيئي الكبير من المكتبات وأطر العمل دعم Loom.
ومن ناحية أخرى، قد يؤدي ذلك أيضًا إلى ظهور مشاريع جديدة مصممة حول Loom منذ البداية، وقد نشهد تغيرًا في المكتبات المستخدمة – على الأقل في الخدمات المصغّرة، حيث الإنتاجية العالية أساسية.