Ընկերության ֆինանսական տվյալներից պատկերացում ստանալու ժամանակի կրճատումը 90%-ով
Ինչպես մեր ընկերության մարդիկ դադարեցին բարդ SQL հարցումներ գրել և սկսեցին հարցեր տալ պարզ անգլերենով։
Ինչպես մեր ընկերության մարդիկ դադարեցին բարդ SQL հարցումներ գրել և սկսեցին հարցեր տալ պարզ անգլերենով։
Ակնարկ
Այս հոդվածը նկարագրում է, թե ինչպես FinBot-ը՝ BigQuery-ի ֆինանսական տվյալների AI-ով աշխատող բնական լեզվի ինտերֆեյսը, փոխեց մեր ընկերության՝ իր ֆինանսական տվյալներին հասանելիություն ստանալու ձևը։ Պատմությունը ներկայացված է որպես «առաջ և հետո» համեմատություն՝ ցույց տալով չափելի արտադրողականության բարելավումներ և միաժամանակ բավարար տեխնիկական մանրամասներ ինժեներ ընթերցողների համար։
Խնդիրը
Յուրաքանչյուր եռամսյակի վերջում, յուրաքանչյուր ամիս, իսկ երբեմն նույնիսկ ավելի հաճախ, մեր ֆինանսական թիմին ողողում են հարցերով տարբեր նախագծերի ֆինանսական վիճակի կամ դրա՝ նախորդ տարվա կամ եռամսյակի հետ համեմատության մասին։ Մենք մեր նախագծերի մասին շատ տվյալներ ունենք, և դրանց մեծ մասը պահվում է BigQuery-ում։
Կոնկրետ մանրամասներ գտնելը կամ հաշվետվություն պատրաստելը, երբ ինչ-որ մեկը կոնկրետ տվյալներ է խնդրում, կարող է ցավալի լինել. կամ պետք է ինքներդ իմանաք BigQuery-ն, կամ սպասեք, մինչև ինչ-որ մեկը ձեզ համար վերլուծի տվյալները։ Այս տվյալների հավաքածուում տվյալներ գտնելը սովորաբար պահանջում է մի քանի փորձ, ինչը ժամանակ է վատնում և հանգեցնում է ուշացած որոշումների, խցանումների և դժգոհ մենեջերների։
Հին ձևը
Ենթադրենք՝ դուք այն մարդկանցից եք, ովքեր անցել են վարչական և անվտանգության խոչընդոտները և հասանելիություն են ստացել մեր ֆինանսական տվյալները պարունակող BigQuery աղյուսակներին. ձեր դժվարությունները նոր են սկսվում։
Որպես կանոն, այս տվյալներով հետաքրքրվողները ծրագրավորողներ չեն, իսկ երբ այդպիսին են, ոչ յուրաքանչյուր ծրագրավորող գիտի, թե ինչպես է աշխատում BigQuery-ն։ Մի քանի աղյուսակ տվյալներ են հավաքում տարբեր աղբյուրներից հաշվետվությունների համար։ Սակայն եթե առկա հաշվետվությունները չեն բավարարում ձեր կարիքները, հնարավոր է՝ ստիպված լինեք հաղթահարել մի քանի տեխնիկական խոչընդոտ, մինչև հասկանաք՝ տվյալների հավաքածուում ինչն ինչ է։
Դրանց թվում են.
- BigQuery SQL շարահյուսության պահանջները
- Աղյուսակների միջև բարդ կապերը
- Սյունակների անվանման հակաինտուիտիվ կանոնները.
a)sales_value_PLNvscosts_value_PLN
b)speciality_groupvsspecialty(ուշադրություն դարձրեք ուղղագրությանը)
c)profit_center= նախագծի անվանումը - Բարդ ժամանակային տրամաբանություն.
a) Q1 = 1-3 ամիսներ, Q2 = 4-6 ամիսներ և այլն
b) Տարի/ամիս/շրջան սյունակները պետք է ճիշտ ֆիլտրվեն - Բազմաթիվ արժույթների մշակում (PLN, USD)
Հարցման տիպիկ ընթացքը (առաջ)
Եթե այս տվյալների հավաքածուի հետ կանոնավոր չեք աշխատում, BigQuery console-ը բացելիս ամեն անգամ անցնում եք քիչ թե շատ նույն ընթացակարգով.
- Օգտատերը ուզում է. «Որքա՞ն ենք վաստակել X նախագծից Q2-ում»։
- Քայլ 1. Բացել BigQuery console-ը (1-2 րոպե)
- Քայլ 2. Հիշել/փնտրել աղյուսակների անունները (2-3 րոպե)
- Քայլ 3. Գրել SQL-ի առաջին տարբերակը.
SELECT SUM(sales_value_PLN) FROM olap_cube
WHERE profit_center = 'Project X' -- Wrong name?
AND quarter = 2 -- No quarter column!
AND year = 2025- Քայլ 4. Ուղղել սխալները (3-5 րոպե)
- Սյունակը գոյություն չունի
- Պետք է month BETWEEN 4 AND 6
- Profit center-ի անունը ճշգրիտ համընկնում չէ
- Քայլ 5. Կրկնել 2-3 անգամ (5-10 րոպե)
- Քայլ 6. Արդյունքները ձևաչափել ձեռքով (2 րոպե)
- Ընդամենը. 15-20 րոպե՝ մեկ պատասխան ստանալու համար
Այս ութ քայլերը հիասթափության բուն սահմանումն են, և դրանք մեր ֆինանսական թիմի այդքան զբաղված լինելու պատճառներից մեկն են։ Եթե պետք են արագ մարժայի ստուգումներ կամ այլ ad-hoc վերլուծություն, բախտներդ չի բերել. կամ տվյալների հավաքածուն պետք է հիմնովին սովորեք, կամ սպասեք։
Հարցումների բարդության իրական օրինակներ
Խնդիրը ճշգրիտ ցույց տալու համար դիտարկենք պարզ հարցում, որ ինչ-որ մեկը կարող է ուզենալ կատարել տվյալների հավաքածուի վրա. «Որքա՞ն էր մեր եկամուտը անցյալ եռամսյակում»։
Դրան պատասխանելու համար Google console-ում պետք է գրել հետևյալ հարցումը.
Անհրաժեշտ SQL.
SELECT SUM(sales_value_PLN) as revenue FROM `project.dataset.olap_cube` WHERE year = 2025 AND month BETWEEN 1 AND 3Ահա ևս մեկը, օրինակ՝ «Backend guild-ի լավագույն 5 կապալառուները ըստ մարժայի»
Անհրաժեշտ SQL.
SELECT person, SUM(sales_value_PLN) as sales, SUM(costs_value_PLN) as costs, (SUM(sales_value_PLN) - SUM(costs_value_PLN)) / NULLIF(SUM(sales_value_PLN), 0) as margin FROM `project.dataset.olap_cube` WHERE guild = 'Backend' AND year = 2025 GROUP BY person ORDER BY margin DESC LIMIT 5Նույնիսկ փոքր փորձ ունեցող ծրագրավորողի համար այս հարցումները կարող են ոչ շատ բարդ թվալ, սակայն ընկերության շատ մարդկանց, հատկապես ոչ տեխնիկականների համար, նման հարցումներ գրելը նշանակում է շաբաթական կորցրած ժամեր ողջ կազմակերպությունում և կախվածություն «SQL-ին տիրապետող» թիմակիցներից – և թեև մեր տվյալները բաց են բոլորի դիտման համար, self-service անալիտիկան մնում է առասպել։
Լուծումը (FinBot-ի ներածություն)
Ֆինանսական թիմից խնդրելու փոխարեն՝ այս տարվա լավագույն 5 կապալառուներին ըստ մարժայի տվյալ բաժնում, որպեսզի ինչ-որ մեկը նստի և մեզ համար այն թարգմանի BigQuery console-ի լեզվով, մենք կարող էինք նույն հարցը պարզապես տալ չաթբոտին և ստանալ պատասխանը։ Սա իսկական self-service է այդ տվյալներով հետաքրքրված ցանկացածի համար, ոչ միայն տվյալների ինժեներների կամ ծրագրավորողների։
Նախագծի գաղափարն էր ավտոմատ կերպով վերացնել ցանկացած անորոշություն և պատասխաններ տալ վայրկյաններում, այլ ոչ թե րոպեներում, ժամերում կամ օրերում։ Դուք պետք է կարողանաք հարցեր տալ այնպես, ինչպես կհարցնեիք գործընկերոջը՝ առանց անհանգստանալու, որ տվյալների մասին ամեն ինչ չգիտեք. եթե մեր բոտը չկարողանա հասկանալ, թե ինչ նկատի ունեք, նա պարզաբանող հարցեր կտա – ճիշտ ինչպես մեր ֆինանսական ղեկավարը։
Ի՞նչ է FinBot-ը
FinBot-ը մեր Innovation Hub-ի (ընկերության ստորաբաժանում, որը փորձարկում և իրականացնում է AI-ի հետ կապված գաղափարներ) ամենանոր նախագիծն է։ Այն ֆինանսական վերլուծության օգնական է, որն օգտագործում է LangChain և LangGraph՝ agent-ների օրկեստրացիայի համար, և Google BigQuery MCP, որպեսզի agent-ները կարողանան հարցումներ կատարել մեր տվյալների աղբյուրի վրա։
FinBot-ի ստեկը.
- FastAPI (Python 3.10+)՝ REST API-ի համար
- LangChain + LangGraph՝ agent-ների օրկեստրացիայի համար
- GPT-4o՝ բնական լեզվի ընկալման համար
- Google BigQuery՝ որպես տվյալների աղբյուր
- Redis՝ քեշավորման համար
- PostgreSQL՝ զրույցները պահելու համար
Դրան կարելի է հասանելիություն ստանալ.
- Վեբ չաթ ինտերֆեյսի միջոցով (SvelteKit)
- REST API-ի միջոցով
Ճարտարապետությունը մեկ հայացքով
Այս նախագծի հիմնական մարտահրավերն էր նախագծել ճարտարապետություն, որը ավելին կանի, քան պարզապես օգտատիրոջ մուտքագրումը կուղարկի BigQuery MCP սերվերին. այն պետք է կազմակերպեր agentic flow, որը նախապես մշակում է օգտատիրոջ հարցումը և հարստացնում է այն լրացուցիչ հատկություններով, որպեսզի վերջնական SQL Agent-ը գեներացնի այն հարցումները, որ մենք իրապես ուզում ենք։
Դրան հասնելու համար մենք կառուցեցինք հատուկ multi-agent pipeline (նկարագրված է 3-րդ բաժնում), որը պարզում է հարցման տեսակը, ինչպես է այն արտապատկերվում տվյալների բազայի իրական տվյալների վրա և ինչպիսին պետք է լինի վերջնական արդյունքը։ Multi-agent մասերին աջակցելու համար ավելացվեցին լրացուցիչ բաղադրիչներ՝ քեշավորման, գծապատկերների գեներացման և համատեքստի ավելի լավ ընկալման համար։
Համակարգի մեկ այլ կարևոր մասը Google SSO-ի հետ ինտեգրացիան է, որը երաշխավորում է, որ այս տվյալներին կարող են հասնել միայն մեր կազմակերպության ներսի մարդիկ։ Պահպանման շերտը՝ պարզ Postgres տվյալների բազա, գոյություն ունի միայն օգտատերերի զրույցները պահելու համար, որպեսզի յուրաքանչյուր օգտատեր կարողանա նայել նախորդ արդյունքները, անհրաժեշտության դեպքում վերագեներացնել գծապատկերները և այլն։
Տեխնիկական խորացում
Multi-agent ճարտարապետություն
Որպեսզի FinBot չաթը կարողանա մշակել իրական օգտատերերի հարցումները, մենք չենք կարող դրանք պարզապես փոխանցել SQL agent-ին, որը դրանք վերածում է BigQuery SQL-ի։ Դա կաշխատեր միայն եթե օգտատերերը իմանային, թե ինչպես են տվյալները պահվում մեր տվյալների հավաքածուներում, ինչ սյունակներ կան և ինչ են դրանք պարունակում։
Վերցնենք օգտատիրոջ պարզ մուտքագրում, ինչպես «Show me all projects John Smith worked on in 2025». այն քիչ հնարավորություն ունի դառնալ ճիշտ SQL հարցում մի քանի պատճառով։ Նախ՝ տվյալների հավաքածուն project(s) կոչվող սյունակ չունի – մեր տվյալների բազայում նախագծերը գտնվում են profit_center կոչվող սյունակում (պատմական պատճառներով)։ Մեկ այլ խնդիր այն է, որ ‘John Smith’ անունով մարդ չկա – կա, սակայն, ‘Smith John’ անունով մարդ՝ ազգանունը առաջին տեղում – գաղափարը հասկանալի է։
FinBot-ը նաև պետք է զրուցակցային լինի։ Երբ տալիս ենք շարունակական հարց, ինչպես «and James Wilson», նա պետք է հիշի, թե ինչ ենք հարցրել նախկինում, որպեսզի կարողանա լրացնել համատեքստը և միայն այդ հատվածից կառուցել ճիշտ հարցումը մեզ համար։
Սա մշակելու համար մենք կառուցեցինք multi-agent flow, որը փորձում է լուծել տեղեկատվության մի քանի կտոր, հավաքել դրանք և փոխանցել SQL Agent-ին, որպեսզի նա կարողանա ստեղծել ամենահարմար հարցումը։ Այս workflow-ում ներգրավված agent-ները նկարագրված են ստորև։
Query router agent
Մշակման առաջին փուլը դասակարգիչն է. որոշ հարցումներ ընդհանրապես պետք չէ հասնեն SQL agent-ին, և մենք կարող ենք դրանք կարճ միացնել՝ արդյունքները ավելի արագ վերադարձնելու համար։
Query router agent-ը հարցմանը վերագրում է տեսակ.
DATA_QUERY– պահանջում է SQL կատարելMETA_QUESTION– վերաբերում է նախորդ արդյունքներինEXPLANATION_REQUEST– հարցնում է, թե ինչպես է ինչ-որ բան հաշվարկվելCLARIFICATION– փոխում է նախորդ հարցումըGENERAL– SQL պետք չէ
Երբ ճանաչում ենք, օրինակ, GENERAL հարցման տեսակը, որովհետև օգտատերը հարցնում է եղանակի մասին, մենք գործում ենք որպես սովորական չաթբոտ, ինչպես ChatGPT-ն։
Query router agent-ը որոշում է՝ արդյոք entity resolution-ը (որը կատարում է flow-ի մեկ այլ agent) պահանջվում է, անհրաժեշտության դեպքում հանում է նախնական entity-ները և որոշում է՝ արդյոք տվյալները պետք է խմբավորվեն՝ տրամադրելով group_by_hint ագրեգացիաների համար և այլն։
Նախնական entity-ների հանումը կատարվում է ստատիկ գիտելիքների բազայի վրա, որը FinBot-ի ներքին մասն է, օրինակ՝ project-ը այստեղ թարգմանվում է profit_center-ի. մյուս, ավելի բարդ entity սցենարները, անհրաժեշտության դեպքում, մշակում է Entity Resolution Agent-ը։
Դասակարգման օրինակ.
- Մուտք. “Show me direct margins for all projects in 2025”
- Ելք.
{query_type: "DATA_QUERY", group_by_hint: "profit_center", needs_entity_resolution: false}
Entity Resolution Agent
Entity Resolution Agent-ը կամրջում է բացը այն տվյալների միջև, որ մենք պահում ենք, և այն տվյալների, որոնց մասին հարցնում է օգտատերը։ Մարդկանց անունները կատարյալ օրինակ են։ Մենք կարող ենք հարցնել ‘John Smith’, ‘Smith John’ կամ պարզապես ‘Smith’ մասին, և ուզում ենք, որ այս բոլորը արտապատկերվեն տվյալների բազայում պահվող ճշգրիտ արժեքին, որպեսզի BigQuery SQL ֆիլտրը (WHERE person = ‘Smith John’ գեներացվի։ Նույնը վերաբերում է նախագծերի անվանումներին, մասնագիտություններին, բաժինների անվանումներին և այլն։
Agent-ը կատարում է fuzzy matching այն գիտելիքների բազաների վրա, որ կառուցում է հենց տվյալներից. աղբյուրների օրինակներ են.
- Կապալառուների ցանկը տվյալների բազայից
- Profit center-ների (նախագծերի) անվանումները
- Guild-ների անվանումները
- Մասնագիտական խմբերը
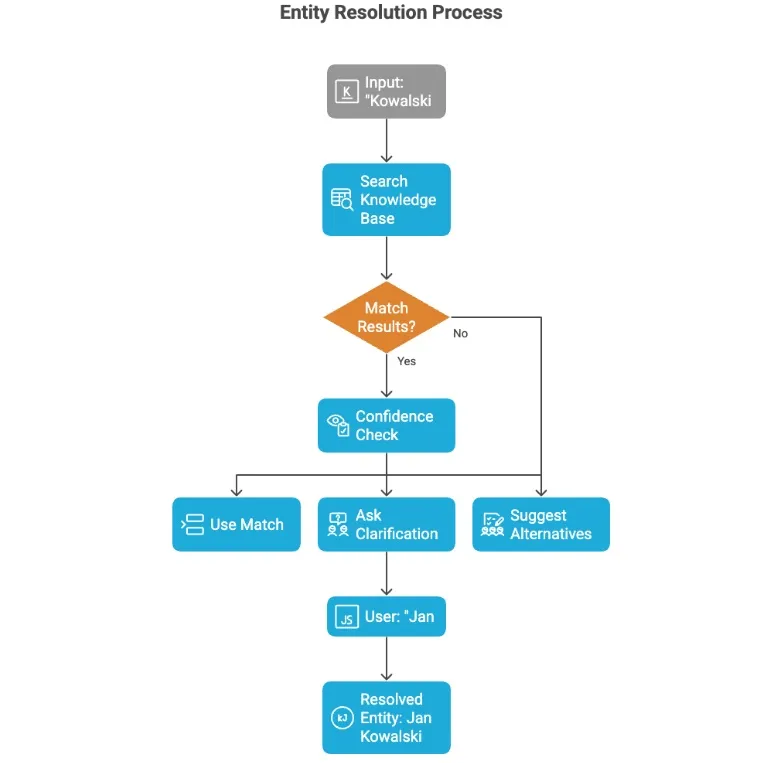
Երբ entity-ն չի կարող լուծվել, այս agent-ը կարճ միացնում է flow-ը և տալիս է պարզաբանող հարցեր անորոշության վերաբերյալ։ Օրինակ՝ եթե հարցնենք ‘John’ անունով մարդու մասին, բայց այդ անվամբ մի քանի գրառում կա, agent-ը կփորձի պարզել, թե ումն ենք նկատի ունեցել.
- “Did you mean ‘John Smith’ or ‘John Brown’?”
Agent-ը արտադրում է վստահության գնահատականներ, և երբ դրանք իջնում են տվյալ շեմից ցածր, իրական արդյունքները ստանալու workflow-ն դադարեցվում է։
SQL Agent (Core Engine)
SQL Agent-ը մեր agentic համակարգի կենտրոնական մասն է, քանի որ հենց նա է իրական հարցումները կատարում Google BigQuery-ի վրա։
Սա LangChain-ի create_sql_agent-ն է openai-tools տիպի։ Մենք օգտագործում ենք GPT-4o մոդելը (temperature=0՝ դետերմինիզմի համար) և կառուցում ենք system prompt, որը պարունակում է.
- Սխեմայի ամբողջական փաստաթղթավորում
- Բիզնես համատեքստ (մետրիկաների բանաձևեր, տերմինաբանություն)
- Հարցումների օրինաչափություններ և օրինակներ
- Ժամանակային արտապատկերում (Q1-Q4)
- Անվտանգության սահմանափակումներ (միայն SELECT)
Agent-ն ավելացնում է համատեքստ, ինչպես (տարի, եռամսյակ, ամիս, բաժին), և ներարկում է զրույցի պատմությունը և լուծված entity-ների մասին հուշումները։
Մենք նախագծել ենք agent-ն այնպես, որ ճշգրիտ SQL հարցումը կարելի է հանել կատարման հետքից, ինչը կարևոր է որոշ վերջնական օգտատերերի համար, ովքեր ուզում են հաստատել, որ հաշվարկները կատարվել են մեր տվյալների պահոցի ճիշտ տվյալների վրա։
Chart Generator Agent
Մեր գործիքի ամենանոր հնարավորություններից մեկը FinBot-ով ստացված կոնկրետ տվյալների համար գծապատկերների ավտոմատ գեներացումն է։ Դրան աջակցելու համար մենք կառուցեցինք փոքր օժանդակ agent, որը հարցման դեպքում վերցնում է ստացված տվյալները և դրանք վերածում գեղեցիկ գծապատկերների։
Agent-ը ուսումնասիրում է պատասխանի տեքստը և ավտոմատ կերպով ընտրում է հարմար վիզուալիզացիայի մեթոդներ։ Այն աշխատում է bar, line, pie, doughnut և աղյուսակի ձևաչափերով և արտադրում է Chart.js-ի հետ համատեղելի JSON, որը FinBot UI-ը հետո օգտագործում է արդյունքը ցուցադրելու համար։
Prompt engineering-ի մանրամասներ
Բիզնես համատեքստի ներարկում
Ինչպես կարճ նշվեց վերևում, օգտատիրոջ հարցումը հարստացվում է լրացուցիչ համատեքստով։ Agent-ների օգնությամբ մենք փորձում ենք ներառել տեղեկատվություն, որ արդեն ունենք ոլորտային գիտելիքից, ինչպես.
- Բիզնես բառարանի տերմիններ
- Մետրիկաների բանաձևեր (օր.՝ margin = (sales - costs) / sales)
- Հաճախակի հարցումների օրինաչափություններ
Տերմինաբանական որոշ արտապատկերումների հետ միասին, օրինակ.
- “revenue” →
sales_value_PLN - “project” →
profit_center - “team” →
guild
System prompt-ի կառուցվածքը
Ամբողջական prompt-ը հավաքվում է ստորև թվարկված տարրերից. թե որոնք են ընտրվում և փոխանցվում հաջորդ agent-ին, կախված է կոնկրետ հարցումից, և դա կարող է լինել բոլորը կամ միայն ենթաբազմություն.
- Դերի սահմանում. “You are FinBot, an expert financial analyst…”
- Հնարավորությունների ցանկ
- Աղյուսակների փաստաթղթավորում՝ օրինակ սյունակներով
- Տվյալների հիմնական մոդելի ընկալում
- Հարցումների ուղեցույցներ
- Ժամանակային համատեքստ
- Հաճախակի հարցումների օրինաչափություններ
- Անվտանգության սահմանափակումներ
- Պատասխանի ձևաչափի հրահանգներ
Տվյալների հոսքը (end-to-end)
Ստորև բերված դիագրամը ցույց է տալիս ամբողջ ճանապարհը օգտատիրոջ հարցումից մինչև պատասխան։ LangChain-ով agentic flow-ով անցնելուց բացի՝ մի քանի լրացուցիչ քայլեր կատարվում են պայմանականորեն՝ կա՛մ գործընթացն արագացնելու համար (օր.՝ երբ նույն հարցն արդեն տրվել է), կա՛մ հնարավորություններ ավելացնելու համար, ինչպես BigQuery պահոցից վերադարձված տվյալներից գծապատկեր ստեղծելը։
Զրույցի պահպանում
Հարմարության համար և նաև պարզելու համար, թե օգտատերերն իրականում ինչ են հարցնում մեր FinBot-ին, մենք ավելացրինք պահպանման շերտ՝ Postgres տվյալների բազայի տեսքով, ինչը թույլ է տալիս մեզ հետագայում լավացնել լուծումը։
Յուրաքանչյուր օգտատեր կարող է նայել իր զրույցների պատմությունը, գծապատկերներ ստեղծել նախորդ պատասխանների համար կամ ստուգել, թե Google BigQuery-ի վրա իրական հարցումը որն էր։ Սա տրամադրում է աուդիտի հետք, որը կօգնի մեզ առաջիկայում բարելավվել, և նաև թույլ է տալիս օգտատերերին ուղղակիորեն վերադառնալ նախորդ համատեքստերին և զրույցներին։
Քեշավորման ռազմավարություն
LLM կանչերի ծախսերը կրճատելու համար մենք ներդրեցինք Redis-ի վրա հիմնված քեշավորման պարզ ռազմավարություն։ Այն հենվում է 1-ժամյա պարզ TTL ունեցող քեշի բանալիների վրա, որոնք կառուցվում են նորմալացված հարցումից + համատեքստից, և նրա հիմնական գործը entity resolution agent-ների հարցումները քեշավորելն է և շարունակական հարցերի քեշին հարմարեցված մշակումը հնարավոր դարձնելը։ Քեշը անվավեր է դառնում, երբ համատեքստը փոխվում է։
Վերափոխումը
Նոր ձևը – բնական լեզվով հարցումներ
Վերափոխումների օրինակներ
Տիպիկ փոխազդեցություն
FinBot-ի դեպքում օգտատերերին պետք չէ հարցումները ճշգրտել կամ զրոյից գրել, երբ ուզում են գտնել տեղեկատվության մի քանի կտոր։ Դուք պարզապես շարունակում եք զրույցը, և բոտը հասկանում է նախորդ հարցումների համատեքստը, ուստի կարող է ավտոմատ կերպով նորերը կառուցել ձեզ համար։
- Օգտատերը մուտքագրում է. «How much did backend development cost in Q2 2025?»
- FinBot-ը վերադարձնում է. «Backend development costs in Q2 2025: 125,430 PLN (April: 42,150 PLN, May: 48,280 PLN, June: 35,000 PLN)»
- Օգտատիրոջ շարունակական հարցը. «Which project had the highest?»
- FinBot (համատեքստին տեղյակ). «Project Alpha had the highest backend development costs at 32,500 PLN»
- Ընդհանուր ժամանակը. ~10-60 վայրկյան մեկ հարցման համար
Հարցումների իրական օրինակներ
Պարզ հարցումներ
- «Ի՞նչ է մեր ընդհանուր եկամուտը 2024-ի համար»
- «Ցույց տուր հունվարի ծախսերը»
- «Թվարկիր 2025-ի բոլոր նախագծերը»
Բարդ հարցումներ (այժմ աննշան)
- «Համեմատիր Backend guild-ի Q1-ի և Q2-ի մարժաները»
- «Ո՞ր մասնագիտություններն ունեն բացասական մարժա այս տարի»
- «Լավագույն 10 կապալառուները ըստ վաճառքի դրույքաչափի PLN-ով»
Շարունակական հարցումներ (համատեքստին տեղյակ)
- «իսկ Q3-ի համար» (Q2-ի հարցումից հետո)
- «Բաժանիր դա ըստ ամիսների» (տարեկան հարցումից հետո)
- «Ի՞նչ մարժա ունեն նրանք» (կապալառուների ցանկից հետո)
Ժամանակի խնայողության հաշվարկ
Հարցումների նոր ավտոմատացումը կտրուկ կրճատում է տվյալների հարցումները մշակելու համար անհրաժեշտ ժամանակը։ Մեկ հարցումն այժմ տևում է 10-60 վայրկյան՝ 15-20 րոպեի փոխարեն, ինչը նշանակում է մեկ հարցման ժամանակի միջին կրճատում ~97%-ով։
Տիպիկ թիմակցի համար, ով շաբաթական 10 հարցում է կատարում, դա կազմում է շաբաթական մոտ 2.3-3.3 ժամ խնայողություն, կամ միջինում մոտ 2.8 ժամ։
Կազմակերպության մասշտաբով (համակարգից օգտվում է 20 մարդ) բարելավումը գումարվում է զգալի արտադրողականության աճի.
- ~56 ժամ խնայված շաբաթական
- ~224 ժամ խնայված ամսական
- ~2,900 ժամ խնայված տարեկան, ինչը հավասար է ~1.4 լրիվ դրույքով աշխատողի վերականգնված հզորության։
Այս թվերը ցույց են տալիս, որ նույնիսկ մեկ հարցման համար համեստ բարելավումները ամբողջ կազմակերպությունում գումարվում են զգալի արդյունավետության աճի։
Ընդունումը և արդյունքները
Տարածման ռազմավարություն
Ինչպես շատ նոր արտադրանքների դեպքում, մենք ընտրեցինք փուլային տարածում՝ UX-ի որակը պաշտպանելու, ռիսկը նվազեցնելու և մասշտաբավորումից առաջ հետադարձ կապ հավաքելու համար։ FinBot-ի համար հատկապես կարևոր էր multi-agent ճարտարապետությունը սկզբում փորձարկել փորձագետ օգտատերերի փոքր խմբով (ֆինանսական թիմը և, հատկապես, նրա ղեկավարը)։
Վաղ նպատակն էր ստուգել, որ SQL Agent-ի արտադրած SQL-ը ճիշտ է։ Մենք այս SQL հարցումները ամբողջությամբ ցուցադրում ենք FinBot պատուհանի կողքին (վեբ տարբերակում), որպեսզի դրանք հեշտ հասանելի լինեն։
Փորձարկման մեկ այլ առանցքային ոլորտ entity resolution-ն էր (հատկապես անունների, նախագծերի, մասնագիտությունների, բաժինների և այլնի համար)։ Այն պետք էր ստուգել բազմաթիվ սցենարներով (սխալ ուղղագրություն, տարբեր հերթականություն, մասնակի բառեր և այլն)։
Հաջորդ փուլերը ներառում էին այն, ինչ մենք անվանեցինք «managers rollout», որը ներգրավեց այլ բաժինների՝ օրինակ վաճառքի կամ մարքեթինգի ավելի շատ մարդկանց՝ FinBot-ը փորձելու, մեզ ավելի շատ պատկերացում տալու այն հարցումների մասին, որոնք իրենց համար կարևոր են, և այլն։
Ամբողջ կազմակերպությունում տարածումը եղավ վերջինը և մշակող թիմից պահանջեց որոշ նախապատրաստություն, ինչպես օգտատերերի համար դեմո ձայնագրելը՝ դիտելու և սովորելու համար, Google SSO-ի աշխատանքը ողջ ընկերությունում ապահովելը և UI/UX-ը մշակելը՝ էլ ավելի լավ վերջնական փորձառության համար։
Չափանիշներ, որոնց հետևեցինք
Որպեսզի տեսնենք, թե ինչպես է FinBot-ն օգտագործվում և որտեղ է ամենաշատ արժեք տվել, սկսեցինք հավաքել օգտագործման և արդյունավետության մի քանի պարզ մետրիկա։ Դրանք նախատեսված չէին որպես համապարփակ անալիտիկա, այլ որպես միջոց ստուգելու՝ արդյոք գործիքն իրապես լուծում է վերը նկարագրված խնդիրները և ինչպես է այն աշխատում իրական բեռի տակ։
Օգտագործման մետրիկաներ
- Հարցումների քանակը օրական/շաբաթական
Հարցումների ծավալն աճեց, քանի որ ոչ տեխնիկական օգտատերերը ավելի վստահ դարձան ավելի բարդ հարցեր տալիս։ Նկատեցինք կրկնվող օրինաչափություններ, ինչպես պիկեր ամսվա փակման շուրջ և նախագծերի շահութաբերության վերանայումների ժամանակ։ Սա հաստատեց մեր ենթադրությունը, որ շատ մարդիկ խուսափել էին տվյալները ուսումնասիրելուց պարզապես այն պատճառով, որ SQL-ը խոչընդոտ էր հանդիսանում։
- Հարցումների ամենահաճախ հանդիպող տեսակները
Հարցերի մեծ մասը ընկնում էր մի քանի կատեգորիաների մեջ.
- Շահութաբերությունը նախագծի մակարդակում
- Եկամուտներ, ծախսեր և մարժաներ կոնկրետ ժամանակահատվածի համար
- Մետրիկաներ մարդկանց և guild-ի մակարդակում
- Ժամանակահատվածների համեմատություններ (Q1 vs Q2, տարեցտարի)
Սրանք գրեթե ճշգրիտ համընկնում էին այն ցավոտ կետերի հետ, որ նկարագրել էինք նախորդ բաժիններում։
- Պատասխանի միջին ժամանակը
Պատասխանի ժամանակները հուսալիորեն մնում էին 10–60 վայրկյան սահմաններում՝ կախված հարցի բարդությունից և այն բանից, թե արդյունքը մատուցվել է քեշից, թե ոչ։ Հին 15–20 րոպեանոց workflow-ի համեմատ՝ օգտատերերը բարելավումը տեսան հենց փորձելու պահին։
Որակական հետադարձ կապ
- Օգտատերերն այլևս չեն կախված «SQL-ին տիրապետող» մարդկանցից
Ամենանկատելի մշակութային տեղաշարժերից մեկն այն էր, որ ֆինանսական թիմին կամ ինժեներներին ուղղված սովորական հարցերը դադարեցին գալ։ Մարդիկ, ովքեր նախկինում ընդհանրապես խուսափում էին BigQuery-ից, սկսեցին ինքնուրույն վերլուծություն անել։
- Որոշումները կայացվում են ավելի արագ
PM-ները ասացին, որ հաճախորդների հետ խոսակցություններին պատրաստվելը շատ ավելի արագ դարձավ։ Ֆինանսական թիմը կարող էր ստուգել մարժաները կամ բյուջեները հանդիպումների ժամանակ՝ սպասելու փոխարեն, մինչև ինչ-որ մեկը SQL արդյունքներ հասցնի։
- Մարդկանց դուր է գալիս զրույցի ընթացքը
Շարունակական հարցերը, ինչպես “…and for Q3?” կամ “Please, break it down by month”, բնական թվացին և վերացրին ամբողջ հարցումները վերագրելու կամ BigQuery console-ում կողմնորոշվելու անհարմարությունը։
Ընդհանուր առմամբ, մետրիկաներն ու հետադարձ կապը ցույց տվեցին, որ FinBot-ը ոչ միայն տեխնիկապես աշխատեց – այն փոխեց այն ձևը, թե ինչպես են մարդիկ ամեն օր գործ ունենում ֆինանսական տվյալների հետ։
Տեխնիկական մարտահրավերներ և լուծումներ
Մեր առջև ծառացած մարտահրավերներից մի քանիսն արդեն հիշատակվել են այս հոդվածի ընթացքում, քանի որ դրանք ուժեղ ազդեցություն են ունեցել մեր ճարտարապետական որոշումների վրա մշակման իտերացիաների ընթացքում։ Այդուհանդերձ, ստորև թվարկում եմ ամենակարևորները՝ յուրաքանչյուր խնդրի կարճ նկարագրությամբ և բացատրությամբ, թե ինչպես ենք լուծել։
Մարտահրավեր. Երկիմաստ entity անվանումներ
Սա ամենահաճախ հանդիպող խնդիրն է և ազդում է հարցումների մեծ մասի վրա։ Օգտատերերը պատկերացում չունեն, թե ինչպիսին են տվյալները մեր BigQuery տվյալների հավաքածուում, ուստի եթե SQL Agent-ը կառուցում է person = "Brown" պարունակող հարցում, այն ոչինչ չի վերադարձնի։ Խնդիրն այն է, որ “Brown”-ը կարող է համընկնել մի քանի մարդու հետ. կարող է լինել “Michael Brown” կամ “Brown Michael”, կամ գուցե ինչ-որ մեկը, ով իրականում “Browne” է, բայց մենք նրան “Brown” ենք կոչում – որովհետև ինչո՞ւ ոչ։
Ինչպես մի քանի անգամ նշվել է վերևում, մենք սա լուծեցինք Entity Resolution Agent-ի օգնությամբ։ Այն կատարում է fuzzy matching վստահության գնահատականներով այն տվյալների վրա, որ ունենք որոշակի entity-ների համար. եթե բավարար վստահությամբ գրառում գտնի, այն փոխանցում է որպես լրացուցիչ համատեքստ pipeline-ի ներքևում, իսկ եթե ոչ, կարող է օգտատիրոջից խնդրել պարզաբանել, թե տվյալ entity-ով ինչ է նկատի ունեցել։
Մարտահրավեր. Բարդ ժամանակային հարցումներ
Մեկ այլ հետաքրքիր խնդիր ի հայտ եկավ, երբ սկսեցինք FinBot-ն օգտագործել ինչպես բոլորին ծանոթ չաթբոտերը (ինչպես ChatGPT-ն կամ Claude-ը). դուք պարզապես շարունակական հարցեր եք տալիս՝ առանց շատ մտածելու, թե ինչպես backend-ը դրանք կվերածի BigQuery տվյալների հավաքածուի վրա իրական SQL հարցման։ Կարող եք հարցնել Q3 2025-ի որևէ տվյալի մասին, ապա պարզապես ավելացնել “and Q2”, և բոտը պետք է հասկանա, թե ինչ նկատի ունեք։
Սա մշակելու համար մենք կառուցեցինք ContextManager, որը անհրաժեշտության դեպքում հանում է ժամանակային համատեքստը և SQL Agent-ի համար հավաքում է ավելի մեծ, ավելի հարուստ համատեքստ՝ օգտագործելով օգտատիրոջ սեսիայի համար քեշավորված տվյալները։
Մարտահրավեր. Արդյունավետություն
Մեր FinBot agentic համակարգը ունի մի քանի ցավոտ կետ և խցանում, որոնց հետ պետք է գլուխ հանենք։ Դրանցից մի քանիսը բխում են LLM-ին ուղղված սովորական կանչերից (մեծ համատեքստով, system հարցմամբ և այլն)։
Ավելի մեծ խնդիրը տվյալների հավաքածուի հնարավորություններն են և այն, թե որքան արագ է Google BigQuery-ն պատասխանում sql հարցումներին։ Բարդ հարցումների դեպքում սա զբաղեցնում է հարցում-պատասխան ժամանակի մեծ մասը, որը ձևավորում է օգտատիրոջ ընդհանուր փորձառությունը։ Մենք երկու խնդիրն էլ որոշ չափով մեղմացնում ենք քեշավորմամբ և ասինխրոն մշակմամբ, որտեղ հնարավոր է, բայց հիշեք, որ երբեք չեք կարող ավելի արագ լինել, քան ձեր տվյալների աղբյուրը, ուստի խնդիրը մնում է, քանի դեռ օգտագործում ենք BigQuery։
Ապագա ճանապարհային քարտեզ
FinBot-ը մեր ներքին հավելվածների պորտֆելիոյի վերջին լրացումն է, և մենք ներկայումս հավաքում ենք վիճակագրություն և այլ տեղեկատվություն այն մասին, թե ինչպես են մարդիկ դրանից օգտվում, ինչը նրանց պակասում է և ինչ կուզենային տեսնել առաջիկա թողարկումներում։ Առաջարկվող բարելավումներից մի քանիսն են.
- Տրենդների կանխատեսում և պրոգնոզավորում
- Արտահանում Excel/PDF
- Պլանավորված հաշվետվություններ և ահազանգեր
- Dashboard-ի ադմինիստրացիա
Մասշտաբավորման նկատառումներ
FinBot-ի հնարավորությունները զգալիորեն կաճեին, երբ ավելացնենք ավելի շատ տվյալների աղբյուրներ և հնարավորություններ, ինչպես արժույթի մոնիտորինգ, փոխարժեքներ և նախագծերին չվերաբերող հաշվապահական տվյալներ։ Դրանք ավելացնելը դժվար չէ, սակայն յուրաքանչյուրը մեր բոտին ավելացնում է գիտելիքի ևս մեկ շերտ, և այդ շերտերը պետք է փորձարկվեն համապատասխան ոլորտներում ավելի խորը ոլորտային գիտելիք ունեցող ավելի շատ մարդկանց կողմից և այլն։
Լրացուցիչ տվյալների աղբյուրներից բացի, օգտակար կլիներ նաև բոտը ինտեգրել մեր օգտագործած այլ համակարգերին, ինչպես ERP-ն կամ տարբեր բաժինների կողմից օգտագործվող ֆինանսական ծրագրերը։ Սակայն այդ ապագան գրելու պահին այնքան անորոշ է, որ առայժմ կարող ենք դա մի կողմ թողնել։
Եզրակացություն
FinBot-ը լավ ցույց է տալիս, թե ինչպես կարելի է ձեր տվյալները բացել ավելի լայն լսարանի համար բնական լեզվով հարցումների միջոցով։ Այն հենվում է multi-agent ճարտարապետության վրա՝ մասնագիտացված մշակման համար, և ավելացնում է մի քանի շերտ, որոնք օգնում են կառավարել համակարգի բարդությունը, լուծել entity-ները, պարզաբանել օգտատերերի հարցերը և արագ պատասխանել։
FinBot-ին ավելի շատ տվյալների աղբյուրներ և ինտեգրացիաներ ավելացնելը դժվար չէ, բայց այսպիսի նախագծերում իրական աշխատանքը սկսվում է արդյունքների և դրանց օգտակարության փորձարկումից։
Ինչպես կարող ենք օգնել ձեզ
Եթե ձեր կազմակերպությունը տառապում է տվյալներին դանդաղ հասանելիությունից, բարդ SQL workflow-ներից կամ փոքր խումբ փորձագետներից կախվածությունից, FinBot-ի նման agentic համակարգը կարող է ձեր թիմերին տալ իսկական self-service անալիտիկա։
Մեր ընկերությունում մենք օգնում ենք ընկերություններին նախագծել և կառուցել հատուկ AI օգնականներ, որոնք հարմարեցված են իրենց տվյալների աղբյուրներին, բիզնես բառապաշարին և անվտանգության պահանջներին։
Անկախ նրանից՝ ուզում եք ստեղծել բնական լեզվի ինտերֆեյս BigQuery-ի, ERP-ի կամ ցանկացած ներքին տվյալների հավաքածուի համար, մենք կարող ենք աջակցել ձեզ ամբողջ ճանապարհին՝ գաղափարից մինչև ճարտարապետություն և իրականացում մինչև տարածում։ Կապվեք մեզ հետ՝ քննարկելու, թե ինչպես կարող ենք օգնել ձեր տվյալները վերածել ակնթարթային պատկերացումների։