خفض زمن الوصول إلى الرؤى في البيانات المالية للشركة بنسبة 90%
كيف توقف العاملون في شركتنا عن كتابة استعلامات SQL المعقدة وبدؤوا يطرحون الأسئلة بلغة عادية.
كيف توقف العاملون في شركتنا عن كتابة استعلامات SQL المعقدة وبدؤوا يطرحون الأسئلة بلغة عادية.
نظرة عامة
يصف هذا المقال كيف غيّرت FinBot – واجهة بلغة طبيعية مدعومة بالذكاء الاصطناعي للبيانات المالية في BigQuery – طريقة وصول شركتنا إلى بياناتها المالية. وتُروى القصة على شكل مقارنة بين ما قبل وما بعد، تُظهر تحسينات قابلة للقياس في الإنتاجية، مع الدخول في تفاصيل تقنية تكفي القرّاء من المهندسين.
المشكلة
في نهاية كل ربع سنة، وكل شهر، وأحيانًا بوتيرة أكبر من ذلك، يُغرَق فريق المالية لدينا بأسئلة عن الوضع المالي لمشاريع مختلفة أو عن مقارنته بالعام أو الربع السابق. نحن نحتفظ بكثير من البيانات عن مشاريعنا، ومعظمها مخزَّن في BigQuery.
قد يكون استخراج تفاصيل معينة أو إعداد تقرير عندما يطلب أحدهم معلومات محددة أمرًا مؤلمًا: فإما أن تعرف BigQuery بنفسك أو أن تنتظر حتى يحلل شخص آخر البيانات من أجلك. وغالبًا ما يتطلب تحديد موقع البيانات في هذه المجموعة عدة جولات من المحاولات، مما يهدر الوقت ويؤدي إلى قرارات متأخرة وعنق زجاجة ومديرين منزعجين.
الطريقة القديمة
لنفترض أنك من الذين تجاوزوا العقبات الإدارية والأمنية وحصلوا على صلاحية الوصول إلى جداول BigQuery التي تحتوي على بياناتنا المالية – فمتاعبك لم تبدأ إلا للتو.
وكقاعدة، فإن الأشخاص المهتمين بهذه البيانات ليسوا مبرمجين، وحتى لو كانوا كذلك، فليس كل مبرمج يعرف كيف تعمل BigQuery. تجمع عدة جداول بيانات من مصادر مختلفة لأغراض إعداد التقارير. لكن إذا لم تلبِّ التقارير الموجودة احتياجاتك، فقد يتعين عليك تجاوز بعض العقبات التقنية قبل أن تفهم ما هو ماذا في مجموعة البيانات.
ومن هذه العقبات:
- متطلبات صياغة BigQuery SQL
- علاقات معقدة بين الجداول
- أعراف تسمية أعمدة مخالفة للبداهة:
أ)sales_value_PLNمقابلcosts_value_PLN
ب)speciality_groupمقابلspecialty(لاحظ الإملاء)
ج)profit_center= اسم المشروع - منطق زمني معقد:
أ) الربع الأول = الأشهر 1-3، والربع الثاني = الأشهر 4-6، وهكذا
ب) يجب تصفية أعمدة السنة/الشهر/الفترة بشكل صحيح - التعامل مع عملات متعددة (PLN, USD)
سير عمل الاستعلام النموذجي (قبل)
إذا كنت لا تعمل مع مجموعة البيانات هذه بانتظام، فإنك تمر بالروتين نفسه تقريبًا في كل مرة تفتح فيها وحدة تحكم BigQuery:
- يريد المستخدم: «كم ربحنا من المشروع X في الربع الثاني؟»
- الخطوة 1: فتح وحدة تحكم BigQuery (دقيقة إلى دقيقتين)
- الخطوة 2: تذكّر أسماء الجداول أو البحث عنها (2-3 دقائق)
- الخطوة 3: كتابة النسخة الأولى من SQL:
SELECT SUM(sales_value_PLN) FROM olap_cube
WHERE profit_center = 'Project X' -- Wrong name?
AND quarter = 2 -- No quarter column!
AND year = 2025- الخطوة 4: إصلاح الأخطاء (3-5 دقائق)
- العمود غير موجود
- يلزم استخدام month BETWEEN 4 AND 6
- اسم مركز الربح لا يطابق تمامًا
- الخطوة 5: التكرار 2-3 مرات (5-10 دقائق)
- الخطوة 6: تنسيق النتائج يدويًا (دقيقتان)
- الإجمالي: 15-20 دقيقة للحصول على إجابة واحدة
هذه الخطوات الثماني هي التعريف الحرفي لـ الإحباط، وهي أحد أسباب انشغال فريق المالية لدينا الشديد. وإذا كنت بحاجة إلى فحوص سريعة للهامش أو أي تحليل آني آخر، فأنت في ورطة: إما أن تتعلم مجموعة البيانات من الداخل إلى الخارج أو أن تنتظر.
أمثلة حقيقية على تعقيد الاستعلامات
لتوضيح المشكلة بدقة، تأمل استعلامًا بسيطًا قد يرغب أحدهم في تشغيله على مجموعة البيانات: «ما هي إيراداتنا في الربع الماضي؟»
وللإجابة عنه عليك كتابة الاستعلام التالي في وحدة تحكم Google:
SQL المطلوب:
SELECT SUM(sales_value_PLN) as revenue FROM `project.dataset.olap_cube` WHERE year = 2025 AND month BETWEEN 1 AND 3وهذا مثال آخر، مثلًا: «أفضل 5 متعاقدين من حيث الهامش في نقابة Backend»
SQL المطلوب:
SELECT person, SUM(sales_value_PLN) as sales, SUM(costs_value_PLN) as costs, (SUM(sales_value_PLN) - SUM(costs_value_PLN)) / NULLIF(SUM(sales_value_PLN), 0) as margin FROM `project.dataset.olap_cube` WHERE guild = 'Backend' AND year = 2025 GROUP BY person ORDER BY margin DESC LIMIT 5بالنسبة إلى مطور برمجيات لديه ولو قدر قليل من الخبرة، قد لا تبدو هذه الاستعلامات معقدة جدًا، لكنها بالنسبة إلى كثيرين في الشركة، ولا سيما غير التقنيين، تعني كتابة استعلامات كهذه ساعات تضيع كل أسبوع على مستوى المؤسسة واعتمادًا على أعضاء الفريق «القادرين على SQL» – ومع أن بياناتنا مفتوحة للجميع للاطلاع عليها، تبقى التحليلات الذاتية الخدمة (self-service analytics) وهمًا.
الحل (تقديم FinBot)
بدلًا من أن نطلب من فريق المالية أفضل 5 متعاقدين من حيث الهامش هذا العام في قسم معين، فيضطر أحدهم إلى الجلوس وترجمة ذلك إلى وحدة تحكم BigQuery نيابةً عنا، يمكننا أن نوجّه السؤال نفسه إلى روبوت محادثة ونتلقى الإجابة. وهذه خدمة ذاتية حقيقية لكل من يهتم بهذه البيانات، لا لمهندسي البيانات أو المبرمجين فقط.
كانت الفكرة وراء المشروع إزالة أي غموض تلقائيًا وتقديم الإجابات في ثوانٍ لا في دقائق أو ساعات أو أيام. ينبغي أن تستطيع طرح الأسئلة كما تسأل زميلًا، دون القلق من أنك لا تعرف كل شيء عن البيانات – فإذا لم يستطع روبوتنا فهم ما تقصده، فسيطرح أسئلة متابعة – تمامًا كما يفعل رئيس المالية لدينا.
ما هي FinBot؟
FinBot هو أحدث مشروع من مركز الابتكار (Innovation Hub) لدينا (قسم الشركة الذي يختبر وينفّذ الأفكار المتعلقة بالذكاء الاصطناعي). وهي مساعد للتحليل المالي يستخدم LangChain وLangGraph لتنسيق الوكلاء، وGoogle BigQuery MCP لتمكين الوكلاء من تشغيل الاستعلامات على مصدر بياناتنا.
التقنيات المستخدمة في FinBot:
- FastAPI (Python 3.10+) لواجهة REST API
- LangChain + LangGraph لتنسيق الوكلاء
- GPT-4o لفهم اللغة الطبيعية
- Google BigQuery كمصدر للبيانات
- Redis للتخزين المؤقت
- PostgreSQL لتخزين المحادثات
ويمكن الوصول إليها عبر:
- واجهة محادثة على الويب (SvelteKit)
- واجهة REST API
نظرة سريعة على المعمارية
كان التحدي الرئيسي في هذا المشروع تصميم معمارية تفعل أكثر من مجرد تمرير مدخلات المستخدم إلى خادم BigQuery MCP: كان عليها إعداد تدفق وكلاء (agentic flow) يعالج استعلام المستخدم مسبقًا ويثريه بخصائص إضافية، بحيث يولّد وكيل SQL النهائي الاستعلامات التي نريدها فعلًا.
ولتحقيق ذلك بنينا خط معالجة مخصصًا متعدد الوكلاء (موصوفًا في القسم 3) يحدد نوع الطلب، وكيف يرتبط بالبيانات الفعلية في قاعدة البيانات، وما ينبغي أن تكون عليه المخرجات النهائية. وأُضيفت مكونات أخرى لدعم الأجزاء متعددة الوكلاء بالتخزين المؤقت وتوليد المخططات وفهم أفضل للسياق.
ومن الأجزاء الحاسمة الأخرى في النظام التكامل مع Google SSO، الذي يضمن أن الأشخاص داخل مؤسستنا فقط هم من يستطيعون الوصول إلى هذه البيانات. أما طبقة الحفظ، وهي قاعدة بيانات Postgres بسيطة، فوُجدت فقط لتخزين محادثات المستخدمين، بحيث يستطيع كل مستخدم مراجعة النتائج السابقة وإعادة توليد المخططات عند الحاجة، وما إلى ذلك.
نظرة تقنية معمقة
معمارية متعددة الوكلاء
لكي تتعامل محادثة FinBot مع استعلامات المستخدمين الحقيقيين، لا يمكننا ببساطة تمريرها إلى وكيل SQL يحولها إلى BigQuery SQL. فهذا لن ينجح إلا إذا كان المستخدمون يعرفون كيف تُخزَّن البيانات في مجموعات بياناتنا، وما الأعمدة الموجودة، وما تحتويه.
خذ مدخلًا بسيطًا من المستخدم مثل «أرني كل المشاريع التي عمل عليها John Smith في 2025»: فاحتمال تحوله إلى استعلام SQL صحيح ضئيل، لأسباب عدة. أولًا، لا يوجد في مجموعة البيانات عمود اسمه project(s) – ففي قاعدة بياناتنا تُخزَّن المشاريع في عمود اسمه profit_center (لأسباب تاريخية). ومشكلة أخرى أنه لا يوجد شخص اسمه ‘John Smith’ – لكن هناك شخصًا اسمه ‘Smith John’، يسبق اللقب فيه الاسم الأول – وقد فهمت الصورة.
ويجب أن تكون FinBot أيضًا محادثية. فعندما نطرح سؤال متابعة مثل «وJames Wilson»، عليها أن تتذكر ما سألناه سابقًا، لتتمكن من ملء السياق وبناء الاستعلام الصحيح لنا من هذا الجزء فقط.
وللتعامل مع ذلك بنينا تدفقًا متعدد الوكلاء يحاول حلّ عدة معلومات وجمعها وتسليمها إلى وكيل SQL ليتمكن من إنتاج الاستعلام الأنسب. وفيما يلي وصف للوكلاء المشاركين في سير العمل هذا.
وكيل موجّه الاستعلامات (Query router agent)
المرحلة الأولى من المعالجة هي مصنِّف: فبعض الاستعلامات لا يلزم أن تصل إلى وكيل SQL أصلًا، ويمكننا اختصار مسارها لإعادة النتائج بسرعة أكبر.
يسند وكيل موجّه الاستعلامات نوعًا للاستعلام:
DATA_QUERY– يتطلب تشغيل SQLMETA_QUESTION– يتعلق بنتائج سابقةEXPLANATION_REQUEST– يسأل كيف حُسب شيء ماCLARIFICATION– يعدّل الاستعلام السابقGENERAL– لا يتطلب SQL
وعندما نتعرف، مثلًا، على نوع الاستعلام GENERAL لأن المستخدم يسأل عن الطقس، نتصرف كروبوت محادثة عادي، مثل ChatGPT تمامًا.
ويقرر وكيل موجّه الاستعلامات ما إذا كان حلّ الكيانات (entity resolution) (الذي ينفذه وكيل آخر في التدفق) مطلوبًا، ويستخرج الكيانات الأولية عند الحاجة، ويحدد ما إذا كان لا بد من تجميع البيانات، مقدمًا group_by_hint للتجميعات، وهكذا.
ويجري استخراج الكيانات الأولي على قاعدة معرفة ثابتة هي جزء من داخل FinBot، مثلًا يُترجَم project هنا إلى profit_center؛ أما سيناريوهات الكيانات الأكثر تعقيدًا فيعالجها وكيل حلّ الكيانات (Entity Resolution Agent) عند الضرورة.
مثال على التصنيف:
- المدخل: “Show me direct margins for all projects in 2025”
- المخرج:
{query_type: "DATA_QUERY", group_by_hint: "profit_center", needs_entity_resolution: false}
وكيل حلّ الكيانات (Entity Resolution Agent)
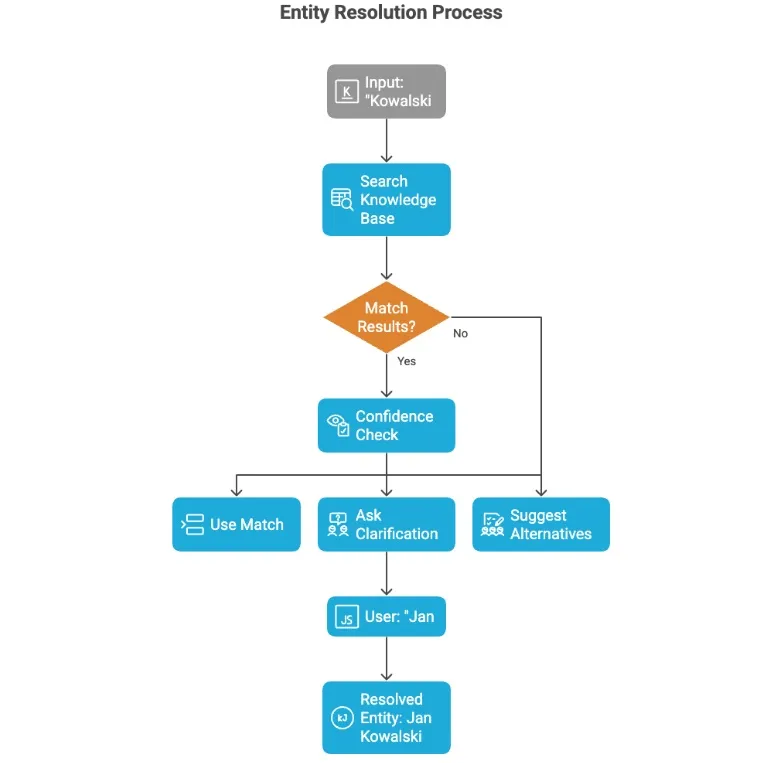
يسدّ وكيل حلّ الكيانات الفجوة بين البيانات التي نخزّنها والبيانات التي يسأل عنها المستخدم. وأسماء الأشخاص مثال مثالي. فقد نسأل عن ‘John Smith’ أو ‘Smith John’ أو ‘Smith’ ببساطة، ونريد ربط كل ذلك بالقيمة المخزَّنة بالضبط في قاعدة البيانات، حتى يُولَّد مرشِّح BigQuery SQL (WHERE person = ‘Smith John’ . والأمر نفسه ينطبق على أسماء المشاريع والتخصصات وأسماء الأقسام وغيرها.
ويجري الوكيل مطابقة تقريبية (fuzzy matching) على قواعد معرفة يبنيها من البيانات نفسها؛ ومن المصادر النموذجية:
- قائمة المتعاقدين من قاعدة البيانات
- أسماء مراكز الربح (المشاريع)
- أسماء النقابات (guilds)
- مجموعات التخصصات
وعندما يتعذر حلّ كيان ما، يقطع هذا الوكيل التدفق ويطرح أسئلة توضيحية حول الغموض. فمثلًا، إذا سألنا عن شخص اسمه ‘John’ لكن هناك عدة سجلات بهذا الاسم الأول، فسيحاول الوكيل معرفة من نقصد بالضبط:
- “Did you mean ‘John Smith’ or ‘John Brown’?”
ينتج الوكيل درجات ثقة، وعندما تنخفض عن عتبة معينة يتوقف سير العمل الخاص بجلب النتائج الفعلية.
وكيل SQL (المحرك الأساسي)
وكيل SQL هو القطعة المركزية في نظام الوكلاء لدينا، إذ يشغّل الاستعلامات الفعلية على Google BigQuery.
وهو create_sql_agent من LangChain من النوع openai-tools. نستخدم نموذج GPT-4o (مع temperature=0 للحتمية) ونبني موجِّه نظام (system prompt) يتضمن:
- توثيق المخطط كاملًا
- سياق الأعمال (معادلات المقاييس والمصطلحات)
- أنماط الاستعلام وأمثلة
- المطابقة الزمنية (Q1-Q4)
- قيود الأمان (SELECT فقط)
ويضيف الوكيل سياقًا مثل (السنة والربع والشهر والقسم) ويحقن سجل المحادثة وتلميحات عن الكيانات التي جرى حلّها.
صممنا الوكيل بحيث يمكن استخلاص استعلام SQL الدقيق من أثر التنفيذ، وهو أمر مهم لبعض المستخدمين النهائيين الذين يريدون التأكد من أن الحسابات أُجريت على البيانات الصحيحة في مخزن بياناتنا.
وكيل مولّد المخططات (Chart Generator Agent)
من أحدث ميزات أداتنا التوليد التلقائي للمخططات لبيانات محددة تُجلَب عبر FinBot . ولدعم ذلك بنينا وكيلًا مساعدًا صغيرًا يأخذ البيانات المجلوبة عند الطلب ويحولها إلى مخططات جميلة المظهر.
يفحص الوكيل نص الاستجابة ويختار تلقائيًا أساليب التصوير المناسبة. وهو يتعامل مع الأعمدة والخطوط والدائرية والحلقية والجداول، وينتج JSON متوافقًا مع Chart.js تستخدمه واجهة FinBot لاحقًا لعرض النتيجة.
تفاصيل هندسة الموجِّهات (Prompt engineering)
حقن سياق الأعمال
كما أشرنا بإيجاز سابقًا، يُثرى استعلام المستخدم بسياق إضافي. وباستخدام الوكلاء نحاول تضمين معلومات لدينا أصلًا من معرفة المجال، مثل:
- مصطلحات قاموس الأعمال
- معادلات المقاييس (مثلًا: margin = (sales - costs) / sales)
- أنماط الاستعلام المتكررة
إلى جانب بعض تعيينات المصطلحات، مثل:
- “revenue” ←
sales_value_PLN - “project” ←
profit_center - “team” ←
guild
بنية موجِّه النظام
يُجمَّع الموجِّه الكامل من العناصر المذكورة أدناه؛ وما يُختار منها ويُسلَّم إلى الوكيل التالي يعتمد على الاستعلام المحدد، وقد يكون كلها أو جزءًا منها فقط:
- تعريف الدور: “You are FinBot, an expert financial analyst…”
- قائمة القدرات
- توثيق الجداول مع أمثلة على الأعمدة
- فهم نموذج البيانات الرئيسي
- إرشادات الاستعلام
- السياق الزمني
- أنماط الاستعلام المتكررة
- قيود الأمان
- تعليمات حول صيغة الاستجابة
تدفق البيانات (من البداية إلى النهاية)
يُظهر المخطط أدناه المسار الكامل من استعلام المستخدم إلى الاستجابة. وإلى جانب المرور عبر تدفق الوكلاء مع LangChain، تُنفَّذ بعض الخطوات الإضافية بشروط، إما لتسريع الأمور (مثلًا عندما يكون السؤال نفسه قد طُرح من قبل) أو لإضافة قدرات مثل إنشاء مخطط من البيانات التي يعيدها مخزن بيانات BigQuery.
حفظ المحادثات
للتيسير، ولمعرفة ما يسأله المستخدمون فعلًا لـ FinBot لدينا، أضفنا طبقة حفظ على شكل قاعدة بيانات Postgres، تتيح لنا تحسين الحل لاحقًا.
يستطيع كل مستخدم مراجعة سجل محادثاته وتوليد مخططات للإجابات السابقة أو التحقق مما كان الاستعلام الفعلي على Google BigQuery. وهذا يوفر مسار تدقيق سيساعدنا على التحسين مستقبلًا، كما يتيح للمستخدمين العودة مباشرة إلى سياقات ومحادثات سابقة.
استراتيجية التخزين المؤقت
لخفض تكاليف استدعاءات LLM، أدخلنا استراتيجية تخزين مؤقت بسيطة قائمة على Redis. وهي تعتمد على مفاتيح تخزين مؤقت بمدة صلاحية (TTL) بسيطة قدرها ساعة واحدة، تُبنى من الاستعلام المطبَّع + السياق، ومهمتها الرئيسية تخزين استعلامات وكلاء حلّ الكيانات مؤقتًا وتمكين معالجة أسئلة المتابعة بوعي بالتخزين المؤقت. ويُبطَل التخزين المؤقت كلما تغير السياق.
التحول
الطريقة الجديدة – استعلامات بلغة طبيعية
أمثلة على التحولات
تفاعل نموذجي
مع FinBot، لا يضطر المستخدمون إلى تعديل الاستعلامات أو كتابتها من الصفر عندما يريدون العثور على عدة معلومات. تواصل المحادثة ببساطة، ويفهم الروبوت سياق الاستعلامات السابقة، فيبني لك الاستعلامات الجديدة تلقائيًا.
- يكتب المستخدم: «كم كلّف تطوير Backend في الربع الثاني من 2025؟»
- تعيد FinBot: «تكاليف تطوير Backend في الربع الثاني من 2025: 125,430 PLN (أبريل: 42,150 PLN، مايو: 48,280 PLN، يونيو: 35,000 PLN)»
- سؤال المتابعة من المستخدم: «أي مشروع كان الأعلى؟»
- FinBot (واعية بالسياق): «كان المشروع Alpha الأعلى في تكاليف تطوير Backend بمبلغ 32,500 PLN»
- الزمن الإجمالي: نحو 10-60 ثانية لكل استعلام
أمثلة حقيقية على الاستعلامات
استعلامات بسيطة
- «ما إجمالي إيراداتنا لعام 2024؟»
- «أرني التكاليف لشهر يناير»
- «اعرض كل المشاريع في 2025»
استعلامات معقدة (أصبحت الآن تافهة)
- «قارن هوامش الربعين الأول والثاني لنقابة Backend»
- «أي التخصصات لديها هوامش سالبة هذا العام؟»
- «أفضل 10 متعاقدين من حيث معدل المبيعات بعملة PLN»
استعلامات متابعة (واعية بالسياق)
- “How about for Q3?” (بعد استعلام عن الربع الثاني)
- “Break that down by month” (بعد استعلام سنوي)
- “What’s their margin?” (بعد قائمة متعاقدين)
حساب توفير الوقت
تخفض أتمتة الاستعلامات الجديدة بشكل كبير الوقت اللازم للتعامل مع طلبات البيانات. فالاستعلام الواحد يستغرق الآن 10-60 ثانية بدلًا من 15-20 دقيقة، أي أن متوسط الانخفاض في الوقت لكل استعلام نحو 97%.
وبالنسبة إلى عضو فريق نموذجي ينفذ 10 استعلامات أسبوعيًا، يعني ذلك توفير نحو 2.3-3.3 ساعة كل أسبوع، أو نحو 2.8 ساعة في المتوسط.
وعلى مستوى المؤسسة (20 شخصًا يستخدمون النظام)، يتراكم التحسن ليصبح مكاسب إنتاجية كبيرة:
- نحو 56 ساعة موفَّرة أسبوعيًا
- نحو 224 ساعة موفَّرة شهريًا
- نحو 2,900 ساعة موفَّرة سنويًا، أي ما يعادل طاقة نحو 1.4 موظف بدوام كامل تم استردادها.
وتُظهر هذه الأرقام أن حتى التحسينات المتواضعة لكل استعلام تتراكم لتصبح مكاسب كفاءة كبيرة على مستوى المؤسسة كلها.
الاعتماد والنتائج
استراتيجية الإطلاق
كما هو الحال مع منتجات جديدة كثيرة، اخترنا إطلاقًا على مراحل لحماية جودة تجربة المستخدم (UX) وتقليل المخاطر وجمع الملاحظات قبل التوسع. وفي حالة FinBot كان من المهم بوجه خاص تجربة المعمارية متعددة الوكلاء أولًا مع مجموعة صغيرة من المستخدمين الخبراء (فريق المالية، وقبل كل شيء رئيسه).
وكان من الأهداف المبكرة التحقق من صحة SQL الذي ينتجه وكيل SQL. نعرض استعلامات SQL هذه كاملةً إلى جانب نافذة FinBot (في النسخة المعتمدة على الويب) ليسهل الوصول إليها.
ومن المجالات الرئيسية الأخرى للاختبار حلّ الكيانات (خاصة للأسماء والمشاريع والتخصصات والأقسام وغيرها). وكان لا بد من فحصه في سيناريوهات كثيرة (أخطاء إملائية، وترتيبات مختلفة، وكلمات جزئية، وغيرها).
وشملت المراحل التالية ما أسميناه «إطلاق المديرين»، الذي أدخل أشخاصًا آخرين من أقسام أخرى، مثل المبيعات أو التسويق، لتجربة FinBot ومنحنا مزيدًا من الرؤية حول الاستعلامات التي تهمهم، وهكذا.
وجاء الإطلاق على المؤسسة بأكملها أخيرًا، وتطلّب بعض التحضير من فريق التطوير، مثل تسجيل عرض تجريبي يشاهده المستخدمون ويتعلمون منه، والتأكد من عمل Google SSO في أرجاء الشركة، وصقل واجهة المستخدم وتجربتها (UI/UX) للحصول على تجربة نهائية أفضل.
المقاييس التي نظرنا فيها
لمعرفة كيف استُخدمت FinBot وأين قدّمت أكبر قيمة، بدأنا بجمع حفنة من مقاييس الاستخدام والأداء البسيطة. ولم يكن المقصود منها أن تكون تحليلات شاملة، بل وسيلة للتحقق مما إذا كانت الأداة حلّت فعلًا المشكلات الموصوفة أعلاه وكيف أدّت تحت حمل واقعي.
مقاييس الاستخدام
- عدد الاستعلامات يوميًا/أسبوعيًا
نما حجم الاستعلامات مع ازدياد ثقة المستخدمين غير التقنيين في طرح أسئلة أكثر تعقيدًا. ولاحظنا أنماطًا متكررة، مثل ذروات حول إقفال نهاية الشهر وأثناء مراجعات ربحية المشاريع. وأكّد ذلك افتراضنا أن كثيرين ابتعدوا عن استكشاف البيانات لمجرد أن SQL كان يقف في طريقهم.
- أكثر أنواع الاستعلامات شيوعًا
وقعت معظم الأسئلة في حفنة من الفئات:
- الربحية على مستوى المشروع
- الإيرادات والتكاليف والهوامش لنطاق زمني محدد
- مقاييس على مستوى الأشخاص والنقابات
- مقارنات بين الفترات (الربع الأول مقابل الثاني، سنة بسنة)
وتطابقت هذه تقريبًا تمامًا مع نقاط الألم التي وصفناها في الأقسام السابقة.
- متوسط زمن الاستجابة
ظلت أزمنة الاستجابة بثبات ضمن نطاق 10–60 ثانية، بحسب مدى تعقيد السؤال وما إذا كانت النتيجة قد قُدّمت من التخزين المؤقت. وبالمقارنة مع سير العمل القديم الذي كان يستغرق 15–20 دقيقة، لمس المستخدمون التحسن لحظة تجربتهم.
ملاحظات نوعية
- لم يعد المستخدمون يعتمدون على الأشخاص «القادرين على SQL»
كان من أبرز التحولات الثقافية توقف الأسئلة الروتينية الموجهة إلى فريق المالية أو المهندسين. فالأشخاص الذين اعتادوا تجنب BigQuery تمامًا بدؤوا يجرون تحليلاتهم بأنفسهم.
- القرارات تُتخذ أسرع
قال مديرو المشاريع (PMs) إن الاستعداد لمحادثات العملاء أصبح أسرع بكثير. وصار بإمكان المالية التحقق من الهوامش أو الميزانيات أثناء الاجتماعات بدلًا من انتظار أحدهم ليسلّم نتائج SQL.
- يحب الناس التدفق المحادثي
بدت أسئلة المتابعة مثل “…and for Q3?” أو “Please, break it down by month” طبيعية، وأزالت عناء إعادة كتابة استعلامات كاملة أو التنقل في وحدة تحكم BigQuery.
وإجمالًا، أظهرت المقاييس والملاحظات أن FinBot لم تعمل تقنيًا فحسب – بل غيّرت الطريقة التي يتعامل بها الناس مع البيانات المالية كل يوم.
التحديات التقنية والحلول
ظهر بعض التحديات التي واجهناها في ثنايا هذا المقال، إذ شكّلت قراراتنا المعمارية بقوة عبر دورات التطوير. ومع ذلك، أسرد أدناه أهمها، مع وصف موجز لكل مشكلة وشرح لكيفية حلّها.
التحدي: أسماء كيانات ملتبسة
هذه هي المشكلة الأكثر تكرارًا وتؤثر في غالبية الاستعلامات. فالمستخدمون لا يعرفون كيف تبدو البيانات في مجموعة بيانات BigQuery لدينا، لذا إذا بنى وكيل SQL استعلامًا يحتوي person = "Brown" فلن يعيد شيئًا. والمشكلة أن “Brown” قد يطابق عدة أشخاص: فقد يكون هناك “Michael Brown” أو “Brown Michael”، أو ربما شخص هو في الحقيقة “Browne” لكننا نسميه “Brown” – ولم لا.
وكما ذُكر مرات عدة أعلاه، حللنا ذلك بوكيل حلّ الكيانات. فهو يجري مطابقة تقريبية بدرجات ثقة على البيانات التي نحتفظ بها لكيانات معينة؛ فإذا وجد سجلًّا بثقة كافية مرّره كسياق إضافي أبعد في خط المعالجة، وإن لم يجد فيمكنه أن يطلب من المستخدم توضيح ما قصده بكيان معين.
التحدي: استعلامات زمنية معقدة
ظهرت مشكلة أخرى مثيرة للاهتمام حين بدأنا نستخدم FinBot مثل روبوتات المحادثة التي يعرفها الجميع (مثل ChatGPT أو Claude): تطرح أسئلة متابعة ببساطة دون التفكير كثيرًا في كيفية تحويل الواجهة الخلفية لها إلى استعلام SQL حقيقي على مجموعة بيانات BigQuery. فقد تسأل عن بيانات ما للربع الثالث من 2025 ثم تضيف فقط «والربع الثاني»، وعلى الروبوت أن يفهم ما تقصده.
وللتعامل مع ذلك بنينا ContextManager يستخرج السياق الزمني عند الحاجة ويجمّع سياقًا أكبر وأغنى لوكيل SQL باستخدام بيانات مخزَّنة مؤقتًا لجلسة المستخدم.
التحدي: الأداء
يأتي نظام وكلاء FinBot لدينا مع بعض نقاط الألم والاختناقات التي علينا التعامل معها. بعضها ناتج عن استدعاءات LLM العادية (بسياق كبير واستعلام نظام وغيرها).
والمشكلة الأكبر تكمن في إمكانات مجموعة البيانات ومدى سرعة إجابة Google BigQuery عن استعلامات sql. ففي الاستعلامات المعقدة يستهلك ذلك معظم زمن الطلب والاستجابة الذي يشكّل تجربة المستخدم الكلية. ونخفف المشكلتين إلى حد ما بالتخزين المؤقت والمعالجة غير المتزامنة حيثما أمكن، لكن تذكّر أنك لن تكون أسرع من مصدر بياناتك أبدًا، لذا تبقى المشكلة ما دمنا نستخدم BigQuery.
خارطة الطريق المستقبلية
FinBot إضافة حديثة إلى محفظة تطبيقاتنا الداخلية، ونجمع حاليًا إحصاءات ومعلومات أخرى عن كيفية استخدام الناس لها، وما ينقصهم، وما يودون رؤيته في الإصدارات القادمة. ومن التحسينات المقترحة:
- التنبؤ بالاتجاهات والتوقعات
- التصدير إلى Excel/PDF
- تقارير وتنبيهات مجدولة
- إدارة لوحات المعلومات
اعتبارات التوسع
ستنمو قدرات FinBot بشكل كبير عندما نضيف مصادر بيانات وميزات أخرى مثل مراقبة العملات وأسعار الصرف وبيانات المحاسبة غير المرتبطة بالمشاريع. وليس إضافتها صعبًا، لكن كلًّا منها يجلب طبقة معرفة أخرى لروبوتنا، ويجب أن يختبر هذه الطبقات عدد أكبر من الأشخاص ذوي المعرفة الأعمق بالمجال في المناطق ذات الصلة، وهكذا.
وإلى جانب مصادر البيانات الإضافية، سيكون من المفيد أيضًا دمج الروبوت مع أنظمة أخرى نستخدمها، مثل ERP أو البرمجيات المالية التي تستخدمها أقسام مختلفة. لكن ذلك المستقبل غير مؤكد جدًا وقت كتابة هذا المقال، بحيث يمكننا تركه جانبًا الآن.
الخلاصة
تُظهر FinBot جيدًا كيف يمكنك فتح بياناتك لجمهور أوسع عبر استعلامات بلغة طبيعية. فهي تعتمد على معمارية متعددة الوكلاء لمعالجة متخصصة، وتضيف عدة طبقات تساعد على إدارة تعقيد النظام وحلّ الكيانات وتوضيح أسئلة المستخدمين والاستجابة بسرعة.
وإضافة مزيد من مصادر البيانات والتكاملات إلى FinBot ليست صعبة، لكن في مشاريع كهذه يبدأ العمل الحقيقي باختبار النتائج وفائدتها.
كيف يمكننا مساعدتك
إذا كانت مؤسستك تعاني من بطء الوصول إلى البيانات أو سير عمل SQL معقد أو الاعتماد على مجموعة صغيرة من الخبراء، فإن نظام وكلاء مثل FinBot يمكن أن يمنح فرقك تحليلات ذاتية الخدمة حقيقية.
في شركتنا نساعد الشركات على تصميم وبناء مساعدين مخصصين بالذكاء الاصطناعي مصمَّمين وفق مصادر بياناتها ومفرداتها التجارية ومتطلبات الأمان لديها.
وسواء كنت تتطلع إلى إنشاء واجهة بلغة طبيعية لـ BigQuery أو ERP أو أي مجموعة بيانات داخلية، يمكننا دعمك طوال الطريق من الفكرة مرورًا بالمعمارية والتنفيذ وصولًا إلى الإطلاق. تواصل معنا لنتحدث عن كيف يمكننا المساعدة في تحويل بياناتك إلى رؤى فورية.