Երկար ճանապարհ. ինչպես է մեքենան մեկնաբանում բայթկոդը
Խորքային հայացք այն մասին, թե ինչպես է JVM-ը մեկնաբանում և կոմպիլացնում Java բայթկոդը JIT կոմպիլյացիայի մի քանի մակարդակներով՝ ինտերպրետատորից մինչև C1 և C2 կոմպիլյատորներ։ Իմացեք, թե ինչպես են այս մեխանիզմները բարձրացնում հավելվածի արտադրողականությունն ու արդյունավետությունը։
Ես նախկինում լսել էի, որ JIT (Just In Time) կոմպիլյատորը կարող է բայթկոդը կոմպիլացնել մի քանի մակարդակներով, բայց երբեք իսկապես չէի մտածել, թե դա գործնականում ինչ է նշանակում։ Հոկտեմբերի կեսերին մասնակցեցի մի կոնֆերանսի և հնարավորություն ունեցա լսել ‘lock-free programming’-ի մասին զեկույց։ Այդ զեկույցում խոսողները համառոտ անդրադարձան JVM-ի ներքին կառուցվածքին, ինչը ինձ ցանկություն առաջացրեց թեման ավելի խորը ուսումնասիրել։ Քանի որ ուրիշներին ինչ-որ բան բացատրելը լավագույն միջոցներից մեկն է ստուգելու՝ արդյոք իսկապես հասկանում ես այն, որոշեցի գրել այս հոդվածը։
Աստիճանավոր կոմպիլյացիա (Tiered compilation)
Java-ի և C++-ի նման լեզուների միջև առանցքային տարբերությունը կայանում է նրանում, թե ինչպես են դրանք կոմպիլացվում։ C++ կոմպիլյատորը կոդը ուղղակի վերածում է մեքենայական կոդի, որը CPU-ն կարող է կատարել։ Java-ն, ընդհակառակը, իր կոդը կոմպիլացնում է միջանկյալ ձևաչափի, որը կոչվում է բայթկոդ։ CPU-ն չի կարող այս բայթկոդը ուղղակի կատարել. այն լրացուցիչ մշակում է պահանջում։ JVM-ը այն հավելվածն է, որը այս բայթկոդը վերածում է մեքենայական կոդի, որպեսզի CPU-ն կարողանա այն կատարել։
Հիշեք, որ կոդը, որ գրում ենք ցանկացած JVM-համատեղելի լեզվով, ծառայում է որպես բաղադրատոմս, որը նկարագրում է, թե ինչպես ենք ուզում, որ մեր ծրագիրը աշխատի։
JVM-ը կարող է մեր բայթկոդը կոմպիլացնել հինգ տարբեր մակարդակներով։ Ահա պատկեր, որը դա ցույց է տալիս.
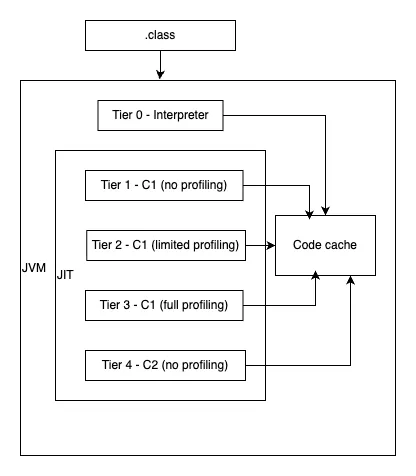
Մակարդակների տարբերությունը ցույց տալու համար որպես օրինակ կօգտագործեմ շատ պարզ մեթոդ։
Բայթկոդ (.class)
Ահա Java-ում սահմանված մեթոդը.
private static int resolveNumber(int i) {
    if (i < 20000) return i;
    else return i * 2;
}
Երբ այն կոմպիլացվում է, ստացված բայթկոդը կարող ենք ստուգել այս հրամանով.
javap -c -p target/classes/org/zygiert/Main.class- javap-ը Java Class File Disassembler-ն է, որը մատակարարվում է JDK-ի հետ։
- -c տարբերակը տպում է դիզասեմբլացված կոդը։
- -v տարբերակը ստիպում է, որ private մեթոդները նույնպես երևան (այս հատվածը Main դասի մի մասն է)։
Ստացված բայթկոդը JVM գործողության կոդերի հաջորդականություն է, որը նկարագրում է, թե որ գործողությունները պետք է կատարվեն։ Սա մեթոդի բայթկոդային ներկայացումն է.
         0: iload_0
         1: sipush        20000
         4: if_icmpge     9
         7: iload_0
         8: ireturn
         9: iload_0
        10: iconst_2
        11: imul
        12: ireturn
Ահա թե ինչ է իրականում տեղի ունենում.
iload_0-ն լոկալ փոփոխականից ամբողջ թիվ է դնում stack-ի վրա։sipush-ը stack-ի վրա դնում է20000կարճ ամբողջ թիվը։if_icmpge-ը համեմատում է երկու ամբողջ արժեքները։ Երբ առաջին ամբողջ թիվը մեծ է կամ հավասար20000-ի, այն անցնում է 9 բայթ շեղման (offset) վրա գտնվող հրահանգին։ Հակառակ դեպքում կատարումը շարունակվում է հաջորդ հրահանգով։
Երբ ամբողջ թիվը փոքր է 20000-ից.
iload_0-ն պարամետրը կրկին դնում է stack-ի վրա։ireturn-ը stack-ից վերադարձնում է ամբողջ թիվը։
Երբ ամբողջ թիվը մեծ է կամ հավասար 20000-ի.
iload_0-ն պարամետրը կրկին դնում է stack-ի վրա։iconst_2-ը stack-ի վրա դնում է2հաստատուն ամբողջ թիվը։imul-ը բազմապատկում է stack-ի վերևի երկու ամբողջ թվերը և արտադրյալը թողնում stack-ի վրա։ireturn-ը stack-ից վերադարձնում է ստացված ամբողջ թիվը։
Արագ պարզաբանում. ձախ կողմի թվերը հրահանգների համարներ չեն, այլ բայթ շեղումներ։ Օրինակ՝ 0 բայթ շեղման վրա գտնվող iload_0 հրահանգը իր գործողության կոդի համար վերցնում է ընդամենը 1 բայթ։ Ահա թե ինչու sipush գործողության կոդը գալիս է անմիջապես դրանից հետո՝ 1 բայթ շեղման վրա։ sipush հրահանգը վերցնում է 3 բայթ. 1-ը՝ գործողության կոդի համար, և ևս 2-ը՝ stack-ի վրա դրվող կարճ ամբողջ թվի համար։ Ահա թե ինչու if_icmpge գործողության կոդը գտնվում է 4 բայթ շեղման վրա։
Սրանք հասանելի բայթկոդային գործողության կոդերից միայն մի քանիսն են։ Ամբողջական ցանկը գտնվում է JVM specification-ում։ Սակայն հիշեք, որ սա ընդամենը մեր կոդի միջանկյալ ներկայացումն է, որը դեռ պետք է վերածվի մեքենայական կոդի։ Դա ինտերպրետատորի գործն է։
Ինտերպրետատոր (Interpreter)
Այսօր JVM-ը հենվում է template ինտերպրետատորի վրա, որը հավելվածի մեկնարկի ժամանակ յուրաքանչյուր բայթկոդային հրահանգ վերածում է մեքենայական կոդի։ Սա տեղի է ունենում հավելվածի յուրաքանչյուր գործարկման ժամանակ։ Երբ հավելվածը սկսվում է, template ինտերպրետատորը յուրաքանչյուր բայթկոդային հրահանգի համար արտադրում է բնիկ կոդ՝ հաշվի առնելով այնպիսի գործոններ, ինչպիսիք են CPU ճարտարապետությունը և հիմքում ընկած օպերացիոն համակարգը։ Այնուհետև բնիկ կոդը պահվում է code cache-ում։
Տեսնելու համար, թե որքան ժամանակ է տևում բնիկ կոդի գեներացիան, գործարկեք այս հրամանը.
java -Xlog:startuptime -jar target/app.jar 10Տպված լոգը կպարունակի այսպիսի մի տող.
[0.019s][info][startuptime] Interpreter generation, 0.0014898 secsԱկնհայտ է, որ ինտերպրետատորի գեներացումը բավականին արագ է։
Այդ պահից JVM-ն ունի կոմպիլացված բնիկ կոդ՝ կապված յուրաքանչյուր բայթկոդային հրահանգի հետ։ Այսպես, երբ մեթոդը աշխատում է այս վիճակում, JVM-ը անցնում է բայթկոդով և յուրաքանչյուր հրահանգի համար կատարում է համապատասխան բնիկ կոդը։ Սա թույլ է տալիս մեր հավելվածին բավականին արագ սկսել, բայց ամենաարդյունավետ մոտեցումը չէ։
Ինտերպրետատորի արտադրած բնիկ կոդը ստուգելու համար գործարկեք այս հրամանը.
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintInterpreter -jar target/app.jar 10Ելքը երկար է, բայց բնիկ կոդի յուրաքանչյուր մաս պիտակավորված է իր գործողության կոդի անունով, ուստի ձեզ անհրաժեշտը գտնելը ավելի հեշտ է։ Ահա որպես օրինակ iload_0 գործողության կոդը.
iload_0  26 iload_0  [0x000071666f9465e0, 0x000071666f946628]  72 bytes
[MachCode]
  0x000071666f9465e0: 4883 ec08 | c5fa 1104 | 24eb 1f48 | 83ec 10c5 | fb11 0424 | eb14 4883 | ec10 4889 | 0424 48c7
  0x000071666f946600: 4424 0800 | 0000 00eb | 0150 418b | 0641 0fb6 | 5d01 49ff | c549 ba80 | 1237 8666 | 7100 0041
  0x000071666f946620: ff24 da0f | 1f44 0000
[/MachCode]
Արժե նաև նշել, որ JDK-ն դեռ պարունակում է C++ ինտերպրետատոր, թեև JDK-ի ժամանակակից տարբերակները այն լռելյայն չեն օգտագործում։
C1 կոմպիլյատոր
C1 կոմպիլյատորը, որը կոչվում է նաև client կոմպիլյատոր, JIT կոմպիլյացիայի գործընթացի մասն է։ Այն միանում է, երբ JVM-ի պրոֆիլավորման մեխանիզմը նկատում է, որ որոշ մեթոդներ հաճախ են աշխատում։ C1 կոմպիլյատորը աշխատում է երեք տարբեր մակարդակներով։
Մակարդակ 1
Այս մակարդակը նախատեսված է չնչին մեթոդների համար, ինչպիսիք են getter-ները, setter-ները կամ հաստատուն արժեքներ վերադարձնող մեթոդները։ Նման մեթոդները հետագայում օպտիմիզացնելով ոչինչ չես շահի։ Այս մակարդակում պրոֆիլավորման տվյալներ չեն հավաքվում, քանի որ դրանք անհրաժեշտ չեն։
Մակարդակ 2
Այս մակարդակում կոմպիլյատորը հենվում է մեթոդի մասին հիմնական պրոֆիլավորման տեղեկատվության վրա։ Դրա պատճառով կոմպիլացված մեթոդը ավելի փոքր է, քան Tier 3-ում կոմպիլացվածը։ Սովորաբար, երբ JVM-ը նկատում է, որ մեթոդը hot է, այն կոմպիլացնում է Tier 3-ի, իսկ հետո՝ Tier 4-ի։
Արժե բացատրել, թե ինչն է մեթոդը դարձնում hot։ Մեթոդը hot կարող է դառնալ երկու եղանակով.
- Դրա կանչերի քանակը գերազանցում է
TierXInvocationThreshold-ը՝ բազմապատկածCompileThresholdScaling-ով։ - Դրա կանչերի քանակը գերազանցում է
TierXMinInvocationThreshold-ը՝ բազմապատկածCompileThresholdScaling-ով, և դրա կանչերի քանակը գումարած ներսում ցիկլի իտերացիաների քանակը գերազանցում էTierXCompileThreshold-ը՝ բազմապատկածCompileThresholdScaling-ով։
Եթե Tier 4 կոմպիլյացիայի հերթը չափազանց երկար է, սակայն, սպասելը կարող է չարդարացնել իրեն։ Դրան գումարած՝ մեթոդը Tier 3-ում կոմպիլացված թողնելը կարող է անարդյունավետ լինել լրացուցիչ պրոֆիլավորման տվյալներից առաջացող լրացուցիչ չափի և բարդության պատճառով։ Այս իրավիճակներում մեթոդը կարող է նորից կոմպիլացվել Tier 2-ի, իսկ ավելի ուշ՝ կրկին Tier 3-ի և ապա Tier 4-ի։
Մակարդակ 3
Երբ մեթոդը ճանաչվում է որպես hot, այն սովորաբար կոմպիլացվում է Tier 3-ի, որը կրում է լրիվ պրոֆիլավորման տվյալներ։ Այս մակարդակը հաճախ ընդամենը միջանկյալ քայլ է Tier 4-ի ճանապարհին։ Ինչպես վերևում նշվեց, սակայն, որոշ դեպքերում մեթոդը կարող է կոմպիլացվել Tier 2-ի՝ անմիջապես Tier 4-ի անցնելու փոխարեն։
Կոմպիլացված կոդի մանրամասների ստուգում
Ավելի վաղ ասացի, որ C1 կոմպիլյատորով կոմպիլացված մեթոդները տարբերվում են չափով և այն բանով, թե որքան պրոֆիլավորման տվյալներ են ստանում։ Այժմ տեսնենք դա գործնականում։
JVM-ին կոմպիլյացիան տվյալ մակարդակում դադարեցնելու և մեթոդի կոմպիլյացիայի մասին տեղեկատվություն տպելու համար կարող եք թիրախավորել C1 մակարդակը այս հրամանով.
java -XX:+PrintCompilation -XX:TieredStopAtLevel=1 -jar target/app.jar 15000-XX:+PrintCompilation-ը միացնում է կոմպիլյացիայի մանրամասների տպումը։-XX:TieredStopAtLevel=1-ը JVM-ին ասում է կոմպիլյացիան դադարեցնել Tier 1-ում։
Թվարկված մեթոդների մեջ կտեսնեք resolveNumber մեթոդը.
46 20 1 org.zygiert.Main::resolveNumber (13 bytes)46-ը ծրագրի մեկնարկից անցած ժամանակն է միլիվայրկյաններով։20-ը կոմպիլյացիայի ID-ն է։1-ը կոմպիլյացիայի մակարդակն է (Tier)։org.zygiert.Main::resolveNumber-ը մեթոդի ստորագրությունն է։(13 bytes)-ը ցույց է տալիս բայթկոդի չափը։
Այժմ, երբ ստիպեցինք C1 կոմպիլյատորին մեր մեթոդը կոմպիլացնել Tier 1-ի, հաջորդ քայլը նայելն է այն բնիկ կոդին, որն իրականում արտադրվել է դրա համար, գումարած մի քանի լրացուցիչ մանրամասներ։ Դրա համար կօգտագործեմ երկու JVM տարբերակ.
-XX:+UnlockDiagnosticVMOptions, որը միացնում է JVM-ի ախտորոշիչ տարբերակները։-XX:+PrintAssembly, որը տպում է բնիկ կոդը։
Ահա ամբողջական հրամանը.
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly -XX:TieredStopAtLevel=1 -jar target/app.jar 15000Ելքը մեծ է, բայց դրա մեջ կարող եք գտնել resolveNumber մեթոդը։ Ահա թե ինչ տեսք ունի տպված մանրամասների սկիզբը.
Compiled method (c1) 122   20       1       org.zygiert.Main::resolveNumber (13 bytes)
 total in heap  [0x0000719a289a3888,0x0000719a289a3a60] = 472
 main code      [0x0000719a289a3980,0x0000719a289a3a28] = 168
 stub code      [0x0000719a289a3a28,0x0000719a289a3a58] = 48
 oops           [0x0000719a289a3a58,0x0000719a289a3a60] = 8
 mutable data [0x00007199d8024530,0x00007199d8024568] = 56
 relocation     [0x00007199d8024530,0x00007199d8024560] = 48
 metadata       [0x00007199d8024560,0x00007199d8024568] = 8
 immutable data [0x00007199d80244b0,0x00007199d8024520] = 112
 dependencies   [0x00007199d80244b0,0x00007199d80244b8] = 8
 scopes pcs     [0x00007199d80244b8,0x00007199d8024508] = 80
 scopes data    [0x00007199d8024508,0x00007199d8024520] = 24
Այն, ինչ հիմա ինձ ամենաշատն է հետաքրքրում, total in heap-ն է։ Հատկության անունը կարող է խաբուսիկ լինել, բայց այն իրականում ցույց է տալիս, թե որքան code cache հիշողություն է զբաղեցնում այս կոմպիլացված մեթոդը։ Այստեղ ընդհանուր չափը 472 բայթ է, մինչդեռ մեթոդի իրական իրականացումը զբաղեցնում է 168 բայթ։
Այնուհետև նույնը կարող ենք անել Tier 2-ի և Tier 3-ի համար։ Ելքը բաց կթողնեմ, բայց ահա չափերը յուրաքանչյուր մակարդակի համար։
| Tier 1 | Tier 2 | Tier 3 | |
|---|---|---|---|
| ընդհանուր չափ | 472 | 536 | 576 |
| հիմնական կոդի չափ | 168 | 232 | 272 |
Այս թվերը ցույց են տալիս, թե ինչու է Tier 3-ից Tier 4 չկոմպիլացվող մեթոդը ետ ընկնում Tier 2։ Սահմանափակ պրոֆիլավորման տվյալների շնորհիվ այն ավելի փոքր է։
C2 կոմպիլյատոր
Սա կոմպիլյացիայի վերջին փուլն է, որտեղ հայտնվում են hot մեթոդները։ Այն հաճախ կոչվում է server կոմպիլյատոր և կիրառում է մի շարք ագրեսիվ օպտիմիզացիաներ, ինչպիսիք են branch prediction-ը, վեկտորիզացիան և ցիկլերի բացումը (loop unrolling)։
Այս օպտիմիզացիաներից շատերը հիմնված են կանխատեսումների վրա։ Այլ կերպ ասած, պրոֆիլավորման տվյալների միջոցով JVM-ը ենթադրում է, որ մեթոդը կաշխատի այնպես, ինչպես նախկինում։ Այս ենթադրությունը, սակայն, միշտ չէ, որ ճիշտ է լինում։ Երբ ճիշտ չէ, JVM-ը նկատում է անհամապատասխանությունը և այդ մեթոդի համար վերադառնում է մեկնաբանվող կոդին։ Այնուհետև մեթոդի պրոֆիլավորման տվյալները նորից են հավաքվում, և կոմպիլյացիայի ամբողջ ցիկլը կարող է սկսվել նորից։
Ինչպես նշվեց նախկինում, C2-ով կոմպիլացված մեթոդները խիստ օպտիմիզացված են և պրոֆիլավորման տվյալներ չեն կրում։ Մանրամասները տեսնելու համար գործարկեք այս հրամանը.
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly -XX:-BackgroundCompilation -jar target/app.jar 15000Այս հրամանը ավելացնում է տարբերակը.
-XX:-BackgroundCompilation, որը JIT կոմպիլյատորին ստիպում է մեթոդները կոմպիլացնել սինխրոն, ֆոնային ռեժիմի փոխարեն։ Ինձ այս տարբերակը պետք էր, քանի որ իմ ծրագիրը շատ արագ է ավարտվում, և առանց դրա կոմպիլյացիան կարող էր չավարտվել ծրագրի դուրս գալուց առաջ։
Դրանով կարող ենք ընդլայնել ավելի վաղ բերված աղյուսակը՝ ավելացնելով resolveNumber մեթոդի C2-ով կոմպիլացված տարբերակը։
| Tier 1 | Tier 2 | Tier 3 | Tier 4 | |
|---|---|---|---|---|
| ընդհանուր չափ | 472 | 536 | 576 | 392 |
| հիմնական կոդի չափ | 168 | 232 | 272 | 112 |
C2 կոմպիլյացիան տալիս է ամենափոքր կոմպիլացված մեթոդը, ինչը ցույց է տալիս, որ C2-ը իրական օգուտներ է բերում նույնիսկ պարզ մեթոդների համար։ Սակայն նրա հիմնական թերությունն այն է, որ արժե ժամանակ և ռեսուրսներ։
Նկատի ունեցեք, որ -XX:CICompilerCount տարբերակը թույլ է տալիս վերահսկել, թե JIT կոմպիլյատորը քանի թել է օգտագործում։ Կա նաև -XX:CICompilerCountPerCPU անունով տարբերակ։ Երբ այն միացված է, JVM-ը ավտոմատ կերպով որոշում է JIT կոմպիլյատորի թելերի քանակը՝ ելնելով հասանելի CPU միջուկների քանակից։ Օրինակ՝ 4 միջուկանի CPU-ի վրա կարող եք սպասել C2 կոմպիլյատորի համար 2 թել, իսկ C1 կոմպիլյատորի համար՝ 1 թել։
Գոյություն ունեն նաև մի քանի տարբերակներ կոմպիլյացիայի յուրաքանչյուր մակարդակի շեմերը վերահսկելու համար։ Դրանք մանրամասն չեմ նկարագրի, բայց կարող եք թվարկել այս հրամանով.
java -XX:+PrintFlagsFinal | grep TierCode cache
Կա ևս մեկ մաս, որը կցանկանայի ներկայացնել՝ code cache-ը։ Կոդը կոմպիլացվելուց հետո այն պետք է պահվի հեշտ հասանելի տեղում։ Լռելյայն code cache-ը բաժանված է երեք հատվածի.
- JVM internal (non-method) code – այս հատվածը պահում է մեկնաբանվող կոդը, որը cache-ում մնում է մշտապես։ Դրա չափը կարելի է սահմանել
-XX:NonProfiledCodeHeapSizeտարբերակով։ - Profiled-code – այս հատվածը պարունակում է C1 կոմպիլյատորի արտադրած թեթևակի օպտիմիզացված կոդը և կարճատև է։ Դրա չափը կարելի է սահմանել
-XX:ProfiledCodeHeapSizeտարբերակով։ - Non-profiled code – այս հատվածը պահում է C2 կոմպիլյատորի արտադրած լիովին օպտիմիզացված կոդը։ Դրա չափը կարելի է վերահսկել
-XX:NonNMethodCodeHeapSizeտարբերակով։
Կան նաև code cache-ի հետ կապված մի քանի այլ JVM տարբերակներ, որոնք կարող են օգտակար լինել.
-XX:InitialCodeCacheSize-XX:ReservedCodeCacheSize-XX:CodeCacheExpansionSize-XX:+PrintCodeCache
Եզրակացություն
Այս բլոգ գրառման մեջ իմ նպատակն էր բացատրել բայթկոդը բնիկ կոդի վերածելու հիմքում ընկած հիմնական հասկացությունները։ Գործընթացը շատ դինամիկ է և խիստ կարգավորելի։ Այն իրոք պահանջում է զգալի ժամանակ և ռեսուրսներ, բայց ժամանակի ընթացքում կարող է մեծապես բարելավել մեր ծրագրերի արտադրողականությունը։
Այս հոդվածի բոլոր օրինակները գործարկվել են Ubuntu 24.04.3 LTS, x86_64-ի վրա՝ OpenJDK Runtime Environment Temurin-25+36 (build 25+36-LTS)-ով։ Հուսով եմ՝ այս հոդվածը ձեզ ավելի հստակ պատկերացում է տալիս, թե ինչպես է JVM-ը արտադրում բնիկ կոդ։