طريق طويل – كيف ينتهي الأمر بالآلة إلى تفسير البايت كود
نظرة معمّقة على كيفية قيام JVM بتفسير بايت كود Java وتصريفه عبر عدة مستويات من التصريف الفوري (JIT)، بدءًا من المفسِّر مرورًا بمصرِّفَي C1 وC2. اكتشف كيف تعزّز هذه الآليات أداء التطبيقات وكفاءتها.
كنت قد سمعت من قبل أن مصرِّف JIT (Just In Time) قادر على تصريف البايت كود على عدة مستويات، لكنني لم أفكر يومًا فيما يعنيه ذلك عمليًا. في منتصف أكتوبر، حضرت مؤتمرًا وأتيحت لي فرصة الاستماع إلى محاضرة عن «البرمجة الخالية من الأقفال» (lock-free programming). وفي تلك المحاضرة، تطرّق المتحدثون بإيجاز إلى الأجزاء الداخلية لـ JVM، مما جعلني أرغب في استكشاف الموضوع أكثر. ولأن شرح شيء ما للآخرين من أفضل الطرق لاختبار ما إذا كنت تفهمه فعلًا، قررت كتابة هذه المقالة.
التصريف المتدرّج
يكمن أحد الفروق الأساسية بين Java ولغات مثل C++ في طريقة تصريفها. فمصرِّف C++ يحوّل الكود مباشرة إلى كود آلة يستطيع المعالج تشغيله. أما Java، فعلى العكس، تصرّف كودها إلى صيغة وسيطة تسمى البايت كود. ولا يستطيع المعالج تشغيل هذا البايت كود مباشرة – فهو يحتاج إلى معالجة إضافية. وJVM هو التطبيق الذي يحوّل هذا البايت كود إلى كود آلة حتى يتمكن المعالج من تنفيذه.
وتذكّر أن الكود الذي نكتبه بأي لغة متوافقة مع JVM يعمل كوصفة تصف كيف نريد أن يعمل برنامجنا.
يستطيع JVM تصريف البايت كود لدينا على خمسة مستويات مختلفة. إليك صورة توضح ذلك:
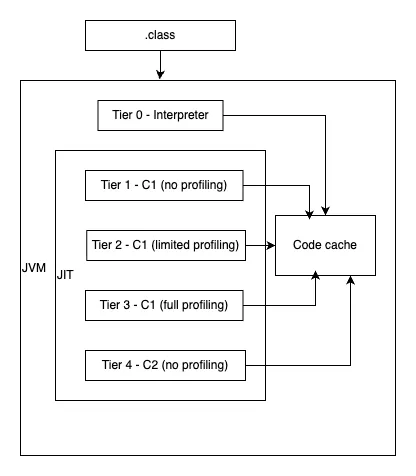
ولتوضيح كيف تختلف المستويات، سأستخدم دالة بسيطة جدًا كمثال.
البايت كود (.class)
إليك الدالة كما هي معرّفة في Java:
private static int resolveNumber(int i) {
    if (i < 20000) return i;
    else return i * 2;
}
بعد تصريفها، يمكننا فحص البايت كود الناتج بهذا الأمر:
javap -c -p target/classes/org/zygiert/Main.class- javap هو مفكّك ملفات أصناف Java (Java Class File Disassembler) المرفق مع JDK.
- الخيار -c يطبع الكود المفكَّك.
- الخيار -v يجعل الدوال الخاصة تظهر أيضًا (هذا المقطع جزء من الصنف Main).
البايت كود الناتج هو سلسلة من رموز عمليات JVM تصف العمليات التي ينبغي تنفيذها. وهذا هو تمثيل البايت كود للدالة:
         0: iload_0
         1: sipush        20000
         4: if_icmpge     9
         7: iload_0
         8: ireturn
         9: iload_0
        10: iconst_2
        11: imul
        12: ireturn
وهذا ما يحدث فعلًا:
- تضع
iload_0عددًا صحيحًا من متغير محلي على المكدّس (stack). - تضع
sipushالعدد الصحيح القصير20000على المكدّس. - تقارن
if_icmpgeالقيمتين الصحيحتين. وعندما يكون العدد الأول أكبر من20000أو مساويًا له، تقفز إلى التعليمة عند الإزاحة 9 بايت. وإلا ينتقل التنفيذ إلى التعليمة التالية.
عندما يكون العدد الصحيح أقل من 20000:
- تضع
iload_0المعامل على المكدّس مرة أخرى. - تعيد
ireturnالعدد الصحيح من المكدّس.
وعندما يكون العدد الصحيح أكبر من 20000 أو مساويًا له:
- تضع
iload_0المعامل على المكدّس مرة أخرى. - تضع
iconst_2الثابت الصحيح2على المكدّس. - تضرب
imulالعددين الصحيحين العلويين في المكدّس وتترك الناتج على المكدّس. - تعيد
ireturnالعدد الصحيح الناتج من المكدّس.
توضيح سريع: الأرقام على اليسار ليست أرقام تعليمات بل إزاحات بالبايت. فمثلًا، تأخذ التعليمة iload_0 عند الإزاحة 0 بايتًا واحدًا فقط لرمز عمليتها. ولهذا يأتي رمز العملية sipush مباشرة بعدها، عند الإزاحة 1. وتأخذ التعليمة sipush 3 بايتات: واحدًا لرمز العملية وبايتين آخرين للعدد الصحيح القصير الذي تضعه على المكدّس. ولهذا يقع رمز العملية if_icmpge عند الإزاحة 4.
هذه ليست سوى حفنة من رموز عمليات البايت كود المتاحة. والقائمة الكاملة في مواصفة JVM. لكن تذكّر أن هذا مجرد تمثيل وسيط لكودنا، ولا يزال يتعين تحويله إلى كود آلة. وهذه مهمة المفسِّر.
المفسِّر
اليوم، يعتمد JVM على مفسِّر قوالب (template interpreter) يحوّل كل تعليمة بايت كود إلى كود آلة عند بدء تشغيل التطبيق. ويحدث هذا في كل مرة يُشغَّل فيها التطبيق. وبمجرد بدء التطبيق، ينتج مفسِّر القوالب كودًا أصليًا لكل تعليمة بايت كود، آخذًا في الاعتبار عوامل مثل معمارية المعالج ونظام التشغيل الأساسي. ثم يُحفظ الكود الأصلي في ذاكرة الكود المؤقتة (code cache).
ولمعرفة الوقت الذي يستغرقه توليد الكود الأصلي، شغّل هذا الأمر:
java -Xlog:startuptime -jar target/app.jar 10سيحتوي السجل المطبوع على سطر مثل هذا:
[0.019s][info][startuptime] Interpreter generation, 0.0014898 secsمن الواضح أن توليد المفسِّر سريع إلى حد كبير.
ومنذ ذلك الحين، يكون JVM قد صرّف كودًا أصليًا مرتبطًا بكل تعليمة بايت كود. لذا عندما تعمل دالة ما في هذه الحالة، يمرّ JVM عبر البايت كود ويشغّل الكود الأصلي المطابق لكل تعليمة. وهذا يتيح لتطبيقنا أن ينطلق بسرعة معقولة، لكنه ليس النهج الأكثر كفاءة.
ولفحص الكود الأصلي الذي ينتجه المفسِّر، شغّل هذا الأمر:
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintInterpreter -jar target/app.jar 10المخرجات طويلة، لكن كل قطعة من الكود الأصلي موسومة باسم رمز عمليتها، مما يسهّل العثور على ما تحتاج إليه. وإليك رمز العملية iload_0 كمثال:
iload_0  26 iload_0  [0x000071666f9465e0, 0x000071666f946628]  72 bytes
[MachCode]
  0x000071666f9465e0: 4883 ec08 | c5fa 1104 | 24eb 1f48 | 83ec 10c5 | fb11 0424 | eb14 4883 | ec10 4889 | 0424 48c7
  0x000071666f946600: 4424 0800 | 0000 00eb | 0150 418b | 0641 0fb6 | 5d01 49ff | c549 ba80 | 1237 8666 | 7100 0041
  0x000071666f946620: ff24 da0f | 1f44 0000
[/MachCode]
ومن الجدير بالذكر أيضًا أن JDK لا يزال يحتوي على مفسِّر C++، رغم أن إصدارات JDK الحديثة لا تستخدمه افتراضيًا.
مصرِّف C1
يُعرف مصرِّف C1 أيضًا بمصرِّف client، وهو جزء من عملية التصريف الفوري. ويبدأ عمله عندما تلاحظ آلية التحليل (profiling) في JVM أن دوال معينة تُنفَّذ بشكل متكرر. ويعمل مصرِّف C1 على ثلاثة مستويات مختلفة.
المستوى 1
هذا المستوى مخصص للدوال البسيطة مثل getters وsetters أو الدوال التي تعيد قيمًا ثابتة. فلا شيء يمكن كسبه من تحسين مثل هذه الدوال أكثر. ولا تُجمع بيانات تحليل في هذا المستوى، لأنها غير مطلوبة.
المستوى 2
في هذا المستوى، يعتمد المصرِّف على معلومات تحليل أساسية عن الدالة. ولهذا تكون الدالة المصرَّفة أصغر من تلك المصرَّفة في المستوى 3. وعادةً، بمجرد أن يلاحظ JVM أن دالة ما hot (ساخنة)، فإنه يصرّفها إلى المستوى 3 ثم بعد ذلك إلى المستوى 4.
من المفيد أن نشرح ما الذي يجعل الدالة ساخنة. هناك طريقتان لتصبح فيهما الدالة ساخنة:
- أن يتجاوز عدد استدعاءاتها
TierXInvocationThresholdمضروبًا فيCompileThresholdScaling. - أن يتجاوز عدد استدعاءاتها
TierXMinInvocationThresholdمضروبًا فيCompileThresholdScaling، وأن يتجاوز عدد استدعاءاتها مضافًا إليه عدد تكرارات الحلقات داخلهاTierXCompileThresholdمضروبًا فيCompileThresholdScaling.
لكن إذا كان طابور التصريف للمستوى 4 طويلًا جدًا، فقد لا يجدي الانتظار نفعًا. وفوق ذلك، قد يكون إبقاء دالة مصرَّفة في المستوى 3 مُهدرًا بسبب الحجم والتعقيد الإضافيين اللذين تأتي بهما بيانات التحليل الإضافية. وفي هذه الحالات، قد تُعاد تصريف الدالة إلى المستوى 2، ثم قد تُصرَّف لاحقًا إلى المستوى 3 مرة أخرى ثم إلى المستوى 4.
المستوى 3
بمجرد التعرف على دالة بوصفها ساخنة، تُصرَّف عادةً إلى المستوى 3، الذي يحمل بيانات تحليل كاملة. وكثيرًا ما يكون هذا المستوى مجرد خطوة وسيطة في الطريق إلى المستوى 4. لكن كما ذُكر أعلاه، قد ينتهي الأمر في بعض الحالات بتصريف الدالة إلى المستوى 2 بدلًا من الانتقال مباشرة إلى المستوى 4.
فحص تفاصيل الكود المصرَّف
ذكرت سابقًا أن الدوال التي يصرّفها مصرِّف C1 تختلف في الحجم وفي كمية بيانات التحليل التي تحصل عليها. لنرَ ذلك عمليًا الآن.
لجعل JVM يتوقف عن التصريف عند مستوى معين ويطبع معلومات عن تصريف الدوال، يمكنك استهداف مستوى C1 بهذا الأمر:
java -XX:+PrintCompilation -XX:TieredStopAtLevel=1 -jar target/app.jar 15000- يشغّل
-XX:+PrintCompilationطباعة تفاصيل التصريف. - يخبر
-XX:TieredStopAtLevel=1الـ JVM بالتوقف عن التصريف عند المستوى 1.
من بين الدوال المدرجة، سترى الدالة resolveNumber:
46 20 1 org.zygiert.Main::resolveNumber (13 bytes)46هو الزمن بالمللي ثانية منذ بدء تشغيل البرنامج.20هو معرّف التصريف.1هو مستوى التصريف.org.zygiert.Main::resolveNumberهو توقيع الدالة.(13 bytes)يعرض حجم البايت كود.
الآن وقد جعلنا مصرِّف C1 يصرّف دالتنا إلى المستوى 1، فإن الخطوة التالية هي النظر في الكود الأصلي المُنتَج فعليًا لها، إضافةً إلى بعض التفاصيل الإضافية. ولذلك سأستخدم خيارين من خيارات JVM:
-XX:+UnlockDiagnosticVMOptions، الذي يفعّل خيارات التشخيص في JVM.-XX:+PrintAssembly، الذي يطبع الكود الأصلي.
وهذا هو الأمر الكامل:
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly -XX:TieredStopAtLevel=1 -jar target/app.jar 15000المخرجات كبيرة، لكن يمكنك العثور فيها على الدالة resolveNumber. وهكذا تبدو بداية التفاصيل المطبوعة:
Compiled method (c1) 122   20       1       org.zygiert.Main::resolveNumber (13 bytes)
 total in heap  [0x0000719a289a3888,0x0000719a289a3a60] = 472
 main code      [0x0000719a289a3980,0x0000719a289a3a28] = 168
 stub code      [0x0000719a289a3a28,0x0000719a289a3a58] = 48
 oops           [0x0000719a289a3a58,0x0000719a289a3a60] = 8
 mutable data [0x00007199d8024530,0x00007199d8024568] = 56
 relocation     [0x00007199d8024530,0x00007199d8024560] = 48
 metadata       [0x00007199d8024560,0x00007199d8024568] = 8
 immutable data [0x00007199d80244b0,0x00007199d8024520] = 112
 dependencies   [0x00007199d80244b0,0x00007199d80244b8] = 8
 scopes pcs     [0x00007199d80244b8,0x00007199d8024508] = 80
 scopes data    [0x00007199d8024508,0x00007199d8024520] = 24
ما يهمني أكثر الآن هو total in heap. قد يكون اسم الخاصية مضللًا، لكنها تُظهر فعلًا مقدار ذاكرة الكود المؤقتة التي تشغلها هذه الدالة المصرَّفة. هنا، الحجم الإجمالي 472 بايتًا، في حين أن التنفيذ الفعلي للدالة يشغل 168 بايتًا.
يمكننا بعد ذلك أن نفعل الشيء نفسه للمستوى 2 والمستوى 3. سأتخطى المخرجات، لكن إليك الأحجام لكل مستوى.
| المستوى 1 | المستوى 2 | المستوى 3 | |
|---|---|---|---|
| الحجم الإجمالي | 472 | 536 | 576 |
| حجم الكود الرئيسي | 168 | 232 | 272 |
تُظهر هذه الأرقام لماذا تعود الدالة التي لا يمكن تصريفها من المستوى 3 إلى المستوى 4 إلى المستوى 2. فبفضل بيانات التحليل المحدودة، تكون أصغر.
مصرِّف C2
هذه هي مرحلة التصريف الأخيرة، حيث تنتهي الدوال hot. ويُسمى كثيرًا مصرِّف server، ويطبّق عددًا من التحسينات الجريئة مثل التنبؤ بالفروع (branch prediction) والتجهيز المتجهي (vectorization) وفتح الحلقات (loop unrolling).
وتستند كثير من هذه التحسينات إلى تنبؤات. أي أن JVM، باستخدام بيانات التحليل، يفترض أن الدالة ستعمل بالطريقة نفسها التي عملت بها من قبل. لكن هذا الافتراض لا يصح دائمًا. وعندما لا يصح، يلاحظ JVM عدم التطابق ويعود إلى الكود المفسَّر لتلك الدالة. ثم تُجمع بيانات التحليل للدالة من جديد، وقد تبدأ دورة التصريف كلها من البداية.
كما ذُكر سابقًا، فإن الدوال التي يصرّفها C2 محسَّنة بشدة ولا تحمل بيانات تحليل. ولرؤية التفاصيل، شغّل هذا الأمر:
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly -XX:-BackgroundCompilation -jar target/app.jar 15000يضيف هذا الأمر الخيار:
-XX:-BackgroundCompilation، الذي يجعل مصرِّف JIT يصرّف الدوال بشكل متزامن بدلًا من العمل في الخلفية. احتجت إلى هذا الخيار لأن برنامجي ينتهي بسرعة كبيرة، ومن دونه قد لا يكتمل التصريف قبل خروج البرنامج.
وبذلك يمكننا توسيع الجدول السابق بالنسخة المصرَّفة بواسطة C2 من الدالة resolveNumber.
| المستوى 1 | المستوى 2 | المستوى 3 | المستوى 4 | |
|---|---|---|---|---|
| الحجم الإجمالي | 472 | 536 | 576 | 392 |
| حجم الكود الرئيسي | 168 | 232 | 272 | 112 |
ينتج عن تصريف C2 أصغر دالة مصرَّفة، مما يُظهر أن C2 يجلب فوائد حقيقية حتى للدوال البسيطة. لكن عيبه الرئيسي أنه يكلّف وقتًا وموارد.
لاحظ أن الخيار -XX:CICompilerCount يتيح لنا التحكم في عدد الخيوط التي يستخدمها مصرِّف JIT. وهناك أيضًا خيار يسمى -XX:CICompilerCountPerCPU. وعندما يكون مفعّلًا، يقرر JVM تلقائيًا عدد خيوط مصرِّف JIT التي سيستخدمها بناءً على عدد أنوية المعالج المتاحة. فمثلًا، على معالج بـ 4 أنوية يمكنك أن تتوقع خيطين لمصرِّف C2 وخيطًا واحدًا لمصرِّف C1.
وتوجد أيضًا عدة خيارات للتحكم في عتبات كل مستوى من مستويات التصريف. لن أصفها بالتفصيل، لكن يمكنك سردها بهذا الأمر:
java -XX:+PrintFlagsFinal | grep Tierذاكرة الكود المؤقتة
هناك جزء آخر أودّ تغطيته: ذاكرة الكود المؤقتة (code cache). بعد تصريف الكود، يجب حفظه في مكان يسهل الوصول إليه. وافتراضيًا، تُقسَّم ذاكرة الكود المؤقتة إلى ثلاثة أجزاء:
- كود JVM الداخلي (غير الدوال) – يحتوي هذا الجزء على الكود المفسَّر، الذي يبقى في الذاكرة المؤقتة بشكل دائم. ويمكن ضبط حجمه بالخيار
-XX:NonProfiledCodeHeapSize. - Profiled-code – يحتوي هذا الجزء على كود محسَّن بشكل خفيف ينتجه مصرِّف C1 وعمره قصير. ويمكن ضبط حجمه بالخيار
-XX:ProfiledCodeHeapSize. - Non-profiled code – يحتوي هذا الجزء على كود محسَّن بالكامل ينتجه مصرِّف C2. ويمكن التحكم في حجمه بالخيار
-XX:NonNMethodCodeHeapSize.
وهناك أيضًا بعض الخيارات الأخرى في JVM المتعلقة بذاكرة الكود المؤقتة قد تكون مفيدة:
-XX:InitialCodeCacheSize-XX:ReservedCodeCacheSize-XX:CodeCacheExpansionSize-XX:+PrintCodeCache
الخلاصة
كان هدفي في هذه المقالة شرح المفاهيم الأساسية وراء تحويل البايت كود إلى كود أصلي. العملية ديناميكية جدًا وقابلة للضبط بدرجة كبيرة. وهي تستغرق وقتًا وموارد كبيرة فعلًا، لكنها مع الوقت يمكن أن تحسّن أداء برامجنا بشكل كبير.
جميع الأمثلة في هذه المقالة شُغّلت على Ubuntu 24.04.3 LTS, x86_64، مع OpenJDK Runtime Environment Temurin-25+36 (build 25+36-LTS). آمل أن تمنحك هذه المقالة صورة أوضح عن كيفية إنتاج JVM للكود الأصلي.