Ինչ կցանկանայի իմանալ Event Sourcing-ով սկսելիս – մաս 2, համակարգվածություն
Event sourcing-ի համակարգվածության երաշխիքների մասին տարածված ենթադրությունները՝ իրական փաստերի համեմատ
Շարքի առաջին մասում անդրադարձանք event sourcing-ի մի քանի մեծ առավելությունների՝ ժամանակի մեջ ճամփորդությանը և events stream-ի առկայության դեպքում ծառայության մասին գործնականում ցանկացած վերլուծական հարցի պատասխանելու հնարավորությանը։ Այս անգամ սկսենք event sourcing-ի համակարգվածության (consistency) երաշխիքների մասին մի քանի տարածված ենթադրություններից, ապա համեմատենք դրանք փաստերի հետ։
Ինչ է կատարվում համակարգվածության հետ
Eventual consistency-ն հաճախ հիշատակվում է CQRS-ի և հատկապես event sourcing-ի հետ նույն շնչով։ Մարդիկ հակված են կարծելու, որ event sourced համակարգերը ըստ սահմանման eventually consistent են. write կողմը իրադարձություններ է ավելացնում պահոցում, իսկ լիովին առանձին read կողմը սպառում է այդ իրադարձությունները և յուրաքանչյուր use case-ի համար կառուցում է առանձին read model՝ օգտագործելով այն պահոցը, որը համապատասխանում է պահանջներին և իրավիճակին։ Սա հաստատ վատ ճարտարապետություն չէ. այն բերում է այնպիսի առավելություններ, ինչպիսիք են կոնկրետ read-երի համար հարմարեցված տվյալների բազայի տեսակը, մեկուսացումը, read-երը write-երից առանձին մասշտաբավորելը և այլն։ Բայց, ինչպես գիտենք, չկա ամենուր լավագույն ընտրություն. ամեն ինչ հանգում է փոխզիջումների (tradeoffs)՝ ո՞ր ավելի քիչ կարևոր հատկանիշներից եք պատրաստ հրաժարվել՝ ավելի կարևորներ ստանալու համար։ Այդուհանդերձ, eventual consistency-ն միակ ճանապարհն է՞։ Իսկ եթե ինչ-ինչ պատճառով չեք ուզում կամ չեք կարող գործ ունենալ դրա հետ։
Իրականում eventual consistency-ն, և մասնավորապես առանձին read տվյալների բազան, բոլորովին պարտադիր չեն event sourced համակարգերի (կամ ընդհանրապես CQRS մոտեցման) համար։ Դուք ոչ միայն կարող եք առանց առանձին տվյալների բազաների աշխատել, այլև կարող եք անհրաժեշտության դեպքում ձեր read կողմը դարձնել խստորեն համակարգված (strictly consistent)։ Եվ կրկին՝ դա անելու լավագույն միակ եղանակ չկա. փոխարենը կան տարբեր տարբերակներ՝ կախված այն բանից, ինչի համար եք նախագծում։
Eventual consistency-ի թեմայով. դրան կարելի է հանդիպել նույնիսկ մեկ տվյալների բազայի դեպքում, որը սպասարկում է և՛ read-երը, և՛ write-երը։ Եթե write-երը գնում են primary հանգույց (կամ leader, coordinator, ինչպես էլ անվանեք), իսկ read-երը գալիս են ասինխրոն թարմացվող replica-ներից, ահա ձեր read-երն արդեն eventually consistent են, թեև ունեք ընդամենը մեկ տրամաբանական տվյալների բազա։
Անցնենք հնարավոր լուծումների շարքով՝ տեսնելու համար, թե ինչպես կարելի է անհրաժեշտության դեպքում հասնել խիստ համակարգվածության, ինչ արժե դա և ինչպես կարող ենք աստիճանաբար շարժվել դեպի eventual consistency։ Մենք կկենտրոնանանք բացառապես read կողմի համակարգվածության և դրա կառավարման վրա՝ ենթադրելով, որ write-երը (հրամանների մշակումը) միշտ համակարգված են, օրինակ՝ մեկ ACID-համապատասխան հանգույց, որը միայնակ կատարում է write գործողությունները։ Հուսով եմ՝ հետագա մասերից մեկում կհասնենք write-երի մասշտաբավորմանը այդ սահմանափակումից այն կողմ։
Read-երը ըստ պահանջի՝ event stream-ից
Հրամանները մշակելու եղանակից մենք արդեն գիտենք, թե ինչպես ստանալ վերջին վիճակը. նախ վերարտադրել և կիրառել համապատասխան stream-ի բոլոր իրադարձությունները, ապա հրամանը մշակել այդ վիճակով։ Եթե ձեզ պետք է, որ պատասխանները միշտ արտացոլեն ամենաթարմ վիճակը, կարող եք query կողմում կատարել ճիշտ նույնը. պատասխանել query-ներին այն վիճակով, որը կառուցվում է ըստ պահանջի՝ query-ի պահին, ձեր հիմնական պահոցում գտնվող event stream-ներից՝ հենց այն տվյալների բազայից, որտեղ գրում եք իրադարձությունները։ Այսպես դուք միշտ աշխատում եք ամենաթարմ վիճակի հետ, որը վերակառուցված է իրադարձությունների վերջին stream-ից։
Բնականաբար, այս մոտեցումն ունի իր թակարդները։ Գործնականում այն աշխատում է միայն այն դեպքում, երբ query-ները վերաբերում են մեկ aggregate-ի կամ դրանցից միայն մի քանիսի, և երբ նրանց event stream-ները շատ երկար չեն (թե կոնկրետ ինչ է սա նշանակում՝ կախված է ձեր հատուկ պահանջներից)։ Հակառակ դեպքում այն կարող է մեծ բեռ ստեղծել և՛ տվյալների բազայի, և՛ հավելվածի վրա, քանի որ նրանք պետք է բեռնեն շատ իրադարձություններ, վերարտադրեն դրանք և հաշվարկեն բոլոր վիճակները՝ պատասխանելուց առաջ։ Արդյունքում այդպիսի query-ները կարող են վատ աշխատել, և դրանցից շատերի միաժամանակյա կատարումը իրական ռիսկ է պարունակում վատթարացնելու write-երի արտադրողականությունը։
Բավականին դասական օրինակ է BankAccount entity-ն, որը հետևում է հաշվի մնացորդին։ Եթե ինչ-ինչ պատճառով ձեզ պետք է, որ մնացորդի query-ները միշտ ընթացիկ լինեն, սա դրան հասնելու եղանակներից մեկն է. պարզապես հիշեք բոլոր փոխզիջումները։
Ավելին, այն պահանջը, որ query-ները (մասնավորապես օգտագործողի ինտերֆեյսից եկողները) արտացոլեն ամենաընթացիկ վիճակը, իրականում բավականին թույլ է. ի վերջո, մինչև պատասխանը հասնի հաճախորդին, դրա տվյալները կարող են արդեն հնացած լինել, քանի որ այդ ընթացքում կարող էին փոխվել։
Transactional read models
Հնարավոր է՝ սրա համար ավելի լավ անուն կա, բայց լսեք ինձ, մինչև բացատրեմ։ Նախորդ մոտեցման թերություններից մեկն այն է, որ յուրաքանչյուր query հարցումը պահանջում է վերարտադրել բոլոր իրադարձությունները։ Իհարկե, կան snapshot-ներ, բայց նույնիսկ այդ դեպքում պետք է վերարտադրել վերջին snapshot-ից հետո եղած իրադարձությունները։ Կախված query-ից, ներգրավված entity-ների քանակից, նրանց stream-ների չափից և այլն, սա կարող է նկատելիորեն վնասել արտադրողականությանը և latency-ին։ Իդեալական դեպքում մենք այդ տվյալները կպահեինք նախապես հաշվարկված, բայց միևնույն ժամանակ կթարմացնեինք դրանք հենց entity-ի վիճակի փոփոխվելու պահին (երբ ավելացվում են նոր իրադարձություններ)։ Հնչում է սովորական read model-ի պես, չէ՞։ Այդպես է, բայց փոքր շրջադարձով։ «Դասական» read model մոտեցումը համարվում է eventually consistent, քանի որ այն պահպանում է առանձին գործընթաց. այստեղ, փոխարենը, մենք թարմացնում ենք read model-ը նույն transaction-ի ներսում, որում պահպանում ենք մեր իրադարձությունները, և query-ներին սպասարկում ենք այս համակարգված read model-ից։
Հստակ առավելությունն այն է, որ read model-ները միշտ խստորեն ընթացիկ են, և query-ների համար իրադարձությունները վերարտադրելու կարիք չկա։ Վերադառնալով BankAccount օրինակին՝ կարող եք ունենալ, ասենք, account_balances աղյուսակ, որը պահում է հաշիվների ընթացիկ վիճակը և միշտ ճշգրիտ արտացոլում այն։ Դուք նաև ավելի շատ ազատություն եք ստանում read model-ների նախագծման մեջ. տվյալները կարող են ագրեգացնել բազմաթիվ entity-ներ՝ առանց ամեն անգամ նրանց բոլոր իրադարձությունները բեռնելու և այլն։
Թերություննե՞ր։ Բնականաբար կան, ահա մի քանիսը։ Նախ՝ լուծումն աշխատում է միայն այն event պահոցների հետ, որոնք առաջարկում են ուժեղ transactional սեմանտիկա։ Ապա՝ transaction-ը պարզ իրադարձության ավելացումից մինչև լրացուցիչ թարմացումներ ընդլայնելը կարող է արժենալ որոշ արտադրողականություն, հատկապես write-ծանր սցենարներում։ Եթե ընտրում եք այս ուղին, լավ է սահմանափակել այն միայն կրիտիկական read model-ի թարմացումներով։ Որքան շատ գործողություն դնեք մեկ transaction-ի մեջ, այնքան ավելի երկար է տևում commit-ը և այնքան ավելի հավանական է, որ ինչ-որ բան սխալ ընթանա։ Բացի այդ, հրամանը հաջողությամբ մշակվելը և նրա իրադարձությունների պահպանվելը այժմ ամբողջովին կախված է նրանից, որ ձեր read model-ի տրամաբանությունը ճիշտ է և panic չի առաջացնում։ Ձեր projection-ի թարմացման տրամաբանության սխալը կարող է հետ գլորել ամբողջ transaction-ը, ինչը փաստացի հանգեցնում է հրամանի մշակման և իրադարձությունների պահպանման ձախողման։ Դուք նաև կորցնում եք write և read կողմերը միմյանցից անկախ մասշտաբավորելու հնարավորությունը։ Վերջապես՝ նկատեք, որ ոչ ամեն event sourcing ֆրեյմվորք է բավականաչափ ճկուն, որպեսզի աջակցի transactional read model-ներին և projection-ի թարմացումները պահպանի պահպանվող իրադարձությունների հետ միասին. օրինակ՝ Akka/Pekko-ի persistence ընդլայնումը դա թույլ չի տալիս։
Read-երի սպասարկումը DB replica-ներից
Այս պահին մենք մտնում ենք eventual consistency-ի տարածք, որտեղ ոչինչ չի երաշխավորում, որ read-երը միշտ համաժամանակեցված են write կողմի հետ։ Ինչպես նշվեց վերևում, ընտրելու համար կան առնվազն մի քանի տարբերակ։
Read-ծանր համակարգերում կարող եք ցանկանալ ագրեսիվ կերպով մասշտաբավորել read-երը՝ առանց write-երը մասշտաբավորելու, բայց «դասական» ասինխրոն read model-ը կարող է բացառված լինել, քանի որ համակարգվածության ուշացումները անընդունելի են. օրինակ՝ ձեր read model-ները թարմացվում են eventstore-ը նոր իրադարձությունների համար պարբերաբար հարցումով, ինչը իր բնույթով չափազանց մեծ ուշացում է ավելացնում։ Եթե որոշ ուշացում ընդունելի է, բայց ուզում եք այն հնարավորինս փոքր պահել, կա նախորդ մոտեցման տարբերակ. դուք դեռ թարմացնում եք projection-ները transactional եղանակով հրամանները մշակելիս, բայց read-երը սպասարկում եք հատուկ տվյալների բազայի replica հանգույցներից։ Այսօրվա տվյալների բազաների շարժիչներում replication-ը սովորաբար բավականաչափ արագ է դրա համար։ Թեև eventually consistent է, այս մոտեցումը փորձում է հնարավորինս փոքրացնել անհամապատասխանության պատուհանը։
Կա նաև ավելի դինամիկ տարբերակ։ Write-ից հետո որոշ ժամանակ (սովորաբար մի քանի վայրկյան, ապահովության համար) դուք շարունակում եք խստորեն համակարգված query-ները սպասարկել primary հանգույցից, և երբ այդ վայրկյաններից հետո replica-ները հասնում են, անցնում եք դրանց։ Սա հավելվածի կողմից ավելի բարդ է, քանի որ պետք է հետևեք replication-ի վիճակին և որոշեք, թե երբ անցնել, բայց գործնականում այն կարող է նեղացնել անհամապատասխանության բացը (բացառությամբ խոշոր խափանումների)՝ որոշակի սցենարներում համատեղելով խիստ համակարգվածությունը read-երի մասշտաբավորելիության հետ։
Տարբերակի ստուգում read-ի ժամանակ
Eventual consistency-ի որոշ թերություններ մեղմելու մեկ այլ հետաքրքիր եղանակ է query-ի պահին տարբերակների ստուգումների (version checks) օգտագործումը։ Սա պահանջում է, որ հաճախորդները գիտեն մեխանիզմի մասին և համագործակցեն մեր backend-ի հետ. ահա թե ինչպես է այն աշխատում։ Յուրաքանչյուր հաջող հրամանից հետո մենք հաճախորդին ուղարկում ենք entity-ի նոր տարբերակի համարը։ Տարբերակի համարը սովորաբար մոնոտոն աճող հերթական համար է, որը մեծանում է 1-ով ամեն անգամ, երբ պահպանվում է նոր իրադարձություն։ Այն նաև օգնում է հայտնաբերել կոնֆլիկտներ write կողմում, բայց այստեղ մենք պարզապես վերադարձնում ենք այն հաճախորդին՝ ասելով մոտավորապես հետևյալը. ես մշակեցի քո հրամանը, և քո BankAccount entity-ն այժմ 42-րդ տարբերակում է։ Այդ պահից սկսած, երբ հաճախորդը հարցում է անում entity-ի վիճակի մասին, այն ուղարկում է իր իմացած ամենավերջին տարբերակի համարը (այս դեպքում՝ 42)։ Եթե read կողմը դեռ չի հասել 42 տարբերակը կրող իրադարձությանը (ասենք՝ տեսել է միայն մինչև 41-ը), մենք դա հայտնաբերում ենք և պատասխանում, օրինակ, Retry-After header-ով, մինչև այն հասնի և տարբերակները համընկնեն, որից հետո վերադարձվում է պատշաճ պատասխան։
Սա լավ է աշխատում, երբ read-երը ընդգրկում են մեկ կամ ընդամենը մի քանի entity, որոնց տարբերակի համարները հեշտ է հետևել։ Կարող էինք փորձել օգտագործել ինչ-որ գլոբալ հերթական համար բոլոր stream-ների բոլոր իրադարձությունների վրա, բայց այդ դեպքում մեկ entity-ի ժամանակավոր անհամապատասխանությունը կազդեր մեկ այլ, հնարավոր է՝ անկապ entity-ի query-ների վրա։ Երբեմն դա հենց այն է, ինչ պետք է, օրինակ՝ ագրեգացված հաշվետվությունների դեպքում, երբ հետևում եք համակարգվածությանը բոլոր stream-ներում, բայց այդ դեպքում, մեկ entity-ի տարբերակից բացի, կպահանջվի վերադարձնել նաև համապատասխան «գլոբալ» հերթական համարը։ Արդյո՞ք դա օգտակար է և արժե՞ ջանքերը, կախված է ձեր կոնկրետ use case-ից։
Eventual consistency-ի ընդունումը
Լավ հայտնի է, որ eventual consistency-ն ձեր դաշնակիցն է, երբ ձեզ անհրաժեշտ է մասշտաբավորվել որոշակի սահմանից այն կողմ։ Բավարար բեռի, արտադրողականության պահանջների և տվյալների ծավալի դեպքում կարող եք հասնել մեկ խստորեն համակարգված տվյալների բազայի (կամ լիովին սինխրոն replication-ի) սահմաններին։ Ճիշտ է, սրանք խնդիրներ են, որոնք բոլորը կցանկանային ունենալ, թեև մեզանից շատերը երբեք չեն ունենում։ Ես ենթադրում եմ, որ դրանք իրական կարիքներ են, որոնք առաջանում են նախագծի աճից և հաջողությունից, այլ ոչ թե մենք ապարդյուն չափազանց բարդացնում ենք ամեն ինչ։
Eventual consistency-ն բերում է բազմաթիվ առավելություններ՝ սկսած read-երը և write-երը անկախ մասշտաբավորելուց՝ երկու կողմերը արտադրողականության, հասանելիության և տեխնոլոգիայի առումով լիովին մեկուսացնելով, և վերջացրած ցանկացած քանակի read model-ներ կառուցելու հնարավորությամբ, որոնցից յուրաքանչյուրը նվիրված է կոնկրետ խնդրի և ունի իր սեփական պահոցը։
Երբեմն թվում է, թե խիստ համակարգվածությունը բացարձակ անհրաժեշտություն է, սակայն բիզնես գործընթացը բացահայտելիս շահառուներին կամ product owner-ներին ճիշտ հարցեր տալը կարող է ցույց տալ, որ դա իրականում այդպես չէ և որ eventual consistency-ն նույնքան լավ կաշխատի։ Գուցե դրա ընդունումը նույնիսկ հետաքրքիր բիզնես հնարավորություններ բացի։ Եվ հակառակը՝ խիստ համակարգվածության ամեն գնով հետապնդելու փոխարեն կարող է ավելի էժան լինել և բիզնեսի տեսանկյունից բավարար՝ անհամապատասխանությունները լուծել ձեռքով՝ բիզնես մակարդակում։ Օրինակ՝ առցանց խանութում կարող եք դիտարկել հաճախորդների պատվերները չեղարկելը, երբ ապրանքը պահեստում չկա, և փոխարենը նվեր քարտ ուղարկելը։ Կախված նրանից, թե որքան հաճախ է դա պատահում, դա կարող է ճիշտ բիզնես որոշում լինել։
Երբեմն, սակայն, նույն խնդրին այլ տեսանկյունից նայելը բացահայտում է eventual consistency-ն ներքուստ օգտագործելու եղանակներ՝ արտաքին աշխարհի նկատմամբ համակարգված մնալով։
Դա ցույց տալու համար վերցնեմ մեկ այլ դասական օրինակ՝ որոշակի տվյալների եզակիության երաշխավորումը ողջ domain-ում։ Մեր BankAccount entity-ների համար մենք ուզում ենք, որ սեփականատերերն ունենան յուրաքանչյուր հաշվին կապված երկրորդական հաշվի համար (օրինակ՝ սեփականատերը կարող է միայն այդ հաշվից դուրս բերել և դրան փոխանցել), և ինչ-ինչ պատճառով այս երկրորդական հաշվի համարը պետք է եզակի լինի մեր օգտատերերի շրջանում. երկու օգտատիրոջ չի կարելի վերագրել նույն երկրորդական հաշվի համարը։
Մի կողմ թողնենք մեր ներքին ձայնը, որը հարցնում է՝ արդյո՞ք domain-ը ճիշտ է մոդելավորված, թե՞ ինչ-որ բան այստեղ կասկածելի է (հուշում՝ հավանաբար այդպես է). սա ընդամենը օրինակ է, ուստի մի պահ համբերեք ինձ։
CRUD աշխարհում մենք հավանաբար կստեղծեինք secondary_accounts աղյուսակ՝ accounts-ին կապված id-ով, secondary_account_number դաշտի վրա կդնեինք unique constraint և վերջ։ secondary_accounts աղյուսակի յուրաքանչյուր insert կամ update կստուգվեր եզակիության համար DB մակարդակում, և ACID-ի խիստ համակարգվածության կողմը լիովին կծածկեր մեզ։
Event sourcing-ի պարագայում ամեն ինչ բավականին այլ տեսք ունի։ Մեր համակարգվածության սահմանները այժմ շրջապատում են առանձին հաշիվը, և քանի որ հրամանի մշակումը պահպանում է միայն ստացված իրադարձությունները, event stream-ները միայնակ թույլ չեն տալիս ապահովել գլոբալ եզակիություն հրամանի մշակման մակարդակում։
Փոխարենը կարող ենք օգտատիրոջ կողմից նոր երկրորդական հաշվի համար խնդրելու գործընթացը բաժանել երկու քայլի։ Նախ՝ ընդունում ենք հրամանը (ենթադրելով, որ այն շարահյուսորեն ճիշտ է և մնացած բոլոր պայմանները բավարարված են) և արձակում ենք իրադարձություն, օրինակ՝ NewSecondaryAccountNumberAssigned՝ հաշիվը դնելով «փոփոխությունը սպասման մեջ է» վիճակում։ Ապա read կողմում կա սովորական տվյալների բազայի աղյուսակ վերը նկարագրածի նման unique constraint-ով՝ secondary_accounts, որի մեջ read կողմը, լսելով NewSecondaryAccountNumberAssigned իրադարձությունները, փորձում է ներմուծել հաշվի համարները։
Սկզբնական հրամանի մշակումը և դրա իրադարձության մշակումը read կողմում
Այժմ եզակիությունը հեշտ է կառավարել. եթե երկրորդական համարի ներմուծումը հաջողվում է, դա նշանակում է, որ դեռ ոչ ոք չի վերցրել այն, ուստի entity-ին ուղարկում ենք հրաման, օրինակ՝ ConfirmSecondaryAccountNumberChange (կամ, ավելի ծանուցման ոճով, SecondaryAccountNumberAvailable), որը entity-ն մշակում է՝ արձակելով SecondaryAccountNumberChanged։ Այդ պահից երկրորդական հաշվի համարը համարվում է վավեր, եզակի և օգտագործման պատրաստ։
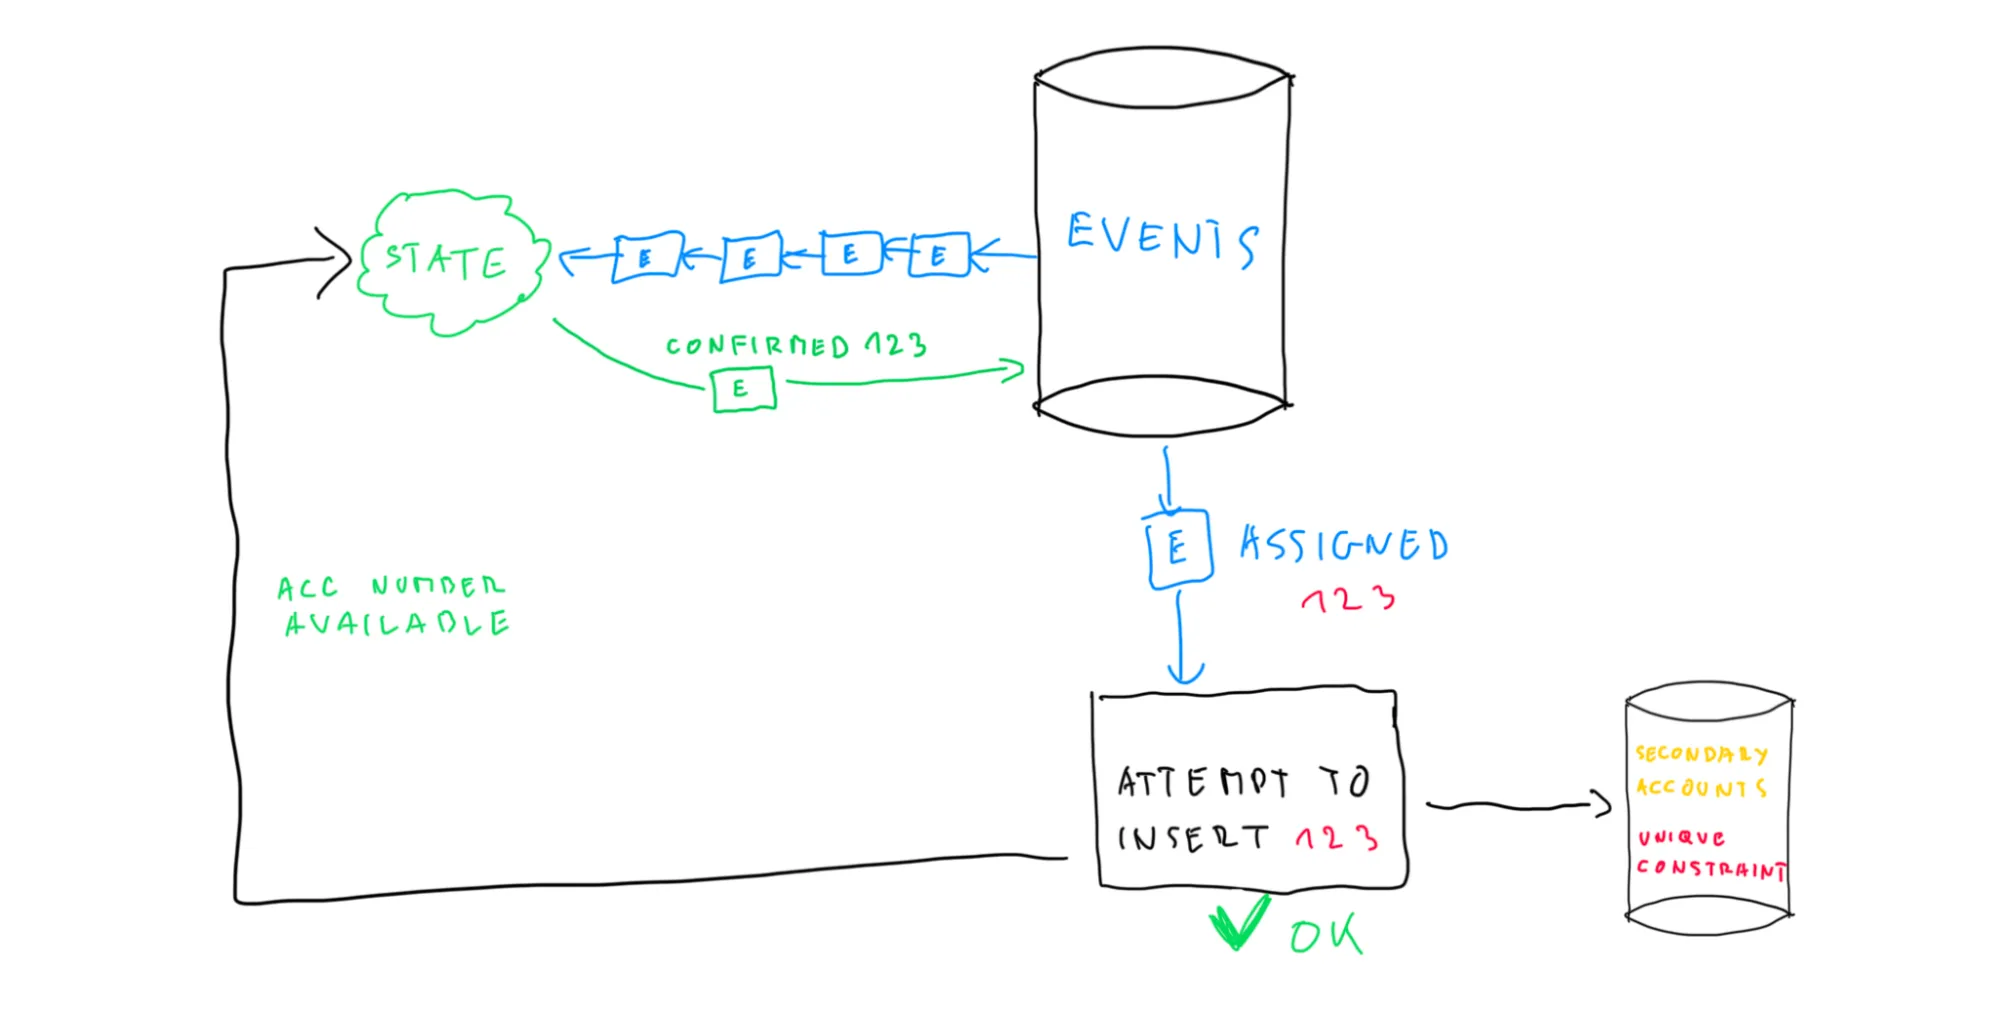
Ներմուծումը հաջողվեց, կրկնօրինակ չկա։ Ուղարկում ենք OK հրաման/հաղորդագրություն
Եթե, մյուս կողմից, ներմուծումը ձախողվում է unique constraint-ի խախտման պատճառով, այսինքն՝ հաշվի համարն արդեն օգտագործվում է, ապա ուղարկում ենք RejectSecondaryAccountNumberChange հրաման (կամ, կրկին որպես ծանուցում, SecondaryAccountNumberDuplicated), որը հանգեցնում է իրադարձության, օրինակ՝ SecondaryAccountNumberChangeRejected.Այստեղ մենք չեղարկում ենք սպասման մեջ գտնվող փոփոխությունը entity-ում և, ամենայն հավանականությամբ, դրա մասին տեղեկացնում օգտատիրոջը։
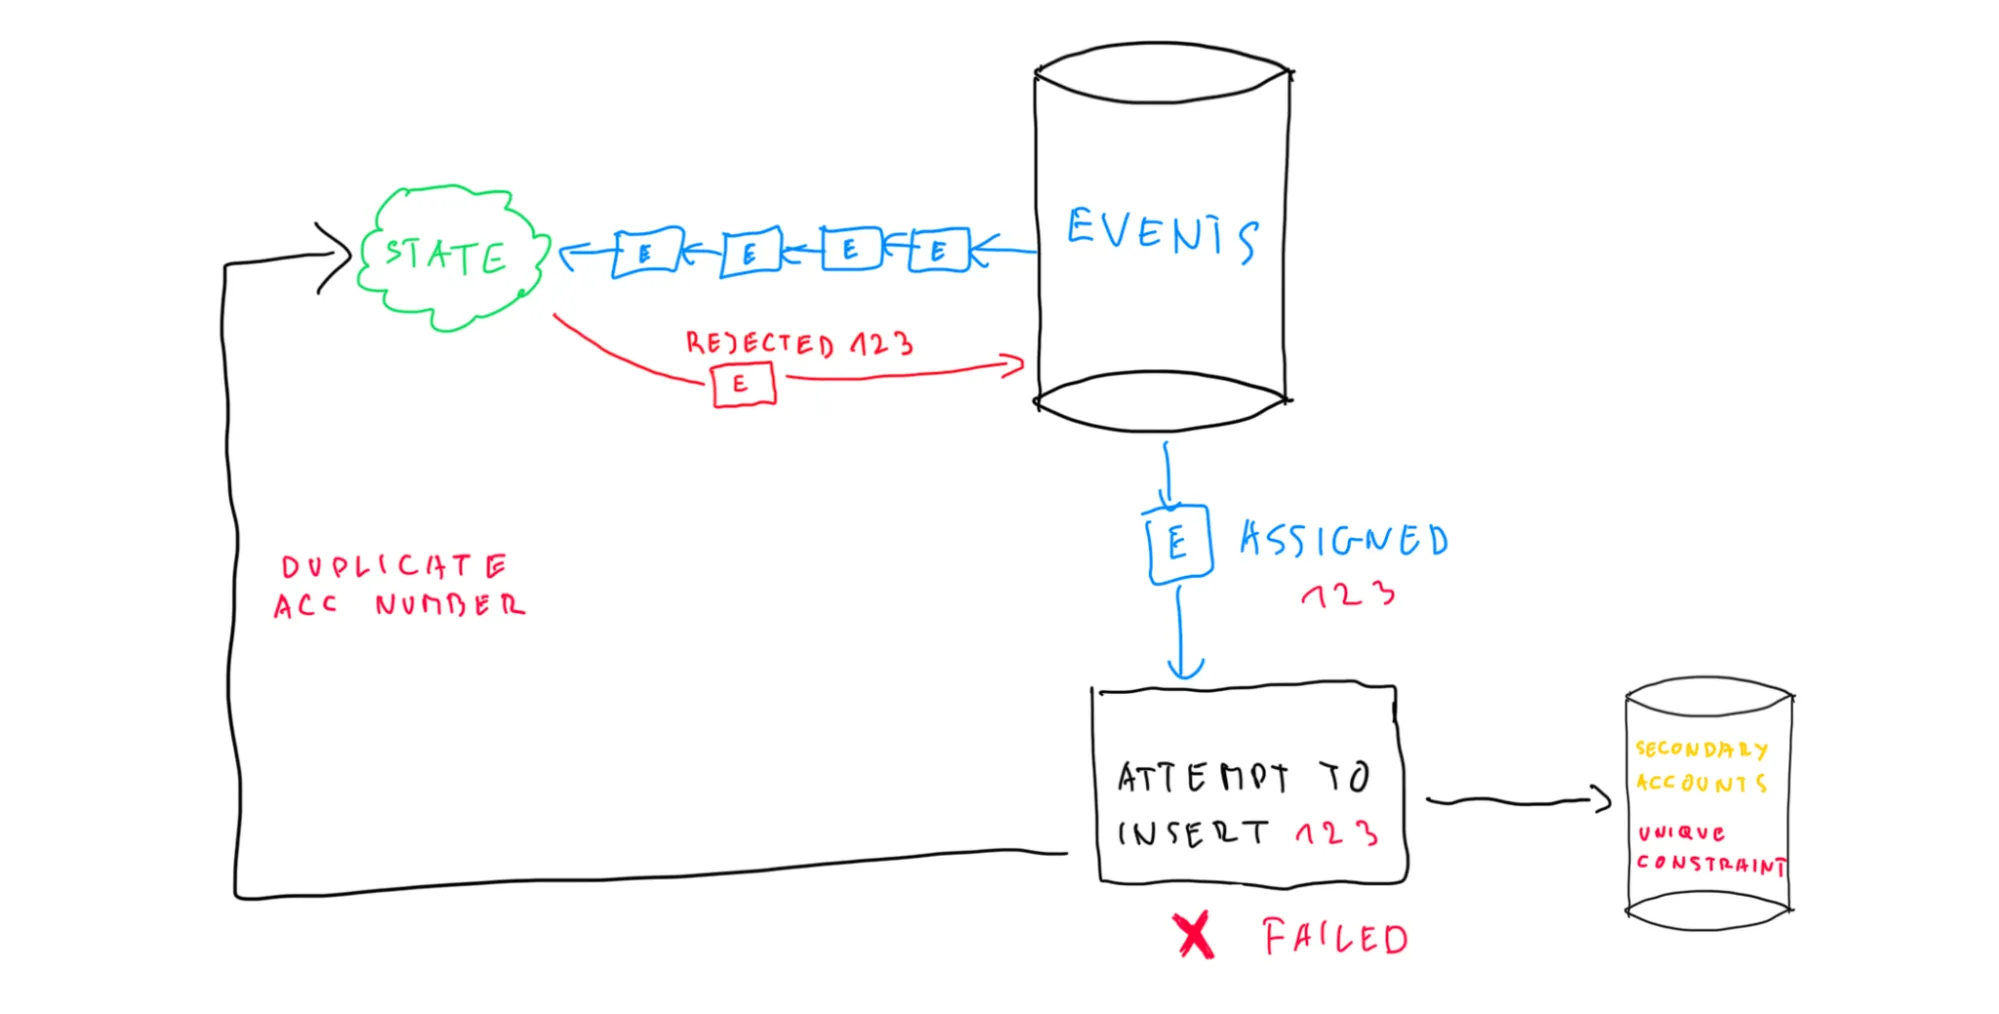
Ներմուծումը ձախողվեց, unique constraint-ը խախտվեց։ Ուղարկում ենք NOT OK հրաման/հաղորդագրություն
Այս projection-ը կարող է ծառայել նաև որպես սկզբնական եզակիության ստուգում, բայց eventual consistency-ի պատճառով վերը նկարագրված ամբողջ գործընթացը դեռ պետք է մնա, քանի որ այդպիսի ստուգումը կարող է միայն նվազեցնել (բայց ոչ լիովին բացառել) կրկնօրինակների հավանականությունը, օրինակ՝ բարելավելով UX-ը և օգտատերերին կանխելով արդեն զբաղեցված հաշվի համարներ ներկայացնելուց։
Այո, սա բավականին պար է և բավական շատ կոդ, քանի որ այս ամբողջ գործընթացը պետք է իրականացվի, բայց այն հասանելի է, եթե անհրաժեշտ լինի։ Արդյո՞ք պետք է այն կիրառել կուրորեն և ամենուր, ինչպես event sourcing-ը կամ գործնականում ցանկացած այլ գործիք։ Բացարձակապես ոչ։ Ամեն ինչ փոխզիջումների մասին է. մի տեղ ինչ-որ բան կորցնում եք՝ մեկ այլ տեղ շահելու համար։ Իմացեք ձեզ հասանելի տարբերակները և կայացրեք լավ տեղեկացված որոշումներ՝ հիմնված այն իրական գործոնների վրա, որոնց բախվում եք։
Վերջին կետ. եթե այն բոլոր իրադարձությունները, որոնք մենք արձակեցինք վերևում՝ պարզ եզակիության դեպքը կառավարելու համար, ձեզ անհարմարություն են պատճառում, հիշեք, որ դրանք բոլորը պետք չէ, որ հրապարակային լինեն։ Event sourcing-ը վիճակը կառավարելու տեղային մոտեցում է, և թե ինչպես եք հաղորդակցվում արտաքին աշխարհի հետ՝ ձեր որոշելիքն է։ Հնարավոր է՝ ուզում եք, որ այլ համակարգեր իմանան երկրորդական հաշվի համարը փոխելու յուրաքանչյուր փորձի մասին, կամ հնարավոր է՝ ուզում եք փոփոխությունը հայտարարել միայն այն ժամանակ, երբ վստահ եք, որ այն իսկապես կիրառվել է։ Հրապարակային և մասնավոր իրադարձությունները հավանաբար արժանի են շարքի իրենց առանձին գլխին, որը հուսով եմ՝ շուտով կգրեմ։
Ամփոփում
Ինչպես ցույց տրվեց վերևում, պնդումը, թե event sourcing-ը (և CQRS-ը) ամբողջովին և բացառապես eventual consistency-ի մասին է, չի համապատասխանում իրականությանը։ Այն անշուշտ հնարավոր է դարձնում eventual consistency-ն և ճիշտ իրավիճակներում լիովին օգտվում դրանից, բայց չի պահանջում այն։ Մենք տեսանք, որ event sourced համակարգերը կարելի է կառուցել խիստ համակարգվածությամբ, երբ դա անհրաժեշտ է։ Կրկին՝ գործիքները կան, և ձեզանից է կախված հասկանալ դրանցից յուրաքանչյուրի ուժեղ և թույլ կողմերը և իմաստուն ընտրություն կատարել։
Հաջորդ մասում կուսումնասիրենք event sourced համակարգերի համար հասանելի պահոցների տարբերակները՝ որն ընտրել և երբ։ Մնացեք մեզ հետ։