ما كنت أتمنى معرفته عند بدء العمل مع Event Sourcing – الجزء 2: الاتساق
افتراضات شائعة حول ضمانات الاتساق في event sourcing، في مقابل الحقائق الفعلية
تناول الجزء الأول من السلسلة بعض المزايا الكبيرة لـ event sourcing: السفر عبر الزمن والقدرة على الإجابة عن أي سؤال تحليلي تقريبًا عن الخدمة، متى توافر تدفق الأحداث. وفي هذا الجزء نبدأ ببعض الافتراضات الشائعة حول ضمانات الاتساق في event sourcing، ثم نقارنها بالحقائق.
ما قصة الاتساق
يُذكر الاتساق النهائي (eventual consistency) كثيرًا في سياق واحد مع CQRS، ومع event sourcing خصوصًا. ويميل الناس إلى افتراض أن الأنظمة المبنية على event sourcing نهائية الاتساق بطبيعتها: يضيف جانب الكتابة الأحداث إلى التخزين، بينما يستهلك جانب قراءة منفصل تمامًا تلك الأحداث ويبني نماذج قراءة مستقلة لكل حالة استخدام، باستخدام أي تخزين يناسب المتطلبات والموقف. هذه بالتأكيد ليست بنية سيئة – فهي تقدّم فوائد مثل نوع قاعدة بيانات مفصَّل لقراءات بعينها، والعزل، وتوسيع القراءة بمعزل عن الكتابة، وغير ذلك. لكن، كما نعلم، لا يوجد خيار هو الأفضل في كل مكان؛ فالأمر كله مقايضات – أي الصفات الأقل أهمية أنت مستعد للتضحية بها لتحصل على صفات أهم. ومع ذلك، هل الاتساق النهائي هو الطريق الوحيد؟ وماذا لو كنت لا تريد التعامل معه، أو لا تستطيع، لسبب ما؟
في الواقع، الاتساق النهائي، وقاعدة بيانات قراءة منفصلة على وجه الخصوص، ليس إلزاميًا بأي حال للأنظمة المبنية على event sourcing (ولا لنهج CQRS ككل). فلا يمكنك الاستغناء عن قواعد البيانات المنفصلة فحسب، بل يمكنك أيضًا جعل جانب القراءة متسقًا اتساقًا صارمًا عند الحاجة. ومرة أخرى، لا توجد طريقة مثلى واحدة لذلك؛ بل هناك خيارات متعددة بحسب ما تصمم له.
وبخصوص الاتساق النهائي: قد تصادفه حتى مع قاعدة بيانات واحدة تتولى القراءة والكتابة معًا! فإذا ذهبت الكتابات إلى عقدة رئيسية (أو قائد أو منسّق، سمّها ما شئت) بينما تأتي القراءات من إحدى النسخ المتماثلة المحدَّثة بصورة غير متزامنة – فها هي قراءاتك صارت نهائية الاتساق، رغم وجود قاعدة بيانات منطقية واحدة فقط.
دعونا نستعرض مجموعة من الحلول الممكنة لنرى كيف يمكن تحقيق الاتساق الصارم عند الحاجة، وكم يكلّف ذلك، وكيف يمكننا الانتقال تدريجيًا نحو الاتساق النهائي. سنركز فقط على الاتساق في جانب القراءة وكيفية التعامل معه، مفترضين أن الكتابات (معالجة الأوامر) متسقة دائمًا – كأن تكون عقدة واحدة متوافقة مع ACID تتولى وحدها عمليات الكتابة. ونأمل أن نتناول توسيع الكتابة بما يتجاوز هذا القيد في جزء لاحق.
القراءة عند الطلب من تدفق الأحداث
من طريقة معالجتنا للأوامر نعرف بالفعل كيف نحصل على أحدث حالة: نعيد أولًا تشغيل كل حدث من التدفق المعني ونطبّقه، ثم نعالج الأمر باستخدام تلك الحالة. وإذا كنت تحتاج أن تعكس الردود دائمًا أحدث حالة، يمكنك فعل الشيء نفسه تمامًا في جانب الاستعلام: أجب عن الاستعلامات بحالة تُبنى عند الطلب وقت الاستعلام من تدفقات الأحداث في تخزينك الأساسي – قاعدة البيانات نفسها التي تكتب إليها الأحداث. وبهذه الطريقة تعمل دائمًا مع أحدث حالة، أُعيد بناؤها من أحدث تدفق للأحداث.
بطبيعة الحال، لهذا النهج مزالقه. ففي الممارسة العملية لا يصلح إلا عندما تغطي الاستعلامات تجمّعًا (aggregate) واحدًا أو عددًا قليلًا منها، وعندما لا تكون تدفقات أحداثها طويلة جدًا (ويعتمد المقصود بذلك تحديدًا على متطلباتك الخاصة). وإلا فقد يضع حملًا ثقيلًا على قاعدة البيانات والتطبيق معًا، إذ عليهما جلب أحداث كثيرة وإعادة تشغيلها وحساب جميع الحالات قبل الرد. ونتيجة لذلك قد يكون أداء هذه الاستعلامات ضعيفًا، وتشغيل عدد كبير منها في وقت واحد ينطوي على خطر حقيقي لتدهور أداء الكتابة.
ومثال كلاسيكي إلى حد ما هو كيان BankAccount الذي يتتبع رصيد الحساب. فإذا كنت تحتاج لسبب ما أن تكون استعلامات الرصيد محدّثة دائمًا، فهذه إحدى طرق تحقيق ذلك – فقط ضع في اعتبارك كل المقايضات.
علاوة على ذلك، فإن اشتراط أن تعكس الاستعلامات (خصوصًا القادمة من واجهة المستخدم) أحدث حالة هو في الواقع شرط ضعيف إلى حد ما – فبحلول وصول الرد إلى العميل قد تكون البيانات فيه قديمة أصلًا، لأنها ربما تغيّرت في الأثناء.
نماذج القراءة المعاملاتية
قد يكون هناك اسم أفضل لهذا، لكن اصبروا عليّ حتى أنتهي من الشرح. من سلبيات النهج السابق أن كل طلب استعلام يتطلب إعادة تشغيل جميع الأحداث. صحيح أن هناك لقطات (snapshots)، لكن حتى معها يبقى عليك إعادة تشغيل الأحداث التي جاءت بعد آخر لقطة. وبحسب الاستعلام وعدد الكيانات المعنية وحجم تدفقاتها وما إلى ذلك، قد يضر هذا بالأداء وزمن الاستجابة ضررًا ملحوظًا. والمثالي أن نبقي تلك البيانات محسوبة مسبقًا مع تحديثها لحظة تغيّر حالة الكيان (عند إضافة أحداث جديدة). يبدو هذا كنموذج قراءة عادي، أليس كذلك؟ هو كذلك، لكن مع لمسة صغيرة. يُعتبر نموذج القراءة “الكلاسيكي” نهائي الاتساق لأن عملية منفصلة تتولى صيانته؛ أما هنا فنحدّث نموذج القراءة ضمن المعاملة نفسها التي نحفظ فيها أحداثنا، ونخدم الاستعلامات من نموذج القراءة المتسق هذا.
الفائدة الواضحة أن نماذج القراءة محدّثة بصرامة دائمًا، دون حاجة إلى إعادة تشغيل الأحداث للاستعلامات. وبالعودة إلى مثال BankAccount، يمكن أن يكون لديك، مثلًا، جدول account_balances يحمل الحالة الحالية للحسابات ويعكسها بدقة دائمًا. كما تحصل على حرية أكبر في تصميم نماذج القراءة – إذ يمكن للبيانات أن تجمّع كيانات كثيرة دون الحاجة إلى تحميل كل أحداثها في كل مرة، وهكذا.
السلبيات؟ بالطبع هناك بعضها؛ وهذه بعضها. أولًا، لا يعمل الحل إلا مع مخازن الأحداث التي توفر دلالات معاملاتية قوية. وعلاوة على ذلك، فإن توسيع المعاملة من إدراج حدث بسيط ليشمل تحديثات إضافية قد يكلّف شيئًا من الأداء، خصوصًا في السيناريوهات كثيرة الكتابة. وإذا اخترت هذا الطريق فمن الأفضل قصره على تحديثات نماذج القراءة الحرجة فقط. فكلما حشرت عمليات أكثر في معاملة واحدة، طال وقت الإتمام (commit) وزاد احتمال حدوث خطأ. بالإضافة إلى ذلك، صار نجاح معالجة الأمر وتخزين أحداثه يعتمد كليًا على صحة منطق نموذج القراءة وعدم تعطّله (panic). فخطأ في منطق تحديث الإسقاط (projection) قد يتراجع بالمعاملة كلها، مما يجعل معالجة الأوامر وتخزين الأحداث تفشل فعليًا. كما تفقد القدرة على توسيع جانبي الكتابة والقراءة باستقلالية. وأخيرًا، لاحظ أن ليس كل إطار عمل لـ event sourcing مرنًا بما يكفي لدعم نماذج القراءة المعاملاتية وحفظ تحديثات الإسقاط مع الأحداث المخزّنة – فامتداد الاستمرارية (persistence) في Akka/Pekko، على سبيل المثال، لا يسمح بذلك.
خدمة القراءات من نسخ قاعدة البيانات المتماثلة
عند هذه النقطة ندخل منطقة الاتساق النهائي، حيث لا شيء يضمن أن القراءات متزامنة دائمًا مع جانب الكتابة. وكما ذُكر سابقًا، هناك على الأقل بعض الصيغ للاختيار بينها.
في الأنظمة كثيرة القراءة قد ترغب في توسيع القراءة بقوة دون توسيع الكتابة، لكن نموذج القراءة “الكلاسيكي” غير المتزامن قد يكون مستبعدًا لأن تأخيرات الاتساق غير مقبولة – مثلًا لأن نماذج القراءة لديك تُحدَّث بالاستعلام الدوري عن أحداث جديدة في eventstore، وهذا يضيف بطبيعته تأخيرًا أكثر من اللازم. وإذا كان بعض التأخير مقبولًا لكنك تريد إبقاءه أصغر ما يمكن، فهناك صيغة من النهج السابق: ما زلت تحدّث الإسقاطات معاملاتيًا أثناء معالجة الأوامر، لكنك تخدم القراءات من عقد نسخ متماثلة مخصصة لقاعدة البيانات. والتماثل (replication) في محركات قواعد البيانات الحالية سريع عادةً بما يكفي لذلك. ورغم أن هذا النهج نهائي الاتساق، فإنه يحاول تقليص نافذة عدم الاتساق قدر الإمكان.
وهناك أيضًا صيغة أكثر ديناميكية. فلفترة بعد الكتابة (عادةً بضع ثوانٍ، من باب الحيطة)، تواصل خدمة استعلامات متسقة بصرامة من العقدة الرئيسية، وبمجرد أن تلحق النسخ المتماثلة بعد تلك الثواني تنتقل إليها. هذا أكثر تعقيدًا من جهة التطبيق، إذ يجب تتبع حالة التماثل وتحديد وقت التحويل، لكنه عمليًا قد يضيّق فجوة عدم الاتساق (باستثناء الأعطال الكبرى)، جامعًا بين الاتساق الصارم وقابلية توسيع القراءة في سيناريوهات معينة.
التحقق من النسخة عند القراءة
طريقة أخرى مثيرة للتخفيف من بعض سلبيات الاتساق النهائي هي استخدام فحوصات النسخة وقت الاستعلام. وهذا يتطلب أن يعرف العملاء بالآلية ويتعاونوا مع الخلفية (backend) لدينا – وإليكم كيف يجري الأمر. بعد كل أمر ناجح نرسل إلى العميل رقم النسخة الجديد للكيان. ورقم النسخة عادةً رقم تسلسلي متزايد باطراد، يزداد بمقدار 1 كلما حُفظ حدث جديد. وهو يساعد أيضًا في اكتشاف التعارضات في جانب الكتابة، لكننا هنا نعيده إلى العميل فحسب، قائلين شيئًا مثل: لقد عالجت أمرك وصار كيان BankAccount الخاص بك الآن عند النسخة 42. ومن ذلك الحين، كلما استعلم العميل عن حالة الكيان، يرسل معه أحدث رقم نسخة يعرفه (42 في هذه الحالة). فإذا لم يكن جانب القراءة قد لحق بعد بالحدث الحامل للنسخة 42 (لنقل أنه لم يرَ سوى حتى 41)، نكتشف ذلك ونرد مثلًا برأس Retry-After إلى أن يلحق وتتطابق النسخ، وعندها يُعاد رد سليم.
يعمل هذا جيدًا عندما تغطي القراءات كيانًا واحدًا أو قليلًا من الكيانات التي يسهل تتبع أرقام نسخها. يمكننا محاولة استخدام نوع من الرقم التسلسلي العام عبر جميع الأحداث في جميع التدفقات، لكن عندها سيؤثر عدم اتساق مؤقت في كيان واحد على الاستعلامات عن كيان آخر، ربما لا علاقة له به. وأحيانًا يكون هذا بالضبط ما تريده – مثلًا في التقارير التجميعية حيث تتتبع الاتساق عبر جميع التدفقات – لكن عندها، إلى جانب نسخة الكيان الواحد، ستحتاج أيضًا إلى إعادة الرقم التسلسلي “العام” المطابق. ويعتمد كون ذلك مفيدًا ومستحقًّا للجهد على حالة استخدامك الخاصة.
تقبّل الاتساق النهائي
من المعروف أن الاتساق النهائي حليفك متى احتجت إلى التوسع بعد حد معين. ففي ظل حمل وأداء مطلوب وحجم بيانات كافية، قد تبلغ حدود قاعدة بيانات واحدة متسقة اتساقًا صارمًا (أو التماثل المتزامن بالكامل). وهذه، بلا شك، مشكلات يتمنى الجميع أن تكون لديهم، وإن كان معظمنا لا يواجهها فعلًا. وأفترض أنها احتياجات حقيقية ناشئة عن نمو المشروع ونجاحه، لا أننا نبالغ في التعقيد بلا سبب وجيه.
يجلب الاتساق النهائي مزايا كثيرة، بدءًا من توسيع القراءة والكتابة باستقلالية عبر العزل التام بين الجانبين من حيث الأداء والتوافر والتقنية، وانتهاءً بإمكانية بناء أي عدد من نماذج القراءة، كل منها مخصص لمهمة محددة بتخزينه الخاص.
أحيانًا يبدو أن الاتساق الصارم ضرورة مطلقة، لكن طرح الأسئلة الصحيحة على أصحاب المصلحة أو مالكي المنتج أثناء استكشاف العملية التجارية قد يُظهر أن الأمر ليس كذلك فعلًا وأن الاتساق النهائي سيفي بالغرض تمامًا. وربما فتح تقبّله فرصًا تجارية مثيرة؟ وفي المقابل، بدلًا من السعي إلى الاتساق الصارم بأي ثمن، قد يكون أرخص وكافيًا من الناحية التجارية معالجة حالات عدم الاتساق بحلها يدويًا على المستوى التجاري. ففي متجر إلكتروني مثلًا، يمكنك التفكير في إلغاء طلبات العملاء عند نفاد صنف وإرسال بطاقة هدية بدلًا منها. وبحسب تكرار حدوث ذلك، قد يكون هذا هو القرار التجاري الصحيح.
لكن أحيانًا يكشف النظر إلى المشكلة نفسها من زاوية مختلفة طرقًا لاستخدام الاتساق النهائي داخليًا مع البقاء متسقين تجاه العالم الخارجي.
ولتوضيح ذلك، دعوني آخذ مثالًا كلاسيكيًا آخر: ضمان أن بيانات معينة فريدة عبر النطاق (domain). في كيانات BankAccount لدينا، نريد أن يكون لدى المالكين رقم حساب ثانوي مرتبط بكل حساب (مثلًا، لا يجوز للمالك السحب والتحويل إلا إلى هذا الحساب)، ولسبب ما يجب أن يكون رقم الحساب الثانوي هذا فريدًا بين مستخدمينا – فلا يجوز تعيين رقم الحساب الثانوي نفسه لمستخدمَين.
لنضع جانبًا صوتنا الداخلي الذي يسأل هل النطاق مُنمذَج جيدًا أو هل في الأمر ما يبعث على الريبة (تلميح: على الأرجح نعم) – إنه مجرد مثال، فاصبروا معي لحظة.
في عالم CRUD، من المرجح أن ننشئ جدول secondary_accounts مرتبطًا بـ accounts عبر المعرّف، ونضع قيد تفرّد (unique constraint) على الحقل secondary_account_number، وينتهي الأمر. فكل إدراج أو تحديث في جدول secondary_accounts سيُفحص للتفرّد على مستوى قاعدة البيانات، وسيغطينا جانب الاتساق الصارم في ACID تغطية كاملة.
ومع دخول event sourcing تبدو الأمور مختلفة تمامًا. فحدود اتساقنا تحيط الآن بحساب فردي، ولأن معالجة الأوامر لا تحفظ سوى الأحداث الناتجة، فإن تدفقات الأحداث وحدها لا تتيح لنا فرض التفرّد العام على مستوى معالجة الأوامر.
وبدلًا من ذلك، يمكننا تقسيم عملية طلب المستخدم رقم حساب ثانوي جديد إلى خطوتين. أولًا نقبل الأمر (على افتراض أنه سليم نحويًا وأن جميع الشروط الأخرى متحققة) ونُصدر حدثًا مثل NewSecondaryAccountNumberAssigned، واضعين الحساب في حالة “تغيير معلّق”. ثم، في جانب القراءة، هناك جدول قاعدة بيانات عادي بقيد تفرّد مثل الموصوف سابقًا – secondary_accounts – يحاول جانب القراءة، وهو يستمع إلى أحداث NewSecondaryAccountNumberAssigned، إدراج أرقام الحسابات فيه.
معالجة الأمر الأولي ومعالجة حدثه في جانب القراءة
صار التعامل مع التفرّد سهلًا الآن: إذا نجح إدراج الرقم الثانوي فهذا يعني أنه لم يأخذه أحد بعد، فنرسل أمرًا مثل ConfirmSecondaryAccountNumberChange (أو، بأسلوب أقرب إلى الإشعارات، SecondaryAccountNumberAvailable) إلى الكيان، فيعالجه بإصدار SecondaryAccountNumberChanged. ومن تلك اللحظة يُعد رقم الحساب الثانوي صالحًا وفريدًا وجاهزًا للاستخدام.
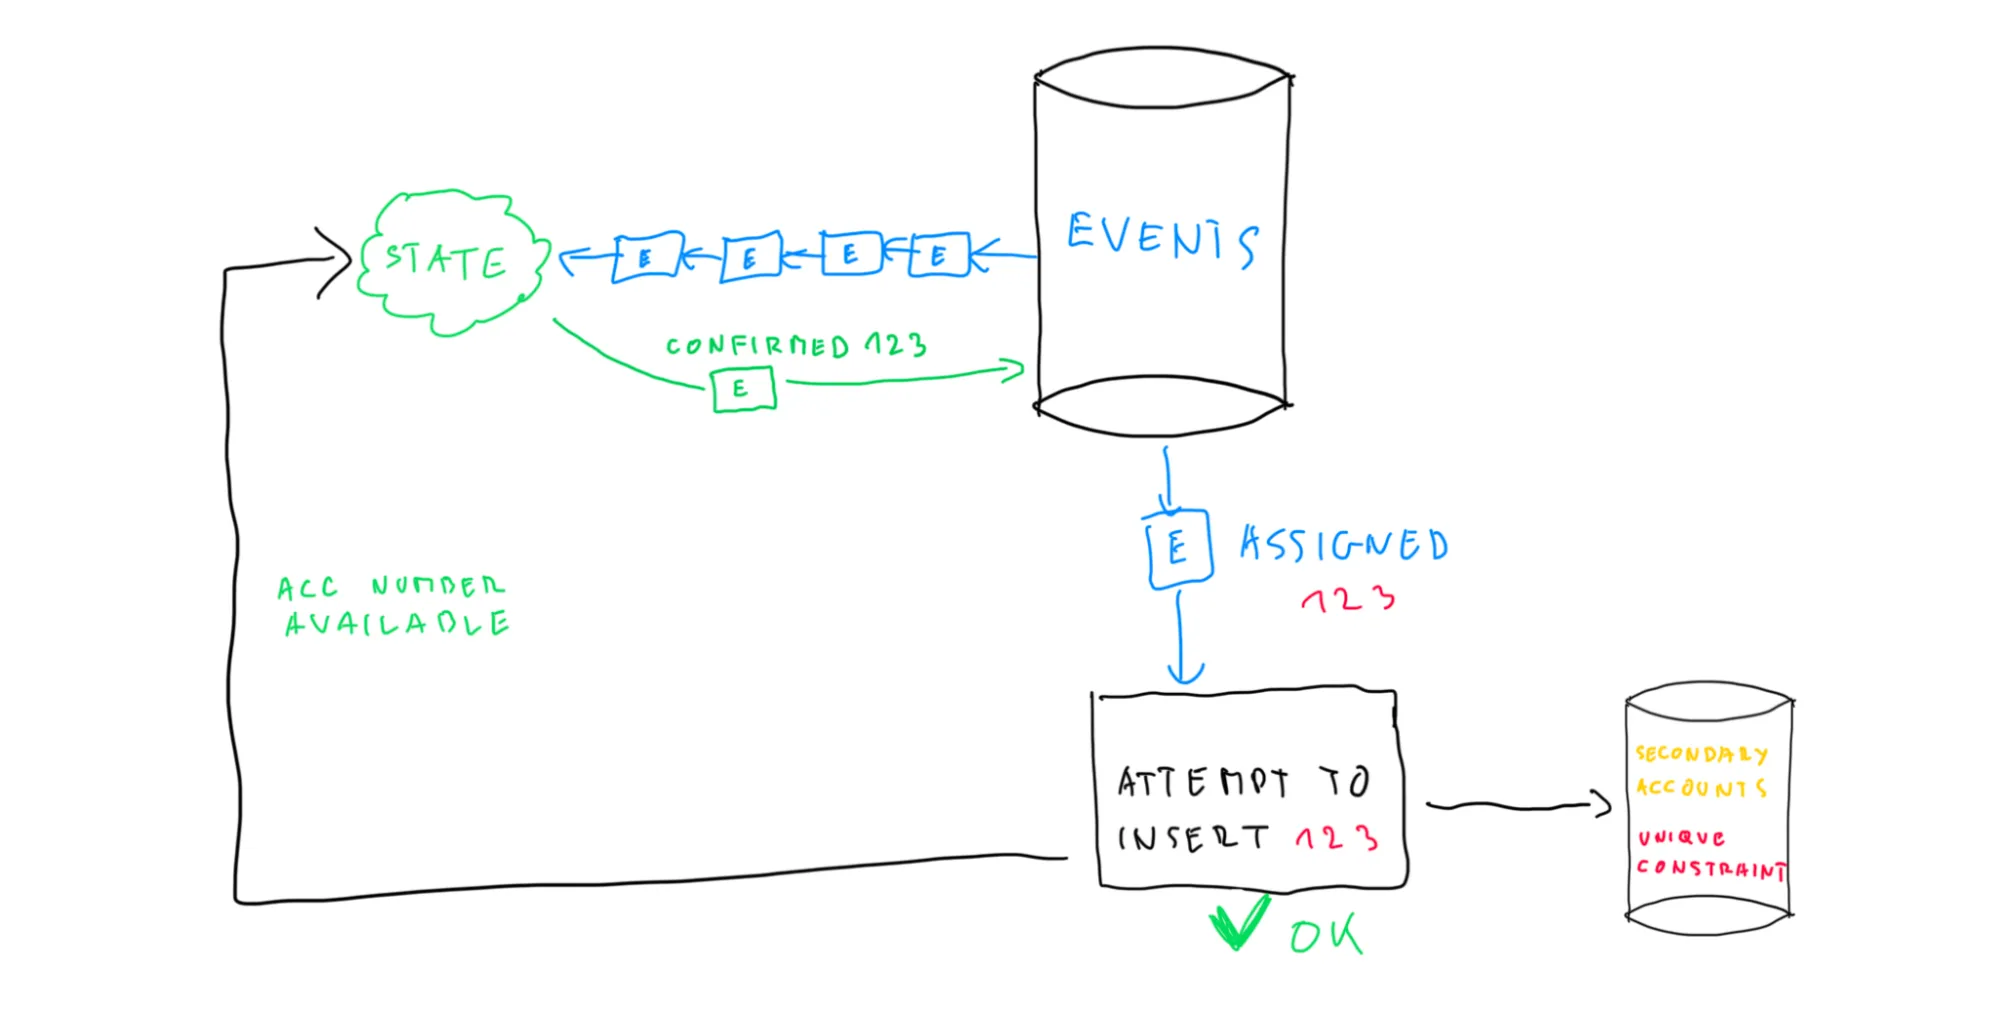
نجح الإدراج، لا تكرار. أرسل أمرًا/رسالة OK
أما إذا فشل الإدراج بسبب انتهاك قيد التفرّد – أي أن رقم الحساب مستخدم بالفعل – فنرسل أمر RejectSecondaryAccountNumberChange (أو، مرة أخرى كإشعار، SecondaryAccountNumberDuplicated)، مما يؤدي إلى حدث مثل SecondaryAccountNumberChangeRejected.هنا نلغي التغيير المعلّق في الكيان وعلى الأرجح نُعلم المستخدم بذلك.
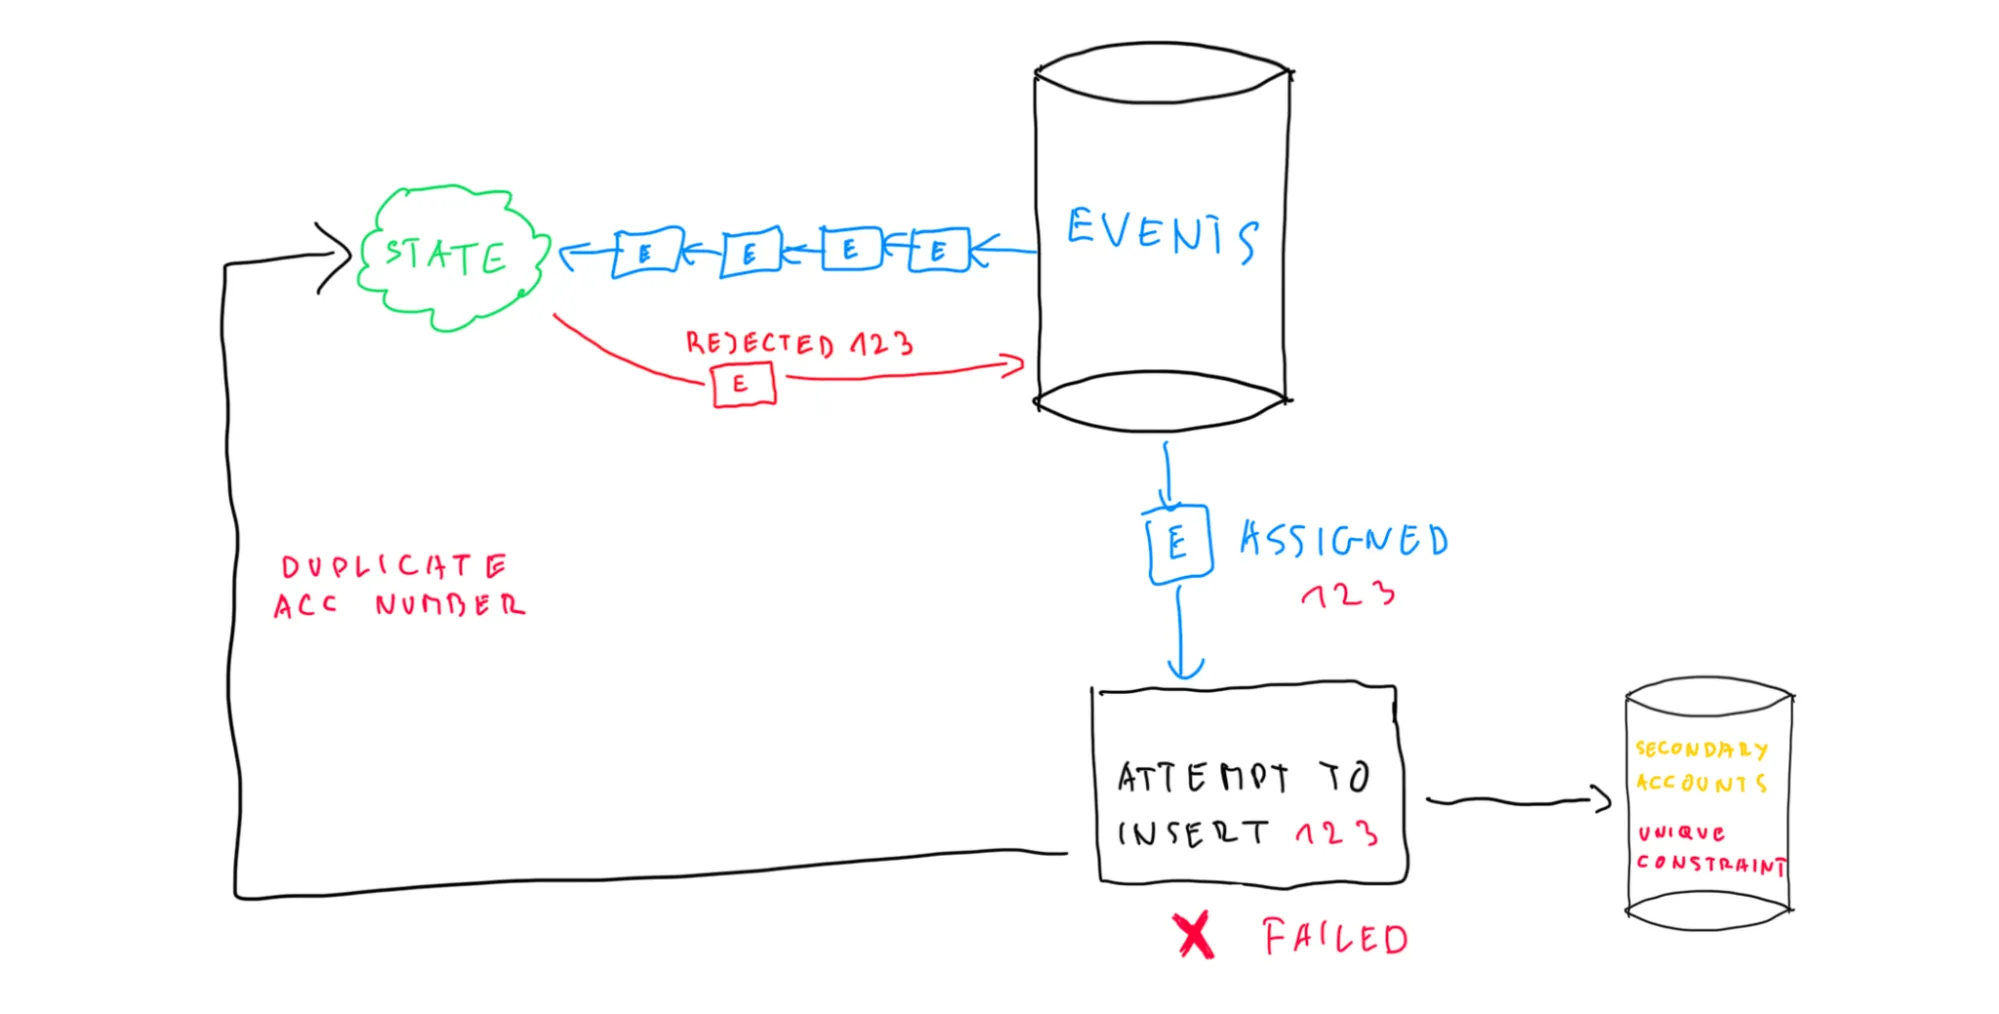
فشل الإدراج، انتُهك قيد التفرّد. أرسل أمرًا/رسالة NOT OK
يمكن لهذا الإسقاط أن يخدم أيضًا كفحص أولي للتفرّد، لكن بسبب الاتساق النهائي يجب أن تبقى العملية الموصوفة أعلاه كاملة، لأن مثل هذا الفحص لا يمكنه إلا تقليل احتمال التكرار (لا استبعاده تمامًا) – مثلًا بتحسين تجربة المستخدم ومنع المستخدمين من إرسال أرقام حسابات مأخوذة بالفعل.
نعم، إنها رقصة معقدة وقدر لا بأس به من الشيفرة، إذ يجب تنفيذ هذه العملية بأكملها، لكنها متاحة إن احتجتها. هل ينبغي تطبيقها بلا تمييز وفي كل مكان، تمامًا كـ event sourcing أو أي أداة أخرى تقريبًا؟ بالتأكيد لا. فالأمر كله مقايضات – تخسر شيئًا في مكان لتربح شيئًا في مكان آخر. اعرف الخيارات المتاحة لك واتخذ قرارات مستنيرة قائمة على الدوافع الحقيقية التي تواجهها.
نقطة أخيرة: إذا كانت كل الأحداث التي أصدرناها أعلاه لمعالجة حالة تفرّد بسيطة تشعرك بعدم الارتياح، فتذكّر أنها لا يلزم أن تكون كلها عامة. فـ event sourcing نهج محلي لإدارة الحالة، وكيفية تواصلك مع العالم الخارجي متروكة لك. ربما تريد أن تعلم الأنظمة الأخرى بكل محاولة لتغيير رقم الحساب الثانوي، أو ربما تريد الإعلان عن التغيير فقط حين تتأكد أنه طُبّق فعلًا. وربما تستحق الأحداث العامة والخاصة فصلًا خاصًا بها في السلسلة، أتمنى كتابته قريبًا.
الخلاصة
كما تبيّن أعلاه، فإن الادعاء بأن event sourcing (وCQRS) يدور بالكامل وحصريًا حول الاتساق النهائي لا يصمد. فهو يتيح الاتساق النهائي بالتأكيد ويستفيد منه كليًا في المواقف المناسبة، لكنه لا يشترطه. لقد رأينا أنه يمكن بناء أنظمة event sourcing باتساق صارم حين يلزم ذلك. ومرة أخرى، الأدوات موجودة، ويعود إليك فهم نقاط القوة والضعف في كل منها واختيار ما يناسب بحكمة.
في الجزء التالي سنستكشف خيارات التخزين المتاحة للأنظمة المبنية على event sourcing – أيها نختار ومتى. ترقبوا!