Triton Inference Server. խորհուրդներ և հնարքներ
Triton-ի օգտակար հրամանների և կոնֆիգուրացիաների «խաբեության թերթիկ», որին կարելի է վերադառնալ ամեն անգամ, երբ աշխատում եք այս գործիքի հետ։
Սա Triton Inference Server-ի մասին իմ երկրորդ գրառումն է։ Առաջինը ներկայացնում էր դրա հնարավորություններն ու կիրառման դեպքերը։ Եթե չեք կարդացել և այս տեքստի որոշ հասկացություններ ձեզ համար անհասկանալի են, խորհուրդ եմ տալիս սկզբում անցնել դրա միջով։
Այս գրառման մեջ կգտնեք խորհուրդներ ու հնարքներ, օգտակար հրամանների «խաբեության թերթիկ» և կոդի օրինակներ՝ համակարգչային տեսողության մոդելների տարբեր կոնֆիգուրացիաների benchmark-ի համար։ Այն ավելի տեխնիկական է, քան նախորդը. կարդալուց հետո կիմանաք կոնկրետ հրամաններ՝ Triton-ով սպասարկվող մոդելները օպտիմալացնելու և կարգավորելու համար։
Նշում. ստորև բերված բոլոր հրամաններում օգտագործվում են կոնտեյներներ 22.04 կամ 22.11 տարբերակներով, բայց ազատ զգացեք ընտրել ձեզ հարմար ցանկացած տարբերակ։ Այս կոնտեյներները կախված են CUDA դրայվերներից, ուստի ստորև օգտագործվող տարբերակները կարող են ձեր միջավայրում չաշխատել։
Խաբեության թերթիկներ
- Triton-ի գործարկումը docker կոնտեյներում
Կարևոր նշում. պետք է փոխանցել ընթացիկ դիրեկտորիայի բացարձակ ուղին և միացնել (mount) այն կոնտեյների ֆայլային համակարգում նույն ուղով։ Եթե դա չանեք, Triton-ը չի գտնի model-repository-ի մոդելները
-
model-analyzer գործիքի օգտագործումը docker կոնտեյներում
-
Գլոբալ պատասխանների քեշի սահմանումը
Մոդելի պատասխանների քեշի սահմանումը
-
config.pbtxt-ում.
-
Մոդելների հարցման (poll) միջակայքի սահմանումը
-
model-repository-ի բնորոշ կառուցվածքը
-
Դինամիկ բաչինգի սահմանումը (այստեղ 100 միկրովայրկյանը այն ժամանակն է, որն օգտագործվում է դինամիկ բաչը հավաքելու համար)
config.pbtxt-ում. -
Մոդելի առավելագույն բաչի չափի սահմանումը (այստեղ առավելագույն բաչի չափը 8 է)
config.pbtxt-ում. -
Մոդելի warmup
Այս տողը դրեք config.pbtxt-ում։ key դաշտը պետք է համընկնի սահմանված input-ի անվանը, տեսակին և dims-ին։
-
TensorRT օպտիմալացում (կիսաճշտության մոդելի օգտագործմամբ և workspace-ի առավելագույն չափի սահմանմամբ)
-
OpenVINO օպտիմալացում (CPU-ով աշխատող մոդելների համար)
-
TF JIT օպտիմալացում
-
TensorFlow XLA օպտիմալացումներ
-
TensorFlow՝ ավտոմատ FP16 օպտիմալացմամբ
Խորհուրդներ և հնարքներ – ինչ կցանկանայի իմանալ Triton-ի հետ փորձարկելուց առաջ
-
model-analyzer-ը docker կոնտեյներում օգտագործելիս հիշեք, որ model-repository-ն պարունակող volume-ը պետք է միացնել կոնտեյների մեջ նույն ուղով, ինչ հոստի ֆայլային համակարգում։ Եթե դա չանեք, model-analyzer-ը դժվարանալու է գտնել տեղակայված մոդելները.
-
Մոդելի արտահանումը TensorRT-ի կատարվում է այս docker պատկերով.
Տարբերակների վալիդացիայի պատճառով չափազանց կարևոր է, որ tensorrt կոնտեյները ունենա tritonserver-ի հետ նույն տարբերակը։ Այլ կերպ ասած, Triton-ը չի սպասարկի մոդել, որն արտահանվել է TensorRT-ի այլ տարբերակով։
-
ONNX մոդելը TensorRT-ի փոխարկելու հիմնական հրամանը.
-
Մոդելը կիսաճշտությամբ արտահանելու համար կարող եք ավելացնել այս դրոշները.
MobileNetV3-ի վրա այս օպտիմալացումը FP32 ONNX մոդելի համեմատ տվեց մինչև 2 անգամ արագացում latency-ի և throughput-ի մեջ։
- Մոդելը քվանտացված ձևաչափով (որոշ կշիռներ պահվում են որպես int8) արտահանելու համար օգտագործեք այս դրոշները.
MobileNetV3-ի վրա այս օպտիմալացումը FP32 ONNX մոդելի համեմատ տվեց մինչև 2–3 անգամ արագացում latency-ի և throughput-ի մեջ։
- Դինամիկ բաչի չափով մոդելի արտահանումը պահանջում է trtexec ծրագրին փոխանցել 3 պարամետր։ ImageNet-ի վրա ուսուցանված մոդելի համար դրանք կարող են այսպիսին լինել.
MobileNetV3-ի վրա այս օպտիմալացումը մեկ բաչով (single batch) աշխատող մոդելների համեմատ տվեց մինչև 2 անգամ արագացում latency-ի և throughput-ի մեջ։
- Single batch ռեժիմում ավելի բարձր throughput և ավելի ցածր latency ստանալու համար պետք է օգտագործել բացահայտ (explicit) բաչի չափ։
Բացահայտ բաչի չափով մոդելը ապահովեց մոտ 20%-ով ավելի բարձր throughput և 16%-ով ավելի կարճ inference ժամանակ, քան դինամիկ բաչի չափով մոդելը։
- Մոդելը ONNX-ի արտահանելիս (օրինակ՝ PyTorch կոդից) դինամիկ բաչի չափով, պետք է սահմանել _dynamicaxes պարամետրը.
Մուտքերի և ելքերի անունների սահմանումը ձեզ ավելի շատ վերահսկողություն է տալիս պարամետրերի անունների նկատմամբ inference-ի ժամանակ։ Եթե դա բաց թողնեք, կօգտագործվեն մոդելի շերտերի անուններից ստացված անունները։
Գործընթացը ավելի լավ հասկանալու համար նայեք PyTorch-ի օրինակին։
- config.pbtxt:
Սահմանեք մոդելի _max_batchsize-ը ողջամիտ արժեքով, որը մեծ է կամ հավասար 1-ի։ Եթե մոդելը չի աջակցում դինամիկ բաչեր, օրինակ՝ TensorRT-ի արտահանված մոդել՝ 1 բացահայտ բաչի չափով, այս արժեքը պետք է սահմանել 1։
Երբ _max_batchsize-ը մեծ է 1-ից, dims-ի առաջին չափողականությունը լռելյայն միշտ -1 է։ Եթե սահմանեք dims: [3, 224, 224], Triton-ը ինքը կավելացնի -1-ը ցուցակի սկզբում։
- model-analyzer.
Երբ docker կոնտեյներում մոդելների վերլուծություն եք անում և կարգավորում Triton-ի կոնֆիգուրացիայի պարամետրերը, հիշեք model-repository-ով volume-ը կոնտեյների ներսում միացնել նույն ուղով, ինչ հոստ մեքենայի վրա։ Եթե դա չանեք, _perfanalyzer-ը և _modelanalyzer-ը դժվարանալու են գտնել մոդելները։
_modelanalyzer-ի փաստաթղթերը և պարամետրերի ամբողջական ցանկը հասանելի են այստեղ։
-
Հրամանի օրինակ.
-
_perfanalyzer.
Պատկերների հետ աշխատող մոդելների վերլուծությունը բարդ է, երբ հարցումներում հնարավոր չէ պատահական տվյալներ ուղարկել։ Այդ դեպքում կարող եք պատրաստել ֆայլ՝ հարցման մեջ ուղարկելու նմուշային տվյալներով։ Ֆայլը հետևում է նախապես սահմանված ձևաչափի, որտեղ տվյալները հարթ ցուցակ են, և նշված է թիրախ տենզորի shape-ը։ Ստորև բերված օրինակում ես ուզում եմ ուղարկել (640, 480, 3) shape-ով պատկեր, բայց «content» դաշտում պատկերը պետք է տամ որպես արժեքների հարթ ցուցակ՝ այստեղ (921600,) shape-ով։
-
data.jsonֆայլում պահված նմուշային տվյալներով հրամանն այսպիսի տեսք ունի. -
Ensemble model
Triton-ի պահանջները բավարարելու համար պետք է ստեղծել դատարկ դիրեկտորիա՝ տարբերակով։
Ensemble model
Որպես օրինակ՝ ահա թե ինչպես է երևում ViT մոդելի տեղակայումը որպես Python մոդել.
Triton-ը պահանջում է initialize և execute ֆունկցիաները։ Սկզբնավորման ժամանակ մոդելը և feature extractor-ը բեռնվում են huggingface-ից։ execute-ը կատարում է որոշ նախամշակում, կանչում է մոդելները և վերադարձնում արդյունքները։
Դրա config.pbtxt-ը.
Իսկ դիրեկտորիան տեսք ունի այսպես.
Հաջորդիվ ցույց եմ տալիս ViT մոդելը, տեղակայված որպես ensemble model՝ նախա- և հետամշակումը առանձնացված.
_ensemblemodel/config.pbtxt.
preprocessing/1/model.py.
preprocessing/config.pbtxt.
vit/config.pbtxt.
Դիրեկտորիայի կառուցվածքը տեսք ունի այսպես.
Համեմատեք այս երկու տեղակայման կոնֆիգուրացիաները։ Պարզ է, որ հիմնական մոդելի օպտիմալացումը արագացնում է inference pipeline-ը մինչև մոտ 30%-ով։
Benchmark-ի կոդը
Benchmark-ի համար ես ընտրեցի MobileNetV2։ Ստորև կգտնեք երկու աղյուսակ՝ արդյունքներով՝ տարբեր բաչի չափերի համար։
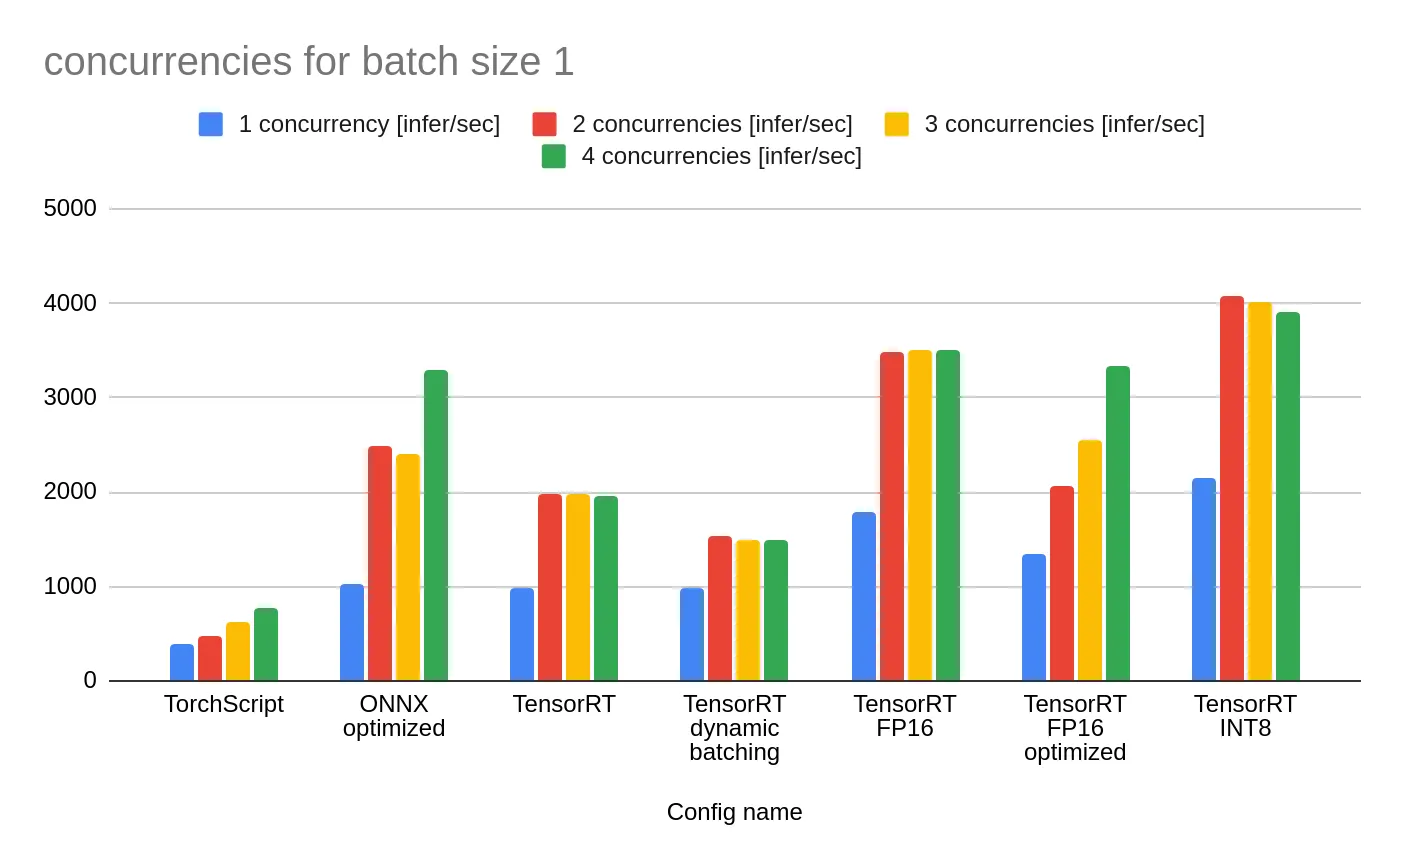
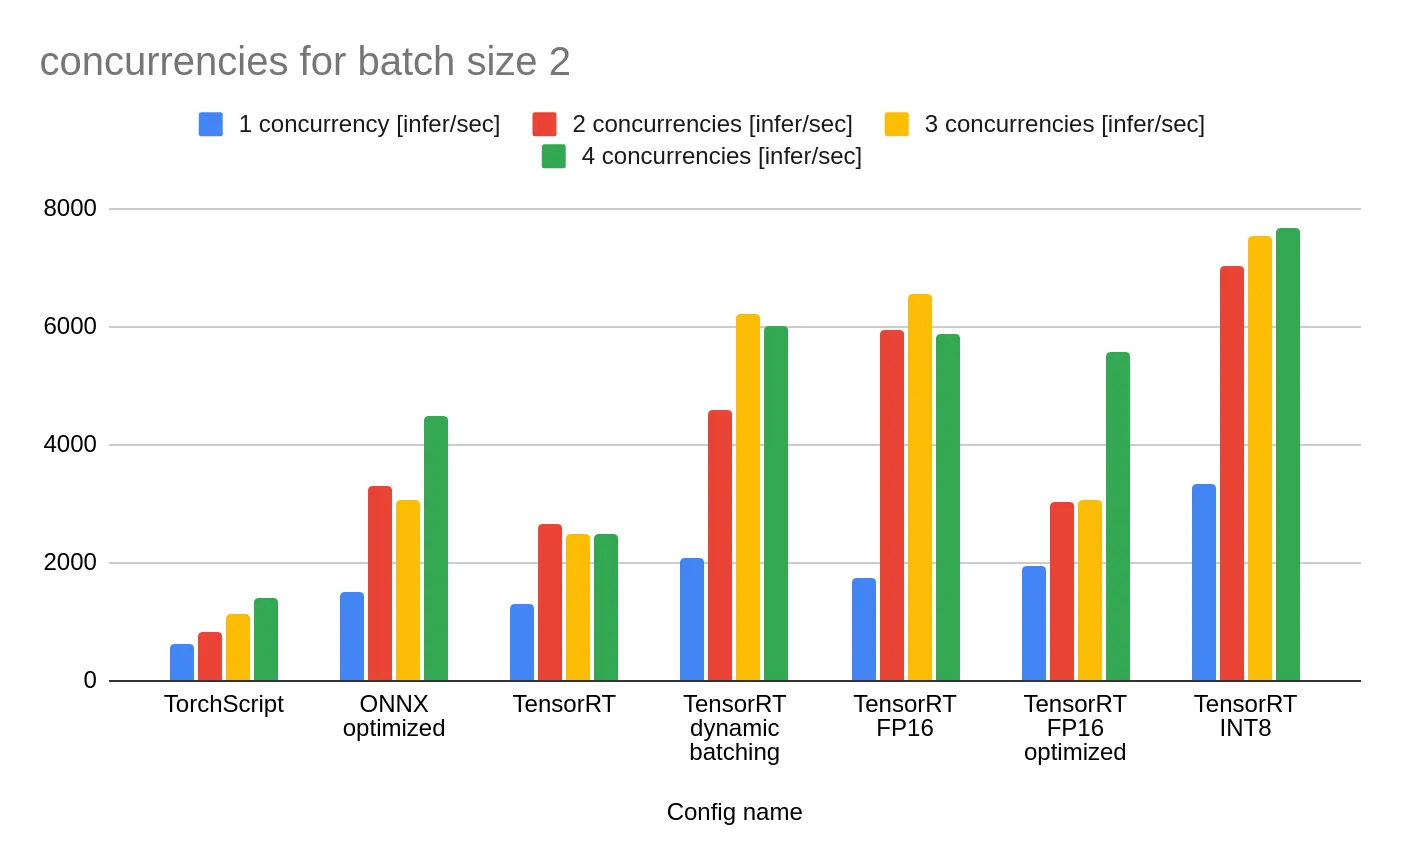
Անսպասելի չէ, որ առանց օպտիմալացումների TorchScript-ը այս համեմատության մեջ ամենավատն է աշխատում։ Վերևի աղյուսակը ցույց է տալիս, որ _batchsize-ի մեծացումը dynamic batching-ի հետ բերում է ավելի բարձր throughput։ Մոդելի փոխարկումը FP16-ի և INT8-ի տալիս է նկատելի արագացում, թեև կարող է նվազեցնել մոդելի արդյունավետությունը։ Հետաքրքիր է, որ TensorRT FP16-ը ապահովում է ավելի բարձր throughput, քան TensorRT FP16 optimized-ը։ Առաջինը արտահանվել էր որպես կիսաճշտության մոդել, իսկ երկրորդը՝ լրիվ ճշտությամբ և Triton-ում կարգավորվել էր FP16-ով աշխատելու համար։ Վերևի գծապատկերը ենթադրել է տալիս, որ եթե ուզում եք կիսաճշտության մոդել, ավելի լավ է այն արտահանել այդ ձևով, քան ապավինել Triton-ի փոխարկմանը։ Ինչպես միշտ, արդյունքները տարբերվում են սարքավորումից սարքավորում, ուստի յուրաքանչյուր կոնֆիգուրացիա պետք է փորձարկեք ձեր մեքենայի վրա՝ նախքան տեղակայելը։
Ամփոփում
Այս գրառումը առաջարկում է Triton-ի օգտակար հրամանների և կոնֆիգուրացիաների «խաբեության թերթիկ», որին կարելի է վերադառնալ ամեն անգամ, երբ աշխատում եք այս գործիքի հետ։ Այն ներառում է կոդ և benchmark-ներ համակարգչային տեսողության մոդելի տարբեր կոնֆիգուրացիաների համար։ Ընթերցողը հետևեց բարդ մոդելի օպտիմալացման գործընթացին՝ նախա- և հետամշակման կոդը մոդելի inference-ից առանձնացնելու միջոցով։ Հուսով եմ՝ այսօր նոր բան սովորեցիք, և խրախուսում եմ փորձարկել Triton-ը։ Կասկածում եմ՝ դուք երկուսդ կհամերաշխվեք 🙂