Triton Inference Server: نصائح وحيل
ورقة مرجعية بأوامر وإعدادات Triton المفيدة التي ستعود إليها كلما عملت مع هذه الأداة.
هذه تدويني الثانية عن Triton Inference Server. وقد تناولت الأولى ميزاته وحالات استخدامه. إذا لم تقرأها وكانت بعض المفاهيم في هذا النص غير واضحة لك، فأنصحك بالاطلاع عليها أولًا.
في هذه التدوينة ستجد نصائح وحيلًا، وورقة مرجعية بأوامر مفيدة، وأمثلة برمجية لقياس أداء إعدادات مختلفة لنماذج الرؤية الحاسوبية. وهي أكثر تقنية من سابقتها: بعد قراءتها ستعرف أوامر محددة لتحسين النماذج التي يخدمها Triton وإعدادها.
ملاحظة: جميع الأوامر أدناه تستخدم حاويات بالإصدارين 22.04 أو 22.11، لكن يمكنك اختيار أي إصدار يناسبك. تعتمد هذه الحاويات على تعريفات CUDA، لذا قد لا تعمل الإصدارات التي أستخدمها أدناه في بيئتك.
أوراق مرجعية
- تشغيل Triton في حاوية docker
ملاحظة مهمة: يجب أن تمرّر المسار المطلق للمجلد الحالي وتركّبه (mount) بالمسار نفسه في نظام ملفات الحاوية. وإلا فلن يجد Triton النماذج في model-repository
-
استخدام أداة model-analyzer في حاوية docker
-
تعريف ذاكرة تخزين مؤقت عامة للاستجابات
تعريف ذاكرة تخزين مؤقت لاستجابات النموذج
-
في config.pbtxt:
-
تعريف الفاصل الزمني لفحص النماذج
-
بنية model-repository نموذجية
-
تعريف التجميع الديناميكي للدفعات (هنا 100 ميكروثانية هي الزمن المستخدم لتجميع دفعة ديناميكية)
في config.pbtxt: -
تعريف الحد الأقصى لحجم دفعة النموذج (هنا الحد الأقصى لحجم الدفعة هو 8)
في config.pbtxt: -
تسخين النموذج
ضع هذا السطر في config.pbtxt. يجب أن يطابق الحقل key اسم input المعرَّف ونوعه وأبعاده.
-
تحسين TensorRT (باستخدام نموذج بنصف الدقة وتحديد الحد الأقصى لمساحة العمل)
-
تحسين OpenVINO (للنماذج التي تعمل على CPU)
-
تحسين TF JIT
-
تحسينات TensorFlow XLA
-
TensorFlow مع تحسين FP16 التلقائي
نصائح وحيل – ما كنت أتمنى معرفته قبل تجربة Triton
-
عند استخدام model-analyzer في حاوية docker، تذكّر تركيب الحجم الذي يحتوي على model-repository بالمسار نفسه في الحاوية كما هو في نظام ملفات المضيف. وإلا فسيواجه model-analyzer صعوبة في تحديد موقع النماذج المنشورة:
-
يتم تصدير النموذج إلى TensorRT باستخدام صورة docker هذه:
بسبب التحقق من الإصدارات، من الضروري أن يكون لحاوية tensorrt الإصدار نفسه الخاص بـ tritonserver. بعبارة أخرى، لن يخدم Triton نموذجًا صُدِّر بإصدار TensorRT مختلف.
-
أمر أساسي لتحويل نموذج ONNX إلى TensorRT:
-
لتصدير النموذج بنصف الدقة، يمكنك إضافة هذه الأعلام:
على MobileNetV3، حقق هذا التحسين تسريعًا يصل إلى مرتين في زمن الاستجابة والإنتاجية مقارنة بنموذج ONNX بدقة FP32.
- لتصدير النموذج بصيغة مكمّمة (تُخزَّن فيها بعض الأوزان بصيغة int8)، استخدم هذه الأعلام:
على MobileNetV3، حقق هذا التحسين تسريعًا يصل إلى 2–3 مرات في زمن الاستجابة والإنتاجية مقارنة بنموذج ONNX بدقة FP32.
- يتطلب تصدير النموذج بحجم دفعة ديناميكي تمرير 3 معاملات إلى برنامج trtexec. وبالنسبة لنموذج مدرَّب على ImageNet قد تبدو كما يلي:
على MobileNetV3، حقق هذا التحسين تسريعًا يصل إلى مرتين في زمن الاستجابة والإنتاجية مقارنة بالنماذج العاملة بوضع الدفعة المفردة.
- للحصول على إنتاجية أعلى وزمن استجابة أقل في وضع الدفعة المفردة، ينبغي استخدام حجم دفعة صريح.
حقق النموذج ذو حجم الدفعة الصريح إنتاجية أعلى بنحو 20% وزمن استدلال أقصر بنسبة 16% من النموذج ذي حجم الدفعة الديناميكي.
- عند تصدير نموذج إلى ONNX (مثلًا من شيفرة PyTorch) بحجم دفعة ديناميكي، تحتاج إلى ضبط المعامل _dynamicaxes:
يمنحك تعريف أسماء المدخلات والمخرجات تحكمًا أكبر في أسماء المعاملات وقت الاستدلال. وإذا تخطيت ذلك، فستُستخدم أسماء مشتقة من أسماء طبقات النموذج.
لفهم العملية بشكل أفضل، ألقِ نظرة على المثال الخاص بـ PyTorch.
- config.pbtxt:
اضبط _max_batchsize للنموذج على قيمة معقولة أكبر من أو تساوي 1. وإذا كان النموذج لا يدعم الدفعات الديناميكية – مثل نموذج صُدِّر إلى TensorRT بحجم دفعة صريح يساوي 1 – فينبغي ضبط هذه القيمة على 1.
عندما يكون _max_batchsize أكبر من 1، يكون البُعد الأول في _dims _ هو -1 دائمًا افتراضيًا. وإذا عرّفت dims: [3, 224, 224]، فسيضيف Triton القيمة -1 في بداية القائمة نيابةً عنك.
- model-analyzer:
عندما تجري تحليل النموذج وتضبط معاملات إعدادات Triton في حاوية docker، تذكّر تركيب الحجم الذي يحتوي على model-repository داخل الحاوية بالمسار نفسه كما على الجهاز المضيف. وإلا فسيجد _perfanalyzer و_modelanalyzer صعوبة في العثور على النماذج.
الوثائق والقائمة الكاملة بمعاملات _modelanalyzer متاحة هنا.
-
مثال على أمر:
-
_perfanalyzer:
يصبح تحليل النماذج التي تعمل على الصور صعبًا عندما لا يمكنك إرسال بيانات عشوائية في الطلبات. في هذه الحالة، يمكنك تجهيز ملف يحتوي على بيانات عيّنة لإرسالها في الطلب. يتبع الملف صيغة محددة مسبقًا، مع البيانات كقائمة مسطحة من القيم وشكل المتجه المستهدف. في المثال أدناه أريد إرسال صورة بالشكل (640, 480, 3)، لكن عليّ في الحقل “content” تقديم الصورة كقائمة مسطحة من القيم – هنا بالشكل (921600,).
-
يبدو الأمر الذي يستخدم بيانات عيّنة مخزنة في ملف
data.jsonكما يلي: -
نموذج المجموعة (Ensemble)
لتلبية متطلبات Triton، عليك إنشاء مجلد فارغ باسم الإصدار.
نموذج المجموعة (Ensemble)
كمثال، إليك شكل نشر نموذج ViT كنموذج Python:
يتطلب Triton الدالتين initialize وexecute. أثناء التهيئة يتم تحميل النموذج ومستخرج الميزات من huggingface. وتقوم execute ببعض المعالجة المسبقة، وتستدعي النماذج، وتعيد النتائج.
ملف config.pbtxt الخاص به:
ويبدو المجلد كما يلي:
بعد ذلك، أعرض عليك نموذج ViT منشورًا كنموذج مجموعة، مع فصل المعالجة المسبقة واللاحقة.
_ensemblemodel/config.pbtxt:
preprocessing/1/model.py:
preprocessing/config.pbtxt:
vit/config.pbtxt:
وتبدو بنية المجلدات كما يلي:
قارن بين إعدادي النشر هذين. من الواضح أن تحسين النموذج الأساسي يسرّع مسار الاستدلال بنحو 30% كحد أقصى.
شيفرة قياس الأداء
لقياس الأداء اخترت MobileNetV2. ستجد أدناه جدولين بنتائج لأحجام دفعات مختلفة.
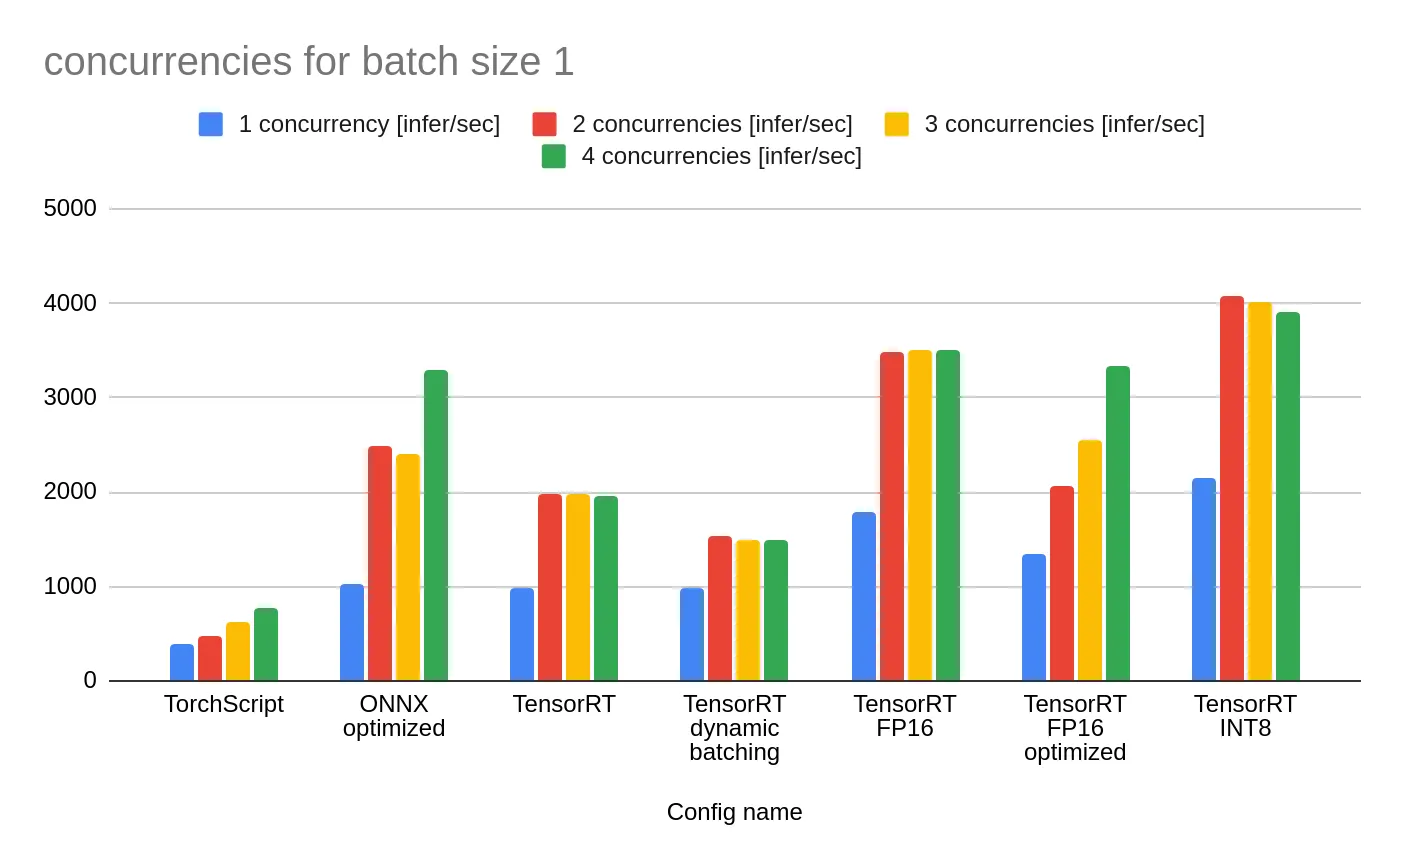
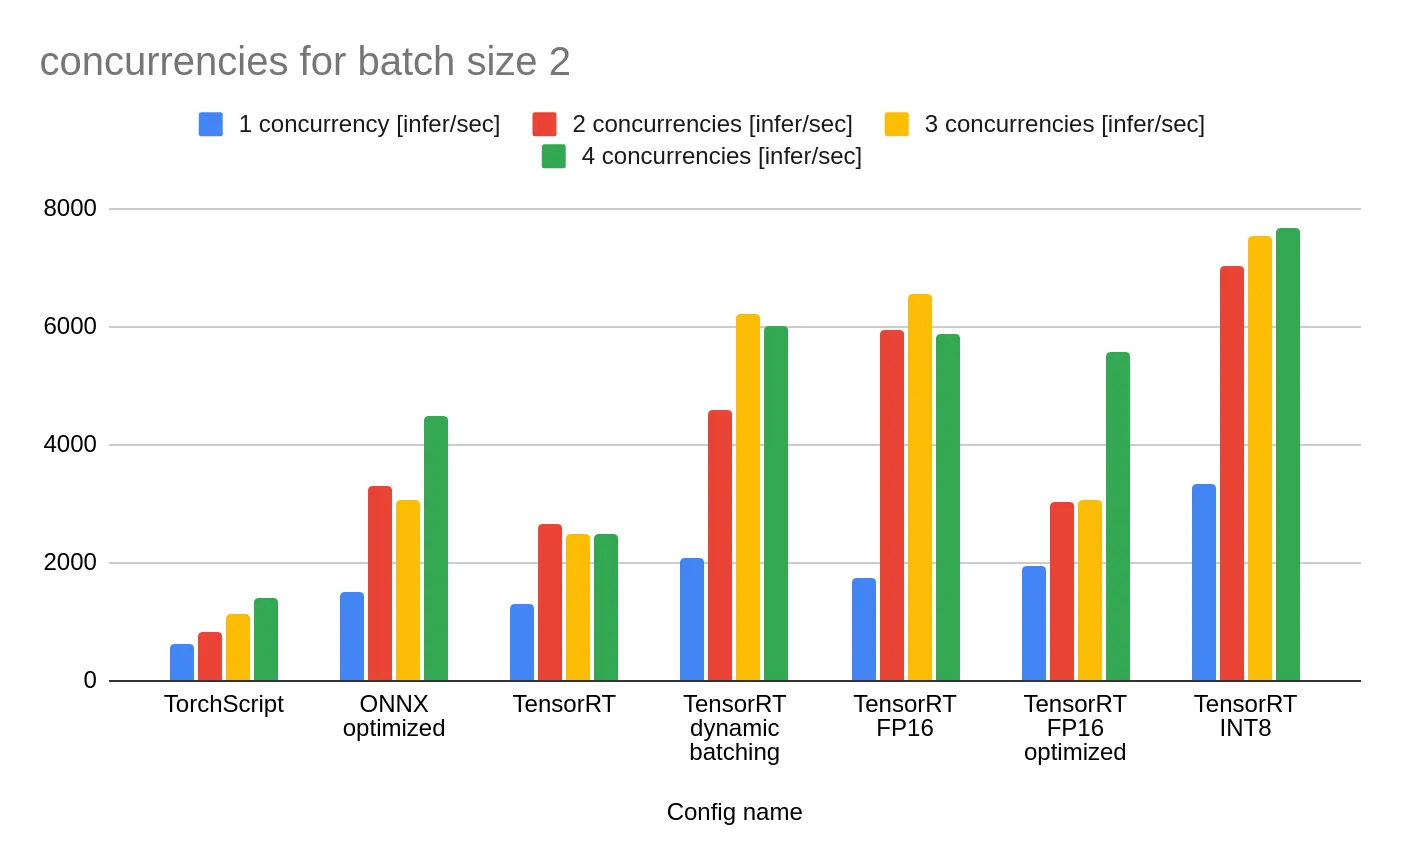
كما هو متوقع، أدى TorchScript دون أي تحسينات أسوأ أداء في هذه المقارنة. ويُظهر الجدول أعلاه أن رفع _batchsize مع dynamic batching يؤدي إلى إنتاجية أعلى. أما تحويل النموذج إلى FP16 وINT8 فيمنح تسريعًا ملحوظًا، وإن كان قد يخفض أداء النموذج. والمثير للاهتمام أن TensorRT FP16 حقق إنتاجية أعلى من TensorRT FP16 optimized. فالأول صُدِّر كنموذج بنصف الدقة، بينما صُدِّر الثاني بدقة كاملة وضُبط في Triton ليعمل بـ FP16. ويوحي الرسم أعلاه بأنك إذا أردت نموذجًا بنصف الدقة، فمن الأفضل تصديره بهذه الصيغة بدلًا من الاعتماد على تحويل Triton. وكما هو الحال دائمًا، تختلف النتائج بين أنواع العتاد، لذا ينبغي أن تختبر كل إعداد على جهازك قبل النشر.
الخلاصة
تقدّم هذه التدوينة ورقة مرجعية بأوامر وإعدادات Triton المفيدة التي ستعود إليها كلما عملت مع هذه الأداة. وتتضمن شيفرة ومقاييس أداء لإعدادات مختلفة لنموذج رؤية حاسوبية. وقد تابع القارئ عملية تحسين نموذج معقد بفصل شيفرة المعالجة المسبقة واللاحقة عن استدلال النموذج نفسه. آمل أن تكون قد تعلمت شيئًا جديدًا اليوم، وأشجعك على تجربة Triton. وأظن أنكما ستتفاهمان 🙂