Ի՞նչ սովորեցի Kafka-ի մասին Confluent Certified Developer for Apache Kafka (CCDAK) սերտիֆիկատ ստանալիս
Ինչ ստացա Apache Kafka-ի Confluent Certified Developer սերտիֆիկատին պատրաստվելիս։
CCDAK սերտիֆիկատը վերաբերում է Kafka հավելվածների կառուցմանը և նախատեսված է այն մշակողների համար, որոնք արդեն ունեն Apache Kafka-ի հետ աշխատելու որոշակի հիմնական գործնական փորձ։ Այս գրառման մեջ կիսվում եմ նրանով, ինչ սովորեցի Apache Kafka-ի Confluent Certified Developer սերտիֆիկատին պատրաստվելիս։
Աղբյուրը՝ certificates.confluent.io
Երբ սերտիֆիկատը իմաստ ունի
CCDAK-ը խելամիտ ընտրություն է, եթե ուզում եք ապացուցել Kafka-ի ձեր առաջադեմ ընդհանուր գիտելիքը կամ խորանալ մանրամասների մեջ և պատշաճ կերպով հասկանալ, թե ինչպես է այն աշխատում ներսից և ինչից է կազմված։ Քննության պաշտոնական նախապայմաններից մեկը A minimum of 6-12 months hands-on experience using Confluent products է, ուստի պետք է գոնե Kafka-ի հիմունքները իմանաք։
Գործնական եզրահանգումներ CCDAK քննությանը պատրաստվելուց
Ինչպես ես եմ տեսնում՝ CCDAK քննությունը առավելապես կենտրոնանում է Kafka-ի ենթակառուցվածքի, դրա կիրառման վայրերի և stream processing-ը որպես հայեցակարգ հասկանալու վրա։ Այն նաև ստուգում է, թե արդյոք դուք գիտեք և կարող եք իրական իրավիճակներում կիրառել Kafka-ի հետ կապված տարբեր արտադրանքներ, ինչպիսիք են Kafka Connect-ը կամ Kafka Streams-ը, ինչպես նաև Confluent-ի արտադրանքներ, օրինակ՝ Confluent Schema Registry-ն։
Ինձ համար ամենամեծ ձեռքբերումը Kafka-ի producer-ների, broker-ների և consumer-ների ներսից աշխատելու ու կարգավորվելու ավելի խորը ըմբռնումն էր։ Ես կարողացա զարգացնել արդեն ծանոթ թեմաներս, ինչպիսիք են Kafka-ի ընդհանուր ենթակառուցվածքը կամ Connect-ը, բայց նաև շատ բան սովորեցի այն մասին, ինչին նախկինում հազիվ էի դիպչել՝ ինչպես ksqlDB հավելվածների կառուցումը և Kafka իրադարձությունների մշակումը SQL-ին նման հարցումներով, կամ նույնիսկ հասկացություններ, որոնց մասին երբեք չէի լսել, օրինակ՝ MirrorMaker-ը։
Գնահատեցի, որ CCDAK քննությունն անցնելը պահանջում է որոշ գործնական know-how՝ Kafka-ն տարբեր արտադրողականության նպատակների համար կարգավորելու մասին՝ throughput, latency, հուսալիություն և այլն։
Ես սովորել եմ հիմնականում Kafka: The Definitive Guide-ից (անվճար ներբեռնելու համար), Kafka փաստաթղթերից և ինքնուրույն անցնելու Confluent Trainings-ից։ Դրանք բոլորը առաջարկում էին լավ կառուցվածքավորված ուսուցման ուղի, որը ինձ վարեց Kafka-ի հասկացությունների միջով կարգավորված ձևով։ Նյութը կոնկրետ թեմաների և բաղադրիչների բաժանելը հեշտացնում էր հետևելը։
Խորհուրդ եմ տալիս նաև մեր հիանալի Kafka Visualization գործիքը, որը թույլ է տալիս ինքներդ փորձարկել և մոդելավորել, թե ինչպես են տվյալները շարժվում կրկնօրինակված Kafka topic-ով։
Հասկացությունները, որոնք ամենահետաքրքիրը գտա CCDAK-ին պատրաստվելիս
Ստորև մի քանի հասկացությունների կարճ ակնարկ է, որոնք անձամբ ես ամենահետաքրքիրն եմ համարում։ Այն ենթադրում է, որ արդեն գիտեք Kafka-ի հիմունքները։
Ինչո՞ւ է Kafka-ն այդքան արագ
Kafka-ն կառուցված է բարձր throughput-ի համար. սա առաջին արտահայտություններից մեկն է, որ հավանաբար կլսեք Apache Kafka-ի մասին։ Այլ կերպ ասած՝ բարձր throughput նշանակում է տվյալների մեծ ծավալներ արագ տեղափոխել՝ գրեթե իրական ժամանակում։ Uber-ը և LinkedIn-ը հայտնի օրինակներ են, որոնք օրական մշակում են տրիլիոնավոր հաղորդագրություններ։ Ուրեմն որտեղի՞ց է գալիս այդ արագությունը։
Հիմնականում Kafka-ի բաշխված ճարտարապետությունից և դրա partitioning մեխանիզմից, որը topic-ները բաժանում է partition-ների։ Քանի որ յուրաքանչյուր partition կարող է վերագրվել որոշակի broker-ի, աշխատանքը կարելի է բաշխել բազմաթիվ հանգույցների վրա, ինչը Kafka-ն դարձնում է շատ մասշտաբավորվող և նրա բարձր throughput-ի հիմնական գաղափարն է։
Այն, ինչ շատ ավելի լավ հասկացա CCKAD սերտիֆիկատին պատրաստվելիս, սակայն, այն էր, թե որքան արդյունավետ է Kafka-ն կառավարում ռեսուրսները, ինչը նրա արագության համար նույնքան կարևոր է։ Երկու հասկացություն հատկապես առանձնանում են՝ Sequential I/O access և Zero Copy սկզբունքը.
Kafka topic-ների հաղորդագրությունները բաժանվում են partition-ների և գրվում անմիջապես Kafka Broker-ի ֆիզիկական պահեստավորման մեջ։ Քանի որ Kafka-ում հաղորդագրությունները անփոփոխ են և կազմում են միայն ավելացվող լոգ (append-only log), Kafka-ն կարող է օգտագործել sequential I/O access pattern՝ տվյալները կարդալով և գրելով հարակից, կարգավորված ձևով։ Սա շատ արդյունավետ է և ավելի լավ է աշխատում, քան random I/O access pattern-ը։
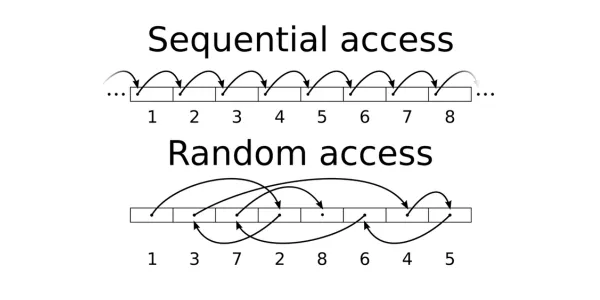
Աղբյուրը՝ wikipedia.org
Սովորական համակարգերում տվյալները հայտնվում են տեղային քեշում, նախքան client-ներին ուղարկվելը։ Քանի որ producer-ը, broker-ը և consumer-ը բոլորն ունեն հաղորդագրության նույն ձևաչափը, Kafka-ն կարող է կիրառել zero-copy օպտիմալացումը։ Այն տվյալների փոխանցումը դարձնում է ավելի արդյունավետ՝ բաց թողնելով ավելորդ հիշողության հատկացումը. տվյալները գնում են անմիջապես ֆայլային համակարգից դեպի socket buffer, և այնտեղից կարող են ուղարկվել consumer client-ներին։
Ինչո՞ւ է replication-ը այդքան կարևոր Kafka-ի ճարտարապետությունում
Replication-ը Kafka-ի հիմնական հնարավորություններից է։ Kafka topic-ի յուրաքանչյուր partition պետք է ունենա replica-ներ՝ ճշգրիտ պատճեններ, բաշխված տարբեր broker-ների վրա՝ դիմացկունություն ապահովելու համար։ Մեկ replica-ն, որը կոչվում է leader, մշակում է բոլոր գրումներն ու ընթերցումները։ Մնացած replica-ները պարզապես պետք է հետևեն և պատճենեն յուրաքանչյուր հաղորդագրություն՝ այն leader-ից վերցնելով. սա է նշանակում leader-ի հետ in-sync լինելը։
Թեև partition leader-ի ընտրությունը և in-sync replica-ների մեխանիզմը կատարվում են ասպարեզի ետևում՝ սերվերի կողմում, դրանք հասկանալը էական է Kafka-ն հասկանալու համար, քանի որ դրանք նրա սխալակայունության հիմքն են։ Սա հավանաբար այն ոլորտն է, որտեղ իմ գիտելիքն ամենաշատն աճեց CCDAK-ին պատրաստվելիս, դիտարկելով այն մի քանի տեսանկյունից՝
Broker-ի տեսանկյունից
Եթե leader replica-ն հոսթ անող broker-ը խափանվում է, Kafka-ն կարող է ավտոմատ կերպով ընտրել նոր leader բոլոր in-sync replica-ների միջից։ Հետաքրքիր է, որ Kafka-ն ունի preferred leader election մեխանիզմ (preferred leader-ը առաջին replica-ն է, որը ղեկավարել է partition-ը, երբ topic-ը առաջին անգամ ստեղծվել է)։ Երբ մեր broker-ը վերադառնում է առցանց, Kafka-ն կարող է partition-ի առաջնորդությունը ավտոմատ վերադարձնել սկզբնական leader-ին։
Ի՞նչ անել, եթե նոր leader ընտրելու պահին in-sync replica հասանելի չէ։ Նախ՝ կարող ենք դրանից պաշտպանվել՝ սահմանելով min.insync.replicas կոնֆիգուրացիոն պարամետրը։ Գինը հասանելիությունն է, քանի որ Kafka-ն կմերժի նոր հաղորդագրությունները ամեն անգամ, երբ in-sync replica-ները չափազանց քիչ են։
Եթե min.insync.replicas սահմանված չէ, կա 2 ընտրություն՝ կա՛մ սպասել, որ սկզբնական leader-ը վերադառնա առցանց, կա՛մ թույլ տալ out-of-sync replica-ին դառնալ նոր leader, ինչը նշանակում է կորցնել հին leader-ին գրված յուրաքանչյուր հաղորդագրություն, մինչ այդ replica-ն հետ էր մնացել։ unclean.leader.election.enable պարամետրը վերահսկում է այս վարքագիծը։
Producer-ի տեսանկյունից
Producer-ի կոնֆիգուրացիայում producer acks պարամետրը սահմանում է, թե քանի broker (partition replica-ներ հոսթ անող) պետք է հաստատեն հաղորդագրության ստացումը, մինչև այն համարվի հաջողությամբ ուղարկված։ acks=all-ը երաշխավորում է, որ յուրաքանչյուր in-sync replica հաստատել է հաղորդագրությունը, ինչը տալիս է ուժեղ դիմացկունություն՝ արտադրողականության որոշակի գնով։ Մյուս կողմից՝ acks=0-ը producer-ին դնում է fire-and-forget ռեժիմում։ Միջին տարբերակը acks=1-ն է, որտեղ հաղորդագրությունը հաստատում է միայն leader-ը։ Սակայն leader-ը դեռ կարող է խափանվել, մինչև replica-ները պատճենեն հաղորդագրությունը, ուստի տվյալները դեռ կարող են կորչել։
Consumer-ի տեսանկյունից
Consumer-ները կարող են կարդալ միայն leader replica-ից, և միայն այն հաղորդագրությունները, որոնք high-water mark-ից առաջ են՝ բոլոր in-sync replica-ներում commit արված վերջին offset-ը։ Գործնականում սա նշանակում է, որ consumer-ները երբեք չեն տեսնում այն տվյալները, որոնք դեռ ապահով կերպով replicate չեն արվել։
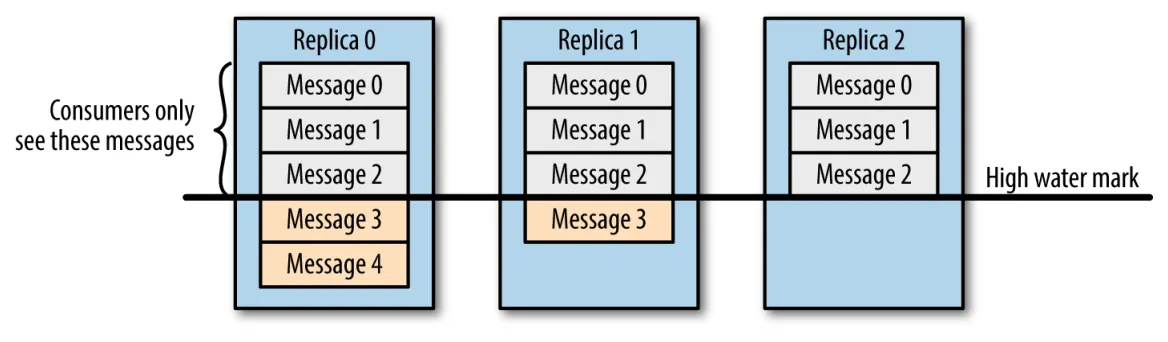
Աղբյուրը՝ Kafka The Definitive Guide
Ինչո՞ւ է Kafka-ն այդքան լավ մասշտաբավորվում
Kafka-ն կառուցվել է մասշտաբավորելիությունը նկատի ունենալով։ CCDAK սերտիֆիկատը հատուկ կշիռ է տալիս դրա հիմնական պատճառին՝ topic partitioning մեխանիզմին, այն է՝ որ մեկ topic-ի partition-ները կարող են գտնվել տարբեր broker-ների վրա և հավասարաչափ բաշխվել դրանց միջև։ Կարող ենք broker ավելացնել կլաստերին կամ հեռացնել (scale out կամ in), օրինակ՝ հզորությունը մեծացնելու համար, և Kafka-ն այնուհետև կարող է partition-ները վերաբաշխել կլաստերի բոլոր broker-ների վրա։ Սա բեռը հավասարակշռված է պահում ամբողջ կլաստերի վրա։
Որքան շատ partition ունի topic-ը, այնքան ավելի շատ consumer կարող են զուգահեռ կարդալ դրանից։ Kafka consumer-ները խմբավորվում են consumer group-երի, որոնք տվյալները սպառում են միմյանցից անկախ։ Consumer group-ի ներսում յուրաքանչյուր partition կարող է կարդացվել միայն 1 consumer-ի կողմից։ Kafka topic-ներից սպառման մասշտաբավորումը հիմնականում կատարվում է consumer group-ին consumer-ներ ավելացնելով կամ հեռացնելով։ Ամեն անգամ, երբ խմբում consumer-ների թիվը փոխվում է, Kafka-ն սկսում է rebalance՝ partition-ների սեփականությունը consumer-ների միջև տեղափոխելով, որպեսզի բեռը մնա հավասար, և մշակումը շարունակվի անընդհատ։
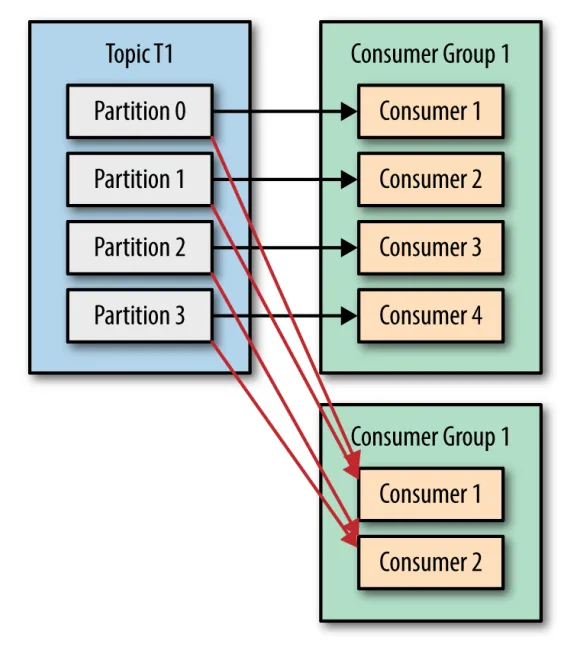
Աղբյուրը՝ Kafka The Definitive Guide
Ի՞նչ է տեղի ունենում Kafka Streams-ի ներսում
Kafka-ն առաքվում է stream-processing գրադարանով՝ հավելվածներ կառուցելու համար, որոնք և՛ իրենց մուտքը կարդում են Kafka կլաստերներից, և՛ իրենց ելքը գրում են դրանց։ Այդպիսի հավելվածը աշխատում է որպես իր սեփական JVM instance՝ broker-ից դուրս։ Այն շփվում է Kafka-ի հետ՝ տվյալները սպառելով և արդյունքները հետ գրելով broker-ին, մինչդեռ հենց մշակումը տեղի է ունենում տեղային՝ client-ի կողմում։ Broker-ը նաև հոգում է rebalancing-ի և մասշտաբավորման մասին, երբ Kafka Stream հավելվածի նոր instance միանում է կամ հեռանում։
CCDAK սերտիֆիկատին պատրաստվելիս սովորեցի, թե ինչպես է Kafka Streams-ը ներսից կառավարում stream processing-ը. այն stream-ը բաժանում է աշխատանքի ավելի փոքր միավորների, որոնք կոչվում են stream task-եր, և որոնց թիվը ածանցվում է մուտքային topic-ի (topic-ների) partition-ների քանակից։ Յուրաքանչյուր task մշակում է տվյալներ մեկ կամ մի քանի Kafka topic partition-ից և կարող է աշխատել իր սեփական thread-ում։ Ակտիվ task-երի առավելագույն թիվը, հետևաբար, համընկնում է մուտքային topic-ի partition-ների թվի հետ, և սա փաստացի սահմանում է Kafka stream հավելվածի առավելագույն զուգահեռականությունը։
Այն, ինչը հատկապես հետաքրքիր եմ համարում, այն է, թե ինչպես է Kafka Streams-ը հաղթահարում խափանումները այնպիսի գործողությունների ժամանակ, ինչպիսին ագրեգացիաներն են։ Նման գործողությունները stateful են, քանի որ պետք է պահեն և թարմացնեն վիճակ՝ ըստ իրենց մշակած հաղորդագրությունների։ Քանի որ task-երը տվյալները մշակում են տեղային, Kafka Streams-ը պահպանում է local state store՝ օգտագործելով ներկառուցված RocksDB։ Յուրաքանչյուր state store-ի կրկնօրինակը պահվում է Kafka Broker-ում կոմպակտացված changelog topic-ում։ Արդյունքում՝ խափանումից հետո Kafka Stream-ը կարող է վերակառուցել իր վիճակը և շարունակել մեկ այլ հանգույցի վրա՝ պարզապես changelog-ը սկզբից կարդալով։ Լրիվ վերականգնումը կարող է որոշ ժամանակ տևել, ուստի Kafka Streams-ը տրամադրում է նաև stand-by task-եր, որոնք իրենց վիճակը համաժամեցված են պահում մյուս task-երի հետ՝ թույլ տալով գրեթե ակնթարթային վերականգնում։
Աղբյուրը՝ developer.confluent.io/courses/kafka-streams
Ամփոփում
Երբ պատրաստվում էի CCDAK-ին, Kafka-ի հետ գործնական փորձս մի փոքր ավելին էր, քան խորհուրդ տրվող 6-12 ամիսը։ Այդուհանդերձ, գտա բազմաթիվ ոլորտներ, որտեղ իմ ըմբռնումն աճեց. որոշ հասկացություններ ավելի պարզ դարձան, որոշները լրիվ նոր էին ինձ համար, և նաև նկատեցի կարևոր մանրամասներ, որոնք նախկինում բաց էի թողել այն թեմաներում, որոնք կարծում էի՝ գիտեմ։
Ընդհանուր առմամբ՝ գոհ եմ կառուցվածքավորված ուսուցման գործընթացից, որը ինձ սերտիֆիկացրեց, և խորհուրդ եմ տալիս CCDAK սերտիֆիկատը որպես Apache Kafka-ի մասին ձեր գործնական գիտելիքը ընդլայնելու կամ հաստատելու լավ միջոց։