دروس عن Kafka من الحصول على شهادة Confluent Certified Developer for Apache Kafka (CCDAK)
ما خرجت به من دراستي لشهادة Confluent Certified Developer في Apache Kafka.
تتعلق شهادة CCDAK ببناء تطبيقات Kafka وهي موجهة للمطورين الذين لديهم بالفعل بعض الخبرة العملية الأساسية مع Apache Kafka. في هذه المقالة، أشارك ما تعلمته أثناء دراستي لشهادة Confluent Certified Developer في Apache Kafka.
المصدر: certificates.confluent.io
متى تكون الشهادة منطقية
CCDAK خيار معقول إذا أردت إثبات معرفتك العامة المتقدمة بـ Kafka، أو التعمق في التفاصيل وفهم كيفية عمله داخليًا وما يتكون منه فهمًا صحيحًا. ومن شروط الامتحان الرسمية المسبقة A minimum of 6-12 months hands-on experience using Confluent products، لذا ينبغي أن تعرف على الأقل أساسيات Kafka.
دروس عملية من الدراسة لامتحان CCDAK
كما أرى، يركز امتحان CCDAK أكثر على فهم البنية التحتية لـ Kafka، وأين يُستخدم، ومعالجة التدفقات كمفهوم. كما يختبر ما إذا كنت تعرف منتجات مختلفة مرتبطة بـ Kafka مثل Kafka Connect أو Kafka Streams، وكذلك منتجات Confluent مثل Confluent Schema Registry، وتستطيع تطبيقها في مواقف واقعية.
وبالنسبة لي، كان أكبر مكسب هو فهم أعمق لكيفية عمل منتجي Kafka (producers) والوسطاء (brokers) والمستهلكين (consumers) داخليًا وكيفية ضبطهم. تمكنت من البناء على مواضيع كنت أعرفها بالفعل، مثل البنية التحتية العامة لـ Kafka أو Connect، لكنني تعلمت أيضًا الكثير عن أمور لم ألمسها إلا قليلًا من قبل – مثل بناء تطبيقات ksqlDB ومعالجة أحداث Kafka باستعلامات شبيهة بـ SQL – أو حتى مفاهيم لم أسمع بها قط، مثل MirrorMaker.
أعجبني أن اجتياز امتحان CCDAK يتطلب بعض الخبرة العملية في ضبط Kafka لأهداف أداء مختلفة – معدل المعالجة وزمن الاستجابة والموثوقية وغيرها.
تعلمت في الغالب من Kafka: The Definitive Guide (متاح للتنزيل مجانًا)، ووثائق Kafka، وConfluent Trainings الذاتية. وقد قدمت جميعها مسار تعلم منظمًا جيدًا قادني عبر مفاهيم Kafka بصورة مرتبة. وقد سهّل تقسيم المادة إلى مواضيع ومكونات محددة المتابعة.
كما أوصي بأداة Kafka Visualization الممتازة لدينا، التي تتيح لك التجريب بنفسك ومحاكاة كيفية انتقال البيانات عبر موضوع Kafka مُكرَّر.
المفاهيم التي وجدتها الأكثر إثارة للاهتمام أثناء دراسة CCDAK
فيما يلي لمحة موجزة عن بضعة مفاهيم وجدتها شخصيًا الأكثر إثارة للاهتمام. وهي تفترض أنك تعرف أساسيات Kafka بالفعل.
لماذا Kafka سريع إلى هذا الحد؟
بُني Kafka لمعدل معالجة عالٍ – وهي من أولى العبارات التي ستسمعها غالبًا عن Apache Kafka. وبعبارة أخرى، يعني معدل المعالجة العالي نقل كميات كبيرة من البيانات بسرعة، قريبًا من الزمن الفعلي. وتُعدّ Uber وLinkedIn مثالين معروفين، إذ تعالجان تريليونات الرسائل يوميًا. فمن أين تأتي هذه السرعة؟
في الغالب من معمارية Kafka الموزعة وآلية التقسيم لديه، التي تقسم المواضيع (topics) إلى أقسام (partitions). وبما أنه يمكن إسناد كل قسم إلى وسيط معين، يمكن توزيع العمل على عقد كثيرة، مما يجعل Kafka قابلًا للتوسع جدًا وهو الفكرة الجوهرية وراء معدل معالجته العالي.
أما ما فهمته بشكل أفضل بكثير أثناء التحضير لشهادة CCKAD فهو مدى كفاءة إدارة Kafka للموارد، وهو لا يقل أهمية لسرعته. وهناك مفهومان بارزان بصفة خاصة – الوصول المتسلسل إلى الإدخال/الإخراج (Sequential I/O access) ومبدأ النسخ الصفري (Zero Copy):
تُقسَّم الرسائل في مواضيع Kafka إلى أقسام وتُكتب مباشرة في التخزين الفيزيائي لوسيط Kafka. ولأن الرسائل في Kafka غير قابلة للتغيير وتشكّل سجلًا للإلحاق فقط (append-only log)، يستطيع Kafka استخدام نمط وصول متسلسل للإدخال/الإخراج، فيقرأ البيانات ويكتبها بطريقة متصلة ومرتبة. وهذا فعال جدًا ويؤدي أداءً أفضل من نمط الوصول العشوائي.
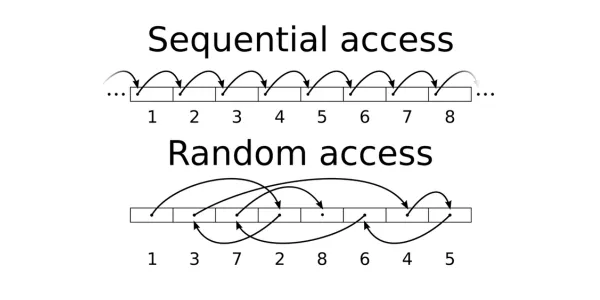
المصدر: wikipedia.org
في الأنظمة التقليدية، تهبط البيانات في ذاكرة مؤقتة محلية قبل إرسالها إلى العملاء. وبما أن المنتج والوسيط والمستهلك يتشاركون صيغة الرسالة نفسها، يستطيع Kafka تطبيق تحسين النسخ الصفري (zero-copy). وهو يجعل نقل البيانات أكثر كفاءة بتخطي تخصيص الذاكرة غير الضروري: تنتقل البيانات مباشرة من نظام الملفات إلى مخزن المقبس (socket buffer)، ومن هناك يمكن إرسالها إلى عملاء المستهلكين.
لماذا يهم النسخ المتماثل (Replication) إلى هذا الحد في معمارية Kafka؟
النسخ المتماثل من ميزات Kafka الأساسية. ينبغي أن تكون لكل قسم في موضوع Kafka نسخ متماثلة – نسخ مطابقة تمامًا – موزعة على وسطاء مختلفين لتوفير المرونة. وتتولى نسخة واحدة، تُسمى القائد (leader)، جميع عمليات الكتابة والقراءة. ولا يتعين على النسخ المتبقية سوى مواكبة القائد ونسخ كل رسالة بجلبها منه – وهذا هو معنى أن تكون متزامنة (in-sync) مع القائد.
ورغم أن انتخاب قائد القسم وآلية النسخ المتماثلة المتزامنة تُعالَج خلف الكواليس على جانب الخادم، فإن فهمهما ضروري لفهم Kafka، لأن كليهما جوهر تحمّله للأعطال. وهذا على الأرجح المجال الذي نمت فيه معرفتي أكثر أثناء التحضير لـ CCDAK، بالنظر إليه من زوايا عدة:
من وجهة نظر الوسيط
إذا فشل الوسيط المستضيف لنسخة القائد، يستطيع Kafka اختيار قائد جديد تلقائيًا من بين جميع النسخ المتزامنة. ومن المثير للاهتمام أن لدى Kafka آلية انتخاب القائد المفضّل (preferred leader election) (والقائد المفضل هو أول نسخة قادت القسم عند إنشاء الموضوع أول مرة). وعندما يعود وسيطنا إلى الاتصال، يستطيع Kafka إعادة قيادة القسم تلقائيًا إلى القائد الأصلي.
ماذا لو لم تتوفر أي نسخة متزامنة عندما يجب انتخاب قائد جديد؟ بدايةً، يمكننا الاحتراز من ذلك بضبط معامل الإعداد min.insync.replicas. والثمن هو التوفر، لأن Kafka سيرفض الرسائل الجديدة كلما كان عدد النسخ المتزامنة قليلًا جدًا.
وإذا لم يُضبط min.insync.replicas، فهناك خياران – إما انتظار عودة القائد الأصلي إلى الاتصال، أو السماح لنسخة غير متزامنة بتولي القيادة كقائد جديد، مما يعني فقدان كل رسالة كُتبت إلى القائد القديم بينما كانت تلك النسخة متأخرة. ويتحكم المعامل unclean.leader.election.enable في هذا السلوك.
من وجهة نظر المنتِج
في إعداد المنتِج، يحدد المعامل producer acks عدد الوسطاء (المستضيفين لنسخ الأقسام) الذين يجب أن يؤكدوا استلام الرسالة قبل اعتبارها مرسلة بنجاح. ويضمن acks=all أن كل نسخة متزامنة أكدت الرسالة، مما يمنح متانة قوية على حساب بعض الأداء. وفي المقابل، يضع acks=0 المنتِج في وضع «أرسل وانسَ» (fire-and-forget). وحل وسط هو acks=1، حيث يؤكد القائد وحده الرسالة. لكن القائد قد يفشل قبل أن تنسخ النسخ الرسالة، لذا يمكن أن تُفقد البيانات.
من وجهة نظر المستهلِك
يستطيع المستهلكون القراءة من نسخة القائد فقط، ورسائل ما قبل علامة المياه العالية (high-water mark) فقط – وهي آخر إزاحة (offset) مثبَّتة عبر جميع النسخ المتزامنة. وعمليًا يعني ذلك أن المستهلكين لا يرون أبدًا بيانات لم يتم نسخها بأمان بعد.
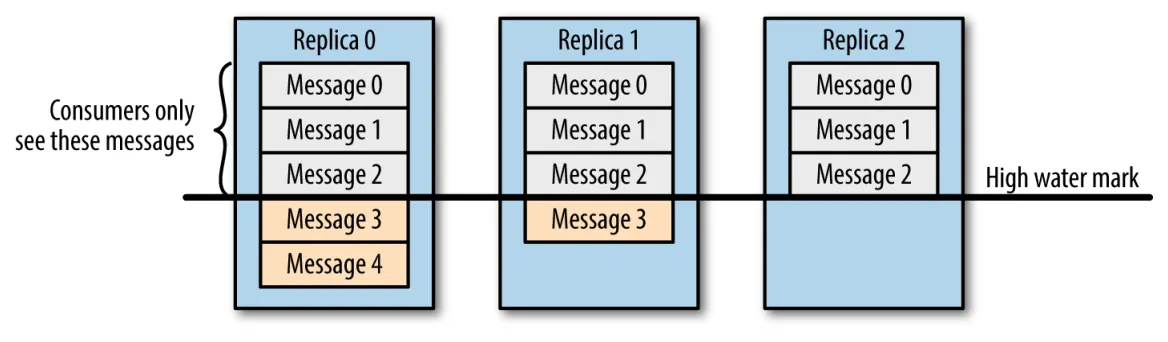
المصدر: Kafka The Definitive Guide
لماذا يتوسع Kafka بهذه الجودة؟
بُني Kafka مع وضع قابلية التوسع في الاعتبار. وتولي شهادة CCDAK أهمية خاصة للسبب الرئيسي لذلك – آلية تقسيم المواضيع – وهي أن أقسام موضوع واحد يمكن أن تعيش على وسطاء مختلفين وتتوزع بينهم بالتساوي. يمكننا إضافة وسيط إلى عنقود أو إزالة واحد (التوسع للخارج أو للداخل)، مثلًا لزيادة السعة، ثم يستطيع Kafka إعادة توزيع الأقسام على جميع الوسطاء في العنقود. وهذا يُبقي الحمل متوازنًا على العنقود بأكمله.
كلما زاد عدد أقسام الموضوع، زاد عدد المستهلكين الذين يستطيعون القراءة منه بالتوازي. يُجمَّع مستهلكو Kafka في مجموعات مستهلكين (consumer groups)، تستهلك البيانات باستقلال بعضها عن بعض. وداخل مجموعة المستهلكين، يمكن لمستهلك واحد فقط قراءة كل قسم. ويتم توسيع الاستهلاك من مواضيع Kafka أساسًا بإضافة مستهلكين إلى مجموعة مستهلكين أو إزالتهم منها. وكلما تغير عدد المستهلكين في مجموعة، يبدأ Kafka إعادة موازنة (rebalance)، فينقل ملكية الأقسام بين المستهلكين بحيث يبقى الحمل متساويًا وتستمر المعالجة دون انقطاع.
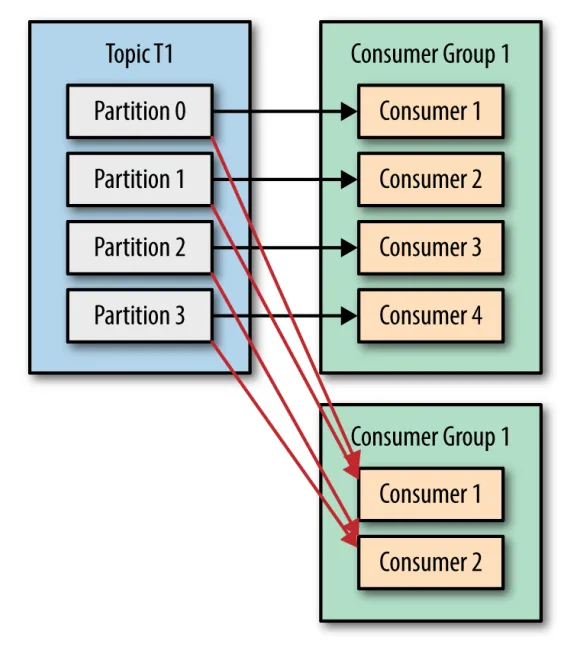
المصدر: Kafka The Definitive Guide
ماذا يحدث داخل Kafka Streams؟
يأتي Kafka بمكتبة لمعالجة التدفقات لبناء تطبيقات تقرأ مدخلاتها من عناقيد Kafka وتكتب مخرجاتها إليها. ويعمل مثل هذا التطبيق كنسخة JVM مستقلة خارج الوسيط. ويتحدث إلى Kafka باستهلاك البيانات وكتابة النتائج إلى الوسيط، بينما تحدث المعالجة نفسها محليًا على جانب العميل. ويتولى الوسيط أيضًا إعادة الموازنة والتوسع عند انضمام نسخة جديدة من تطبيق Kafka Stream أو مغادرتها.
أثناء دراستي لشهادة CCDAK، تعلمت كيف يعالج Kafka Streams التدفق داخليًا: فهو يقسّم التدفق إلى وحدات عمل أصغر تسمى مهام التدفق (stream tasks)، ويُشتق عددها من عدد الأقسام في موضوع (مواضيع) الإدخال. وتعالج كل مهمة بيانات من قسم واحد أو أكثر من أقسام مواضيع Kafka ويمكنها العمل على خيط خاص بها. ولذلك يطابق الحد الأقصى لعدد المهام النشطة عدد الأقسام في موضوع الإدخال – وهذا يحدد فعليًا أقصى قدر من التوازي لتطبيق Kafka stream.
وما أجده مثيرًا للاهتمام خصوصًا هو كيفية تعامل Kafka Streams مع الأعطال أثناء عمليات مثل التجميعات. فهذه العمليات ذات حالة (stateful)، لأنها يجب أن تحتفظ بالحالة وتحدّثها بناءً على الرسائل التي تعالجها. وبما أن المهام تعالج البيانات محليًا، يحتفظ Kafka Streams بمخزن حالة محلي باستخدام RocksDB مضمّن. ويُنسخ كل مخزن حالة احتياطيًا في وسيط Kafka على موضوع سجل تغييرات (changelog topic) مضغوط. ونتيجة لذلك، يستطيع Kafka Stream بعد العطل إعادة بناء حالته والمتابعة على عقدة أخرى ببساطة بقراءة سجل التغييرات من البداية. وقد تستغرق الاستعادة الكاملة بعض الوقت، لذا يوفر Kafka Streams أيضًا مهام احتياطية (stand-by tasks) تُبقي حالتها متزامنة مع المهام الأخرى، مما يتيح استعادة شبه فورية.
المصدر: developer.confluent.io/courses/kafka-streams
ختامًا
عندما حضّرت لـ CCDAK، كانت لدي خبرة عملية مع Kafka أكثر قليلًا من 6-12 شهرًا الموصى بها. ومع ذلك، وجدت مجالات كثيرة نما فيها فهمي – بعض المفاهيم أصبحت أوضح، وبعضها كان جديدًا تمامًا بالنسبة لي، كما التقطت تفاصيل مهمة فاتتني من قبل في مواضيع ظننت أنني أعرفها.
وإجمالًا، أنا سعيد بعملية التعلم المنظمة التي أوصلتني إلى الشهادة، وأوصي بشهادة CCDAK كوسيلة جيدة لتوسيع معرفتك العملية بـ Apache Kafka أو تأكيدها.