Hibernate مقابل Exposed: اختيار أفضل أداة للتخزين الدائم في Kotlin – الجولة 1
مقارنة بين Hibernate وExposed في Kotlin. اكتشف أي إطار عمل SQL للتخزين الدائم يناسب مشروعك القادم أكثر.
مقدمة
التخزين الدائم وحفظ البيانات فكرتان أساسيتان في أنظمة تقنية المعلومات. وعلى مدار مسيرتي المهنية صادفت تطبيقات ذات حالة (stateful) أكثر بكثير من التطبيقات عديمة الحالة تمامًا. ويبدو أن التنوع الهائل في قواعد البيانات، التي بُنيت كل منها لغرض مختلف، يدعم ذلك.
وبالنظر عن كثب، لا تزال قواعد البيانات العلائقية الأكثر شعبية بين جميع قواعد البيانات الموجودة. فأحدث تصنيف db-engines.com يُظهر أن قواعد البيانات العلائقية، من حيث الشعبية، تستحوذ على نحو 72% من السوق.
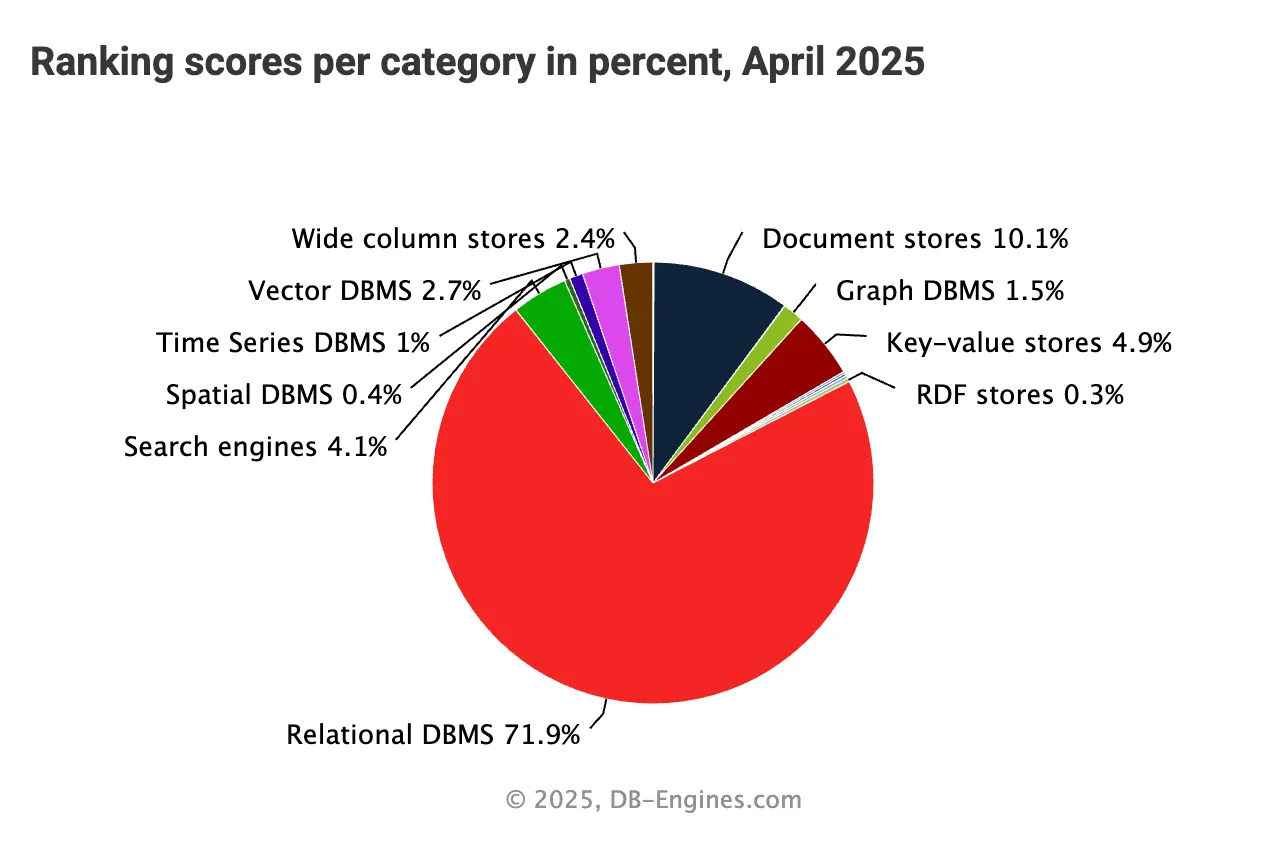
وإزاء ذلك، من الواضح مدى قيمة وجود إطار عمل SQL للتخزين الدائم متين وموثوق وسريع وسهل الاستخدام في صندوق أدواتك.
لكل لغة برمجة أطر عمل SQL خاصة بها اختُبرت في الميدان. وفي هذه المقالة سأقارن إطاري عمل SQL شائعي الاستخدام على JVM – لكنهما مختلفان جوهريًا – وكيف يعملان في مشاريع Kotlin.
اسمحوا لي أن أقدّمهما:
- Hibernate – إطار عمل Java للتخزين الدائم في قواعد البيانات العلائقية،
- Exposed – إطار عمل خفيف وآمن من حيث الأنواع للتخزين الدائم عبر SQL، مبني لـ Kotlin.
ستكون مواجهة مثيرة! لنبدأ الجولة الأولى.
الفلسفة وأهداف التصميم
قبل اختيار إطار عمل للتخزين الدائم لمشروعك القادم، عليك الإجابة عن بضعة أسئلة. وأحد الأسئلة الأقل وضوحًا قد يكون: «ما الفلسفة التي يقوم عليها إطار عمل معين؟»
قد لا يبدو هذا عاملًا بديهيًا في اختيار إطار العمل، ومع ذلك يمكن، على نحو مفاجئ، أن يوفر عليك الكثير من المتاعب مع الوقت. ففلسفة إطار العمل تشمل سبب وجوده، والمشكلات التي يعالجها (وتلك التي لا يعالجها)، وكذلك الطريقة التي يتبعها في حلها. ومع فهمك للمشروع القادم ووعيك بمهاراتك (أو مهارات مطوريك) وعقليتهم تجاه تكاملات SQL، قد تكون هذه المعرفة عونًا حقيقيًا.
Hibernate
Hibernate إطار عمل للتخزين الدائم مبني بالكامل حول ORM (التعيين الكائني العلائقي). وهدفه الأول إخفاء تعقيد SQL خلف أصناف Java (أو Kotlin هنا). فهو يحاول تمكين المطورين من تنفيذ تفاعلات معقدة مع قاعدة البيانات عبر إجراء عمليات بسيطة على كائنات Java أو Kotlin العادية. حتى إن موقع المشروع يعرض شعار «Relational persistence for idiomatic Java». وهكذا يُخفى كل التعقيد تحت الغطاء، داخل شيفرة إطار العمل.
ومع ذلك يتيح Hibernate للمطورين العمل مع قاعدة البيانات الأساسية بطريقة أكثر مباشرة وتحكمًا، عبر لهجة استعلام مخصصة تسمى HQL (تُغطى في المقالة التالية من هذه السلسلة). لكنها تظل طبقة تجريد فوق SQL الخالصة وتُبقي التعقيد الحقيقي بعيدًا عن أنظار المطورين.
وثمة عنصر مهم آخر في تصميم Hibernate هو توافقه مع JPA (Jakarta Persistence، التي كانت تسمى سابقًا Java Persistence API). بل إن Hibernate ساهم يومًا في تشكيل JPA، واليوم هو من أكثر تطبيقات هذا المعيار استخدامًا. ونتيجة لذلك يمكن استخدام Hibernate أينما احتيج إلى JPA، لكن عليه أيضًا الامتثال للمعيار وتقديم الوظائف والواجهة البرمجية التي تعرّفها JPA بموثوقية. وبالتالي قد تقل حرية مطوري Hibernate ومرونتهم في تطوير إطار العمل مقارنة بما لو لم يكن عليهم الالتزام بمعيار محدد من طرف ثالث.
وعند الحديث عن فلسفة Hibernate، يصعب تجاهل دعمه لطيف واسع من قواعد البيانات. فحتى لحظة كتابة هذا، يذكر القائمون على صيانة Hibernate أنه يعمل مع (ويُختبر على) PostgreSQL وMySQL وDb2 وOracle وSQL Server وSybase ASE وEDB وTiDB وMariaDB وHANA وCockroachDB وH2 وHSQLDB.
وقابلية النقل بين قواعد البيانات من أهم نقاط بيع Hibernate (والتعيين الكائني العلائقي عمومًا). فإلى جانب دعم قواعد بيانات كثيرة، يعد Hibernate بتمكين تطبيقك من العمل مع أي عدد منها دون تعديل شيفرتك، ومن الأفضل دون المساس ببيانات التعيين الوصفية أيضًا.
Exposed
يصف مؤلفو Exposed إطارهم بأنه إطار عمل ORM لـ Kotlin، وكذلك بأنه مكتبة SQL خفيفة فوق مشغّل JDBC لـ Kotlin. وكلا الوصفين دقيق في رأيي، لكني أرى شخصيًا أن الثاني يعبّر عن الفلسفة الجوهرية لـ Exposed بشكل أفضل.
الطريقة الأساسية الافتراضية للتخاطب مع قواعد البيانات في Exposed هي DSL الخاصة به، التي تعمل كـ SQL آمنة من حيث الأنواع لـ Kotlin. ويمكنك اختياريًا إضافة وحدة لـ ORM خفيف واستخدامها فوق النموذج نفسه الذي عرّفته لاستعلامات DSL العادية. وهكذا تحصل كمطور على المرونة لاختيار أسلوب التفاعل مع قاعدة البيانات الذي يناسبك أكثر.
ومن الجدير بالتأكيد أنه أيًّا كان الأسلوب الذي تتبعه (DSL أو ORM)، يظل Exposed «مجرد» طبقة رقيقة نسبيًا فوق JDBC، وهو ما يقود إلى خاصية مهمة جدًا: لديك تحكم أكبر في الاستعلامات التي تُنفَّذ فعلًا، وهو أكثر شفافية بشأن ما يحدث حقًا في قاعدة البيانات.
ومن مبادئ التصميم الأساسية الأخرى في Exposed أنه يعمل مع قواعد بيانات علائقية كثيرة مختلفة. وحاليًا يذكر فريق Exposed دعم قواعد البيانات التالية: H2 وMariaDB وMySQL وOracle وPostgreSQL وMicrosoft SQL Server وSQLite.
وأخيرًا، كُتب Exposed بالكامل بـ Kotlin ومن أجلها وتتولى صيانته JetBrains، الشركة التي تقف وراء Kotlin. ويعكس هذا التزامًا عميقًا بأساليب Kotlin ودلالاتها وصياغتها كمبدأ تصميم أساسي.
البدء والإعداد
قبل أن تتمكن من العمل مع إطار عمل، عليك إعداده وضبطه. وعادةً يتم ذلك مرة واحدة، مع أنك في الخدمات المصغّرة قد تضطر إلى المرور بالإعداد عدة مرات.
في هذا القسم سأعرض بعض الأمثلة البسيطة لإعداد Hibernate وExposed في مشروع Kotlin ضمن ثلاث منظومات شائعة:
- JVM العادية
- Spring
- Ktor
تأتي كل أداة عادةً مع خيارات ضبط كثيرة في كل من هذه المنظومات. لذا إلى جانب الأمثلة البسيطة بشيفرة فعلية، سأعطيكم أيضًا فكرة عن الطرق الأكثر تقدمًا أو البديلة لضبط كل أداة.
يكفي من النظرية – لننتقل مباشرة إلى الشيفرة!
مشروع JVM عادي – Hibernate
لإضافة Hibernate إلى مشروع Kotlin الخاص بك، ابدأ بتعريف الاعتماديات الصحيحة في ملف build.gradle.kts. وتحتاج كحد أدنى إلى hibernate-core بالإضافة إلى مشغّل قاعدة بيانات (هنا PostgreSQL):
dependencies {
   implementation("org.hibernate.orm:hibernate-core:6.6.13.Final")
   implementation("org.postgresql:postgresql:42.7.5")
}
ويوفر Hibernate أيضًا عددًا من الوحدات الإضافية المتاحة كاعتماديات اختيارية. ستجد القائمة الكاملة في جزء Hibernate ORM Modules من دليل البدء.
ثم تحتاج إلى توفير تفاصيل الاتصال وخصائص أخرى. وفي تطبيق JVM أصيل، الطريقة المعتادة هي وضعها في ملف hibernate.properties يوضع في classpath (هنا في المجلد src/main/resources):
hibernate.connection.url=jdbc:postgresql://localhost:5432/boardgames
hibernate.connection.username=bgamer
hibernate.connection.password=pass

hibernate.hbm2ddl.auto=create
هذه هي خيارات الاتصال الأساسية (مع وضع توليد DDL). ويمكن العثور على القائمة الكاملة لخيارات الضبط في ملحق دليل مستخدم Hibernate.
وأخيرًا تنشئ SessionFactory في الشيفرة، وهي تتيح لك فتح اتصالات حقيقية بقاعدة البيانات:
fun main() {
   val registry = StandardServiceRegistryBuilder().build()

   val sessionFactory =
       MetadataSources(registry)
           .addAnnotatedClass(MyEntity::class.java)
           .buildMetadata()
           .buildSessionFactory()
ومع وجود SessionFactory يمكنك إنشاء جلسات ومعاملات والعمل مع قاعدة البيانات الأساسية.
مشروع JVM عادي – Exposed
لاستخدام Exposed في مشروع Kotlin عادي، أضف بعض الاعتماديات إلى build.gradle.kts– لـ Exposed نفسه ولمشغّل قاعدة البيانات (PostgreSQL هنا):
dependencies {
   implementation("org.jetbrains.exposed:exposed-core:$exposed_version")
   implementation("org.jetbrains.exposed:exposed-jdbc:$exposed_version")
   implementation("org.postgresql:postgresql:42.7.5")
}
لدى Exposed بعض الوحدات الاختيارية أيضًا. وهي مدرجة كلها في قسم Modules من موقع توثيق Exposed.
الخطوة التالية والأخيرة في إعداد Exposed هي تعريف اتصال قاعدة البيانات. ويتم ذلك مباشرة في شيفرة Kotlin باستدعاء الدالة Database.connect():
Database.connect(
   url = "jdbc:postgresql://localhost:5432/boardgames",
   driver = "org.postgresql.Driver",
   user = "bgamer",
   password = "pass"
)
توجد عدة صيغ للدالة Database.connect()، تتيح لك ضبطها بـ مجموعة من المعاملات الاختيارية. وهناك أيضًا صيغة من هذه الدالة تأخذ javax.sql.DataSource، لتتمكن من ضبطها بالميزات الأكثر تقدمًا في مكتبات تجميع اتصالات قواعد البيانات الشائعة، وهكذا.
وهذا كل شيء – يستطيع Exposed الآن التخاطب مع قاعدة بياناتك.
Spring – Hibernate
إن Hibernate مع Spring (Boot) إعداد شائع جدًا في كثير من تطبيقات المؤسسات. والويب مليء بمواد تشرح كيفية ضبطه. ومع ذلك رأيت أن من المفيد تغطيته هنا لاستكمال الصورة.
وكالعادة نبدأ باعتماديات Gradle:
dependencies {
   implementation(platform("org.springframework.boot:spring-boot-starter-parent:3.4.4"))

   implementation("org.springframework.boot:spring-boot-starter-data-jpa")
   implementation("org.postgresql:postgresql:42.7.5")
}
وبعد توفرها، يمكنك إعداد مصادر بيانات وخصائص Hibernate مختلفة في ملف application.yaml أو application.properties:
spring:
 datasource:
   url: "jdbc:postgresql://localhost:5432/boardgames"
   username: bgamer
   password: pass

 jpa:
   hibernate:
     ddl-auto: create
يدعم مصدر بياناتك خصائص أخرى كثيرة. ولاكتشاف بعضها، راجع ملحق خصائص التطبيق الشائعة في توثيق Spring Boot الرسمي وابحث عن الخصائص التي تبدأ بالبادئة spring.datasource.
ومن هذه النقطة يمكنك حقن SessionFactory في طبقة التخزين الدائم لديك للعمل مع قاعدة البيانات. وكما قد تعرف، توفر Spring واجهات برمجية أعلى مستوى للتفاعل مع قواعد البيانات من SessionFactory الخام، لكن هذه ستُناقش في المقالة التالية من السلسلة.
Spring – Exposed
يعمل Exposed في تطبيقات Spring أيضًا. فقد طورت JetBrains Spring Boot starter مخصصًا لـ Exposed. ولاستخدام Exposed في مشروع Spring Boot الخاص بك، أضف هذا الـ starter مع بعض الاعتماديات الأخرى إلى ملف build.gradle.kts:
dependencies {
   implementation(platform("org.springframework.boot:spring-boot-starter-parent:3.4.4"))

   implementation("org.jetbrains.exposed:exposed-spring-boot-starter:0.61.0")
   implementation("org.postgresql:postgresql:42.7.5")
}
وكما تتوقع، يمكن الآن ضبط اتصال قاعدة البيانات في ملف application.yaml (أو .properties). وكما ذكرنا سابقًا، يمكن ضبط Exposed بـ javax.sql.DataSource قياسي، لذا ستبدو الخصائص مألوفة جدًا، هكذا:
spring:
 datasource:
   url: "jdbc:postgresql://localhost:5432/boardgames"
   username: bgamer
   password: pass

 exposed:
  generate-ddl: true
أنت الآن جاهز لاستخدام DSL الخاصة بـ Exposed أو أصناف DAO في شيفرة تطبيقك!
Ktor – Hibernate
مع Spring، كان بإمكاني أن أفترض بأمان أن إطار العمل معروف وشائع لدرجة لا تحتاج معها إلى تقديم. أما Ktor فقد يكون الأمر مختلفًا. فهذه المقالة ليست عن Ktor، ولا تهدف إلى الخوض في تفاصيل إطار الويب هذا.
وعندما تبحث في الويب عن أمثلة لدمج Ktor مع Hibernate، فأول ما ستلاحظه على الأرجح هو أن… لا توجد أمثلة تقريبًا. باختصار، يبدو أن Ktor وHibernate ثنائي غير مألوف لدرجة يصعب معها العثور على توثيق أو مقالات أو حالات استخدام على الإنترنت. ولعل السبب أن Hibernate مرتبط ارتباطًا وثيقًا بمعيار JPA حتى إنه يبدو أكثر انسجامًا مع Spring منه مع Ktor. وقد يعود ذلك أيضًا إلى (تنبيه حرق!) مدى توافق Ktor وExposed، كما سترى في القسم التالي. وفي كل الأحوال فإن استخدام Hibernate في تطبيقات Ktor ليس ممارسة شائعة. وحتى لحظة كتابة هذا، لا توفر Ktor أي إضافة (plugin) لـ Hibernate.
فماذا أنصح إن كنت تريد Hibernate في مشروع Ktor؟ ببساطة، ارجع إلى القسم السابق من هذه المقالة، «Hibernate في مشروع JVM عادي»، واتبع الخطوات الموصوفة هناك. فمشروع Ktor في النهاية مجرد مشروع JVM آخر، لذا سيعمل إعداد Hibernate العادي هناك أيضًا. أو… يمكنك كتابة إضافة Ktor لـ Hibernate بنفسك!
Ktor – Exposed
في القسم السابق أشرت إلى أن Ktor وHibernate يفتقران إلى الدعم الرسمي والتوافق. وهذا القسم هو العكس تمامًا. إذا كنت تريد Exposed في مشروع Ktor، فأنت محظوظ – فهما يعيشان في تعايش تام. توجد إضافة Exposed رسمية لـ Ktor، متاحة في مولّد مشاريع Ktor. كما يتضمن توثيق Exposed نماذج شيفرة توضح كيفية دمج Exposed مع Ktor. وفوق ذلك ستجد الكثير من المقالات والمدونات والدروس وغيرها حول الموضوع.
وإضافة Exposed إلى Ktor تبدو طبيعية تمامًا. أبسط طريقة للبدء هي مولّد مشاريع Ktor المذكور أعلاه، حيث يمكنك اختيار إضافة Exposed. وهيكل المشروع الذي يولّده سيتضمن اعتماديات Gradle المطلوبة. وللتذكير، ها هي:
dependencies {
   implementation("org.jetbrains.exposed:exposed-core:$exposed_version")
   implementation("org.jetbrains.exposed:exposed-jdbc:$exposed_version")

   implementation("com.h2database:h2:$h2_version")

   ...
}
سيضيف المولّد اعتماديات أخرى، لكن هذه هي الأساسية لـ Exposed.
افتراضيًا يضيف مولّد مشاريع Ktor اعتمادية على مشغّل قاعدة البيانات H2، لكن يمكنك بالطبع استبداله بأي مشغّل JDBC تفضله.
كما يمنحك هيكل المشروع الأولي وحدة Databases في ملف Databases.kt، مع اتصال قاعدة البيانات معرّفًا مسبقًا:
fun Application.configureDatabases() {
   val database = Database.connect(
       url = "jdbc:h2:mem:test;DB_CLOSE_DELAY=-1",
       user = "root",
       driver = "org.h2.Driver",
       password = "",
   )
  ...
}
مرة أخرى، يستهدف ضبط Database قاعدة H2 افتراضيًا، لكن يمكنك تغييره ليناسب أي قاعدة بيانات يستخدمها مشروعك.
وربما تجد أيضًا بعض الشيفرة المولّدة الإضافية، مثل UserService، لكنها مجرد نموذج يوضح كيفية العمل مع قاعدة البيانات عبر واجهة Exposed البرمجية، ويمكنك حذفها أو تكييفها حسب الحاجة.
وكما ترى، تثبّت الشيفرة المولّدة تفاصيل الاتصال داخل الشيفرة، لكنك حر في حقنها عبر الخصائص بدلًا من ذلك.
والخطوة الأخيرة (التي يتولاها مولّد Ktor نيابةً عنك أيضًا) هي ضبط وحدة Database في Application. ويحدث ذلك في ملف Application.kt:
fun Application.module() {
   ...
   configureDatabases()
   ...
}
وقد تُضبط وحدات أخرى هناك أيضًا.
وهذا كل ما تحتاجه لإعداد Exposed مع Ktor في مشروع Kotlin.
التعيين وتعريف المخطط
يحتاج أي إطار عمل للتخزين الدائم إلى بنى بيانات يعمل بها. ولقواعد البيانات العلائقية جداول، لكن أطر عمل التخزين الدائم نادرًا ما تعمل مع الجداول الخام مباشرة. فهي تتطلب عادةً طبقة تجريد فوقها. ولا يشذ Hibernate وExposed عن ذلك. في هذا القسم سأريكم كيف يجرّد كل منهما جداول قاعدة البيانات ويمثّل مخطط بياناتك.
كيانات Hibernate (Entities)
Hibernate إطار عمل للتعيين الكائني العلائقي ويأخذ هذا الدور بجدية. فجداول قاعدة البيانات تمثل الجانب العلائقي، بينما يتأكد Hibernate من أن شيفرتك تتعامل مع كائنات، مخفيًا بنية قاعدة البيانات تحتها. ولهذا يعتمد Hibernate اعتمادًا كبيرًا على الكيانات – كائنات Java عادية (أو Kotlin هنا) تمثل جداول قاعدة البيانات. والكيانات مفهوم محوري في Hibernate.
إليك مثالًا لكيان يمثل جدولًا في قاعدة بيانات متجر ألعاب لوحية خيالي:
@Entity
@Table(name = "board_games")
open class BoardGame(
   @Column(name = "title", nullable = false)
   open var title: String,

   @Column(name = "min_players", nullable = false)
   open var minPlayers: Int,

   @Column(name = "max_players", nullable = false)
   open var maxPlayers: Int,

   @Column(name = "playtime_minutes", nullable = false)
   open var playTimeInMinutes: Int,

   @OneToMany(mappedBy = "boardGame", cascade = [CascadeType.ALL], orphanRemoval = true)
   open val ratings: MutableSet<Rating> = mutableSetOf(),

   @Id
   @GeneratedValue(strategy = GenerationType.IDENTITY)
   @Column(name = "id", nullable = false)
   open var id: Long? = null
) {
   constructor() : this("", 0, 0, 0)
}
أحد الأمور الأساسية في كيانات Hibernate أنها ببساطة كائنات عادية. فلا يلزم أن ترث من أصناف أساسية معينة أو أن تحتوي على أي شيفرة أخرى خاصة بإطار العمل. فالتعليقات التوضيحية (annotations) هي ما يحوّلها إلى كيانات Hibernate. وهذا في صميم فلسفة Hibernate – ألا يعترض طريق شيفرة مجالك وألا يفرض تسلسلات وراثة معينة أو تراكيب خاصة بإطار العمل (باستثناء annotations التي تعمل كبيانات وصفية أكثر منها منطقًا فعليًا).
لاحظ أنه رغم أن Kotlin لغة موجزة جدًا، فإن تعريف كيانات JPA يجبرك على التضحية ببعض سكّرها النحوي. فـ JPA تفرض عدة قيود، منها مثلًا:
- يجب أن يوفر صنف الكيان باني بلا معاملات (no-arg constructor)
- لا يمكن أن يكون صنف الكيان final.
- لا يمكن أن تكون أي من دوال صنف الكيان أو متغيرات النسخة الدائمة فيه final.
ورغم أن كل هذه القيود مصدرها مواصفة JPA، فإن Hibernate لا يفرض بصرامة سوى الأول. فبدون باني بلا معاملات يطلق Hibernate الاستثناء org.hibernate.InstantiationException عند محاولة تحميل الكيان من قاعدة البيانات.
أما القاعدتان الأخريان، فيستطيع Hibernate حفظ وتحميل صنف final بخصائص final، لكنه لا يستطيع اشتقاق صنف فرعي منه أو تجاوز دوال getters/setters فيه. ونتيجة لذلك لا يستطيع Hibernate إنشاء وكلاء (proxies) للتحميل الكسول. فعمليًا لا يزال عليك وسم كل كيان Hibernate وخصائصه بـ open والابتعاد عن أصناف البيانات (data classes) في Kotlin (التي لا يمكن أن تكون open).
وإذا كان القليل من سحر الشيفرة البايتية (bytecode) لا يزعجك، فيمكن لإضافات Gradle وMaven أن تساعد. فـ إضافة no-arg (التي تغلفها إضافة kotlin-jpa) تولّد بناة بلا معاملات لكل صنف مطابق. وإضافة all-open (التي تغلفها إضافة kotlin-spring) تجعل الأصناف المطابقة وأعضاءها open. وتحقق كلتا الإضافتين ذلك بتعديل الشيفرة البايتية لتطبيقك.
لمعرفة المزيد عن كيانات Hibernate، راجع قسم Domain Model في توثيق Hibernate الرسمي.
توليد المخطط في Hibernate
بعد تعريف الكيانات، يستطيع Hibernate إنشاء جداول قاعدة البيانات نيابةً عنك انطلاقًا من annotations على أصناف الكيانات وخصائصها. ولدى Hibernate آلية مدمجة لذلك تعمل في مشروع JVM عادي ومع Spring. ويمكن لتوليد المخطط التلقائي في Hibernate أن يعمل على عدة مستويات:
create– يحذف المخطط ثم ينشئه من جديدcreate_drop– يحذف المخطط عند إغلاقSessionFactoryوينشئه من جديد عند بدءSessionFactorycreate_only– ينشئ المخطط فقط (دون حذف)drop– يحذف المخطط فقطupdate– يعدّل المخطط الموجودvalidate– يتحقق من المخطط مقابل الكيانات فقطnone– وقد يكون ذلك غير متوقع، يترك المخطط دون مساس
ويُضبط توليد المخطط التلقائي إما في ملف hibernate.config عبر الخاصية hibernate.hbm2ddl.auto، أو في ملف application.properties (أو .yaml) لمشروع Spring عبر الخاصية jpa.hibernate.ddl-auto.
ويتضمن دليل مستخدم Hibernate قسمًا مخصصًا لتوليد المخطط إن أردت التعمق في الموضوع.
جداول Exposed (Tables)
بالنسبة إلى طبقة تجريد البيانات، يتناول Exposed الأمور بشكل مختلف قليلًا عن Hibernate. ففي حين يُبنى Hibernate بالكامل على الكيانات، ينمذج Exposed جداول قاعدة البيانات بوصفها… جداول حقيقية.
في Exposed، الجدول هو كائن يرث إما من Table أو من أحد أصناف IdTable. وبالدوال التي توفرها هذه الأصناف الأساسية تعرّف أعمدة جدولك وفهارسه وقيوده.
إليك كيف قد يبدو جدول لمتجر الألعاب اللوحية لدينا في Exposed:
object BoardGamesTable: LongIdTable("board_games") {
   val title = varchar("name", 256)
   val minPlayers = integer("min_players")
   val maxPlayers = integer("max_players")
   val playTimeInMinutes = integer("playtime_minutes")
}
يعرّف الكائن BoardGamesTable كل عمود نحتاجه من جدول قاعدة البيانات board_games database. ولا يوجد عمود id صريح، لأن الصنف الأساسي LongIdTable يعرّفه أصلًا.
ربما لاحظت أنه لا توجد هنا مجموعة ratings. والسبب أن جداول Exposed تعكس جداول قاعدة البيانات الحقيقية عمودًا بعمود. ولأن العلاقة board_games – ratings علاقة واحد إلى متعدد، فإن جدول ratings هو الطرف المالك، ولذلك يقع عمود المرجع هناك.
وهذا تعريف RatingsTable، لترى كيف تُعلن العلاقة:
object RatingsTable: LongIdTable("ratings") {
   val rating = integer("rating")
   val comment = varchar("comment", 256).nullable()
   val ratingDate = timestamp("rating_date")
   val boardGameId = reference("board_game_id", BoardGamesTable)
}
تمثل الخاصية boardGameId العمود board_game_id وتشير إلى الخاصية BoardGamesTable.id.
ويمكن العثور على مزيد عن جداول Exposed في القسم ذي الصلة من توثيق Exposed الرسمي.
Exposed DAO
رغم أن كائنات Table هي الطريقة الافتراضية والأبسط للعمل مع جداول قاعدة البيانات في Exposed، فإن وحدة اختيارية تحوّل Exposed أيضًا إلى ORM خفيف. لنلقِ نظرة الآن على وحدة Exposed DAO.
تتيح وحدة DAO تعريف كيانات تعيّن سجلات جداول قاعدة البيانات إلى كائنات Kotlin. وتضيف الكيانات طبقة تجريد أخرى فوق IdTables في Exposed. بعبارة أخرى، ما زلت بحاجة إلى الجداول (Tables) من القسم السابق، وتعرّف كيانات مطابقة فوقها.
وهكذا يمكن لكيان أن يجرّد BoardGamesTable لدينا أكثر:
class BoardGame(id: EntityID<Long>): LongEntity(id) {
   companion object: LongEntityClass<BoardGame>(BoardGamesTable)

   var title by BoardGamesTable.title
   var minPlayers by BoardGamesTable.minPlayers
   var maxPlayers by BoardGamesTable.maxPlayers
   var playTimeInMinutes by BoardGamesTable.playTimeInMinutes
   val ratings by Rating referrersOn RatingsTable.boardGameId
}
فماذا يجري في هذه الشيفرة؟ لنفككها.
هناك صنف BoardGame يرث من الصنف الأساسي org.jetbrains.exposed.dao.LongEntity.
ويوفر الكائن المرافق (companion object) الخاص به، من النوع LongEntityClass، دوال مفيدة لعمليات CRUD على كيانات هذا النوع (وستغطيها المقالة التالية من السلسلة). كما يربط صنف الكيان بكائن Exposed Table المطابق.
وتمثل خصائص صنف الكيان أعمدة الجدول الأساسي وتُنفَّذ بالكلمة المفتاحية by. بعبارة أخرى، تفوّض خصائص BoardGame إلى خصائص BoardGamesTable.
لكننا هذه المرة لسنا مقيدين بأعمدة الجدول الأساسي. فكما ربما رأيت، يحتوي الكيان BoardGame على خاصية ratings تمثل علاقة واحد إلى متعدد بين الكيانين BoardGame وRating. ضع في اعتبارك أن خاصية كهذه، ملفوفة بالدالة referrersOn، يجب أن تكون غير قابلة للتغيير – لذا عرّفها بـ val لا var. أما الخصائص المتبقية فيمكن أن تكون val أو var، بحسب ما إذا كان ينبغي أن تكون غير قابلة للتغيير أو قابلة له.
ويحتوي توثيق Exposed الرسمي على قسم معمّق كامل عن DAO والكيانات، يستحق الاستكشاف.
توليد المخطط في Exposed
كما ينبغي لأي إطار عمل متين للتخزين الدائم، يتيح لك Exposed ليس فقط نمذجة مخطط قاعدة بيانات موجود في الشيفرة بل أيضًا توليد المخطط من أصنافك.
ولهذا تستخدم الكائن SchemaUtils، الذي يقدم مجموعة من الدوال المفيدة لمعالجة مخطط قاعدة البيانات.
وأكثر الاستخدامات شيوعًا هو إنشاء جداول معينة في قاعدة البيانات الأساسية:
SchemaUtils.create(BoardGamesTable, RatingsTable)وإلى جانب ذلك يوفر دوال لمهام كثيرة أخرى – حذف الجداول وإنشاء الفهارس وإضافة القيود وتوليد المخطط كاملًا والتحقق منه واكتشاف الدورات في علاقات الجداول، وغير ذلك الكثير.
لمزيد من التفاصيل، راجع توثيق Exposed حول العمل مع المخططات. ويمكنك أيضًا تصفح الكائن SchemaUtils نفسه لترى أي دوال يقدمها.
الخلاصة: Hibernate أم Exposed؟
كان ذلك غوصًا عميقًا، على ما أظن. آمل أن تكونوا قد التقطتم الكثير من الأمور المثيرة والعملية في الطريق. لنلخص بسرعة ما غطيناه.
الفلسفة وأهداف التصميم
Hibernate هو ORM ناضج متكامل ذو جذور قوية في JPA ودعم واسع لقواعد البيانات. وتتمحور فلسفته حول إخفاء SQL خلف كائنات Java/Kotlin.
أما Exposed، في المقابل، فأصيل في Kotlin ويهدف إلى أن يكون خفيفًا وشفافًا. وهو يمنحك تحكمًا أكبر في SQL التي تُنفَّذ فعلًا وبصيرة أعمق بها.
الإعداد والتوافق مع المنظومة
يتفوق Hibernate في المنظومات المتمحورة حول JPA مثل Spring، مدعومًا بأدوات متينة واعتماد واسع. لكنه في إعدادات Ktor أو JVM العادية يبدو أخرق بعض الشيء.
أما Exposed، من ناحية أخرى، فيتوافق مع Ktor بشكل طبيعي ويؤدي جيدًا في الحزم البسيطة أو التي تعتمد Kotlin أولًا. وهو يدعم Spring أيضًا، وإن كان هذا الاستخدام أقرب إلى النطاق الضيق على الأرجح.
التعيين وتعريف المخطط
لا ينسجم نموذج JPA في Hibernate بشكل طبيعي مع Kotlin (مثل البناة بلا معاملات والأصناف المفتوحة)، مما قد يتعارض مع شيفرة Kotlin الأصيلة.
أما وحدتا DSL وDAO في Exposed فتستثمران نقاط قوة Kotlin – وإن كانت كيانات DAO قد تنتهي مقترنة بإحكام بمنطق التخزين الدائم.
فمن الفائز إذن؟ من المبكر جدًا القول!