Պատկերների գեներատիվ մոդելների գնահատման մետրիկաներ
Այս հոդվածը ներկայացնում է պատկերների գեներատիվ մոդելների գնահատման երկու հիմնական մետրիկաները՝ Inception Score և Fréchet inception distance։
Պատկերների գեներատիվ մոդելների ուսուցումը կարող է դժվար լինել, բայց դրանք ճիշտ գնահատելը կարող է էլ ավելի դժվար լինել։ Ամենապարզ մետրիկը մարդ փորձագետների դատողությունն է։ Սակայն այն թանկ է, դանդաղ և ենթակա կողմնակալության։ Մարդ փորձագետների վրա ազդում են խնդրի դրվածքը, նրանց մոտիվացիան և իրենց սխալների վերաբերյալ ստացած հետադարձ կապը։ Գոյություն չուներ օբյեկտիվ ֆունկցիա, որով կարելի լիներ գնահատել գեներացված պատկերները։ Այդ պատճառով ստեղծվել են այլընտրանքային մեթոդներ՝ գեներացված պատկերների որակը, բազմազանությունը և հավատարմությունը չափելու համար։ Դրանցից ամենալայն օգտագործվողներն են Inception Score-ը (IS) և Fréchet inception distance-ը (FID)։
Inception Score
Inception Score-ը առաջին անգամ ներկայացվել է Improved Techniques for Training GANs 2016 հոդվածում։ Այն նախատեսված է երկու բան չափելու համար՝
- Պատկերի հավատարմություն։ Յուրաքանչյուր պատկեր պետք է ցույց տա հստակ ճանաչելի օբյեկտ։
- Բազմազանություն։ Մոդելը պետք է կարողանա գեներացնել շատ տարբեր օբյեկտների դասեր, իդեալականորեն՝ հավասարաչափ բաշխմամբ։ Յուրաքանչյուր դաս պետք է ունենա նույն հավանականությունը։
IS-ը հաշվարկվում է հետևյալ ֆունկցիայով՝
p(y|x)-ը պայմանական պիտակային բաշխում է։ Հոդվածի հեղինակները օգտագործում են Inception ցանցը՝ յուրաքանչյուր գեներացված պատկերի համար պիտակ կանխատեսելու համար։ Երբ պատկերը ցույց է տալիս հստակ օբյեկտ, inception մոդելը պետք է դասերից մեկին վերագրի բարձր հավանականություն, և էնտրոպիան ցածր կլինի H(y|x)~0։
Հավասարման երկրորդ մասը՝ p(y)-ը, այն հավանականությունն է, որով inception մոդելը կանխատեսում է յուրաքանչյուր դասը։ Իդեալականորեն բոլոր դասերը պետք է հավասարահավանական լինեն, ուստի էնտրոպիան պետք է բարձր լինի H(y)~+∞։
KL-ը նշանակում է Kullback–Leibler divergence։ Այն չափում է, թե որքան նման են երկու բաշխումները։ Մեծ արժեքը նշանակում է, որ դրանք բոլորովին նման չեն։ Սա բավարարում է թե՛ հավատարմության, թե՛ բազմազանության պահանջը։
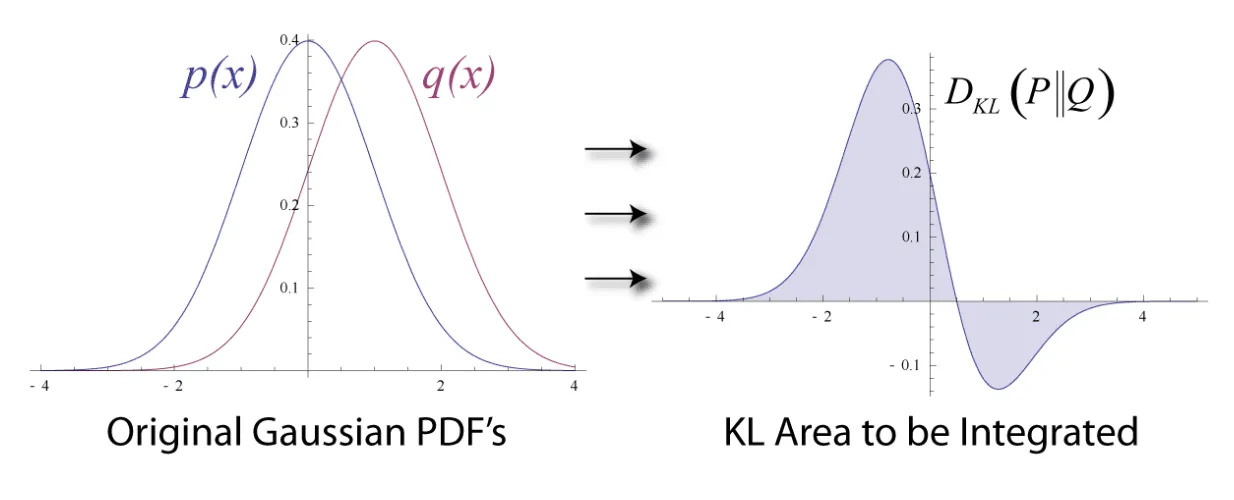
Նկար 1. KL divergence-ը չափում է, թե որքան նման են բաշխումները։ DKL(P||Q) = ∑xP(x)ln(P(x)/Q(x))։ DKL-ը սիմետրիկ չէ DKL(P||Q) != DKL(Q||P)։ Աղբյուր
Էքսպոնենցիալ ֆունկցիան ավելացվել է զուտ գեղագիտական նկատառումներով։ Ավելի բարձր IS-ը ավելի լավ է։
Inception Score-ի թույլ կողմերը
Սակայն Inception Score-ը ունի որոշակի թույլ կողմեր։ Դրանք նկարագրված են A Note on the Inception Score 2018 հոդվածում։ Ամենակարևորներն են՝
- Թույլ ընդհանրացման կարողություն – IS-ը չի չափում, թե որքան բազմազան են պատկերները մեկ դասի ներսում։ GenAI մոդելը կարող է դասի ներսում գեներացնել նույնական պատկերներ և միևնույն է բարձր գնահատական ստանալ։ Արդյունքում մոդելը չի տուգանվում ուսուցման տվյալների միայն փոքր մասը անգիր անելու համար։
- Զգայունություն մոդելի կշիռների նկատմամբ։ Նույնիսկ կշիռների արժեքների չնչին տարբերությունները կարող են առաջացնել գնահատման արդյունքների մեծ տատանումներ։
Կախված նրանից՝ օգտագործվում է Inception ցանցի Keras թե Torch իրականացում, միջին Inception Score-ը ստացվում է 3,5%-ով ավելի բարձր ImageNet վալիդացիոն պատկերների համար և 11,5%-ով ավելի բարձր՝ CIFAR վալիդացիոն պատկերների համար։
- GenAI մոդելը անմիջապես Inception Score-ի դեմ օպտիմալացնելը սովորեցնում է այն ստեղծել adversarial նմուշներ, այլ ոչ թե ավելի բարձր որակի պատկերներ։
Նկար 2. IS նպատակով ուսուցանված դիֆուզիոն մոդելի ստեղծած adversarial նմուշներ։ Նմուշները հասան 900,15 Inception Score-ի, մինչդեռ առավելագույն IS գնահատականը 1000 է։ Աղբյուր
- IS-ը լավագույնս աշխատում է այն GenAI մոդելների համար, որոնք ուսուցանվել են նույն տվյալների հավաքածուի վրա, ինչ Inception դասակարգման մոդելը (բնօրինակ Inception մոդելը ուսուցանվել է ImageNet-ի վրա)։ IS-ը օգտագործելը, ասենք, CIFAR-10-ի վրա ուսուցանված GenAI մոդելների համար կարող է խաբուսիկ արդյունքներ տալ։ Պատճառն այն է, որ Inception մոդելի կանխատեսած լավագույն 10 դասերը չեն համընկնում CIFAR-10-ի դասերի հետ։ Inception մոդելի դասերի և մեկ այլ տվյալների հավաքածուի դասերի այս անհամապատասխանությունը կարող է հանգեցնել p(y)-ի՝ գեներացված պատկերների X բազմության վրա մարգինալ դասային բաշխման, և p(y|x)-ի սխալ գնահատման։
Fréchet inception distance
Նկար 3. FID գնահատականի հաշվարկի վիզուալիզացիա։ FID-ը երկու նորմալ բաշխումների միջև հեռավորությունն է, որոնց միջինը և սիգման հաշվարկվում են inception մոդելի ստեղծած պատկերների հատկանիշների առաջին և երկրորդ մոմենտներից։
Inception Score-ի թույլ կողմերի պատճառով GenAI մոդելները գնահատելու համար առաջարկվեց Fréchet inception distance-ը։ Այն ավելի լավ է արտացոլում, թե որքան նման են գեներացված պատկերները իրականներին, քան Inception Score-ը։ Ինչպես IS-ը, FID-ը հենվում է նախապես ուսուցանված Inception-v3 մոդելի վրա։ Սակայն ելքային հավանականությունների փոխարեն FID-ը կոդավորման շերտ է օգտագործում վերջին pooling շերտը (այն, որ անմիջապես ելքային դասակարգման շերտից առաջ է)։ 50 հազար պատկեր անցկացվում է inception մոդելով, և մոմենտները հաշվարկվում են կոդավորման շերտի վեկտորների վրա։ Ավելի ճշգրիտ՝ հաշվարկվում են այս շերտի առաջին (միջին) և երկրորդ (կովարիացիոն մատրից) մոմենտները։ Այս վիճակագրությունները ստացվում են իրական պատկերների բազմության և կեղծ պատկերների բազմության համար։ Վերջում երկու բաշխումների միջև հեռավորությունը հաշվարկվում է Frechet distance-ով։
Այստեղ mu_r-ը և mu_f-ը նշանակում են համապատասխանաբար իրական և կեղծ հատկանիշների միջինը, C_r-ը և Cf-ը նշանակում են համապատասխանաբար իրական և կեղծ հատկանիշների կովարիացիոն մատրիցը, Tr-ը trace գծային հանրահաշվական գործողությունն է, իսկ || ||^2-ը քառակուսի տարբերությունների գումարն է։ Որքան փոքր է հեռավորությունը (FID գնահատականը), այնքան լավ է պատկերի որակը։
Նկար 4. Ավելի ցածր FID գնահատականը նշանակում է ավելի լավ պատկերի որակ և հավատարմություն։ Աղբյուր
Generating images with sparse representations հոդվածը ներկայացրեց FID-ի բարելավված տարբերակ՝ sFID անունով։ Վերջին pooling շերտի փոխարեն այն հենվում է inception ցանցի միջանկյալ տարածական հատկանիշների վրա։ sFID-ն ավելի մոտ է համընկնում լավ որակի պատկերների մարդկային գնահատականին։ Այն ուժեղ կորելացվում է իրատեսական տեքստուրաների և կառուցվածքների հետ և հասնում է բազմազանության, ինչպես մարդկային ընկալումը։
Թեև sFID-ը ամենալավ ավտոմատ մետրիկն է GenAI պատկերների մոդելները գնահատելու համար, IS-ը դեռ սովորաբար օգտագործվում է դրա կողքին։ Պատճառն այն է, որ IS-ն ավելի լավ է արտացոլում, թե որքան հավատարիմ է պատկերը պահանջվող պայմանին։
FID գնահատականի թույլ կողմերը
Վերջերս հրապարակվել է FID-ի թույլ կողմերի մասին հոդված՝ [Rethinking FID: Towards a Better Evaluation Metric for Image Generation](https://arxiv.org/abs/2401.09603#:~:text=We highlight important drawbacks of,assumptions, and poor sample complexity.)։ Դրա հեղինակները պարզում են, որ FID-ը դժվարանում է արտացոլել պատկերի որակի աստիճանական բարելավումները և չի կարողանում ֆիքսել պատկերի աղավաղումները։ Նրանք մատնանշում են հետևյալ խնդիրները, որոնք պետք է լուծվեն FID գնահատականը բարելավելու համար՝
- Inception մոդելը տալիս է թույլ պատկերային embedding-ներ։ CLIP embedding-ները ուսուցանվել են x400 անգամ ավելի շատ ուսուցման նմուշների վրա, և դասակարգման խնդիրների փոխարեն CLIP-ը ուսուցանվում է պատկերները իրենց նկարագրություններին ճշգրիտ համապատասխանեցնելու համար։ Հետևաբար CLIP-ը տալիս է ավելի հարուստ embedding-ներ, քան Inception մոդելը։
- FID-ը ենթադրում է հատուկ հատկանիշների նորմալ բաշխում, ինչը միշտ չէ, որ ճիշտ է։
- FID գնահատականը կողմնակալ է։ Նմուշների վերջավոր բազմության վրա հաշվարկված FID գնահատականը գնահատականի իրական արժեքը չէ, և այն կախված է այն բանից, թե քանի նմուշ է օգտագործվել դրա հաշվարկի համար։ Մանրամասները նկարագրված են Effectively Unbiased FID and Inception Score and where to find them հոդվածում։
- FID-ը նմուշների առումով անարդյունավետ է։ Բարձր չափողականության հատկանիշային վեկտորների համար d × d կովարիացիոն մատրիցը հուսալիորեն գնահատելը պահանջում է մեծ նմուշ։
Այս թույլ կողմերը լուծելու համար հոդվածի հեղինակները առաջարկում են CLIP-Maximum Mean Discrepancy (CMMD)։
CLIP-Maximum Mean Discrepancy
CMMD-ը FID գնահատականի բարելավված տարբերակն է։ Այն Inception embedding-ները փոխարինում է շատ ավելի հարուստ CLIP embedding-ներով, իսկ Fréchet distance-ը՝ Maximum Mean Discrepancy-ով։ MMD-ը ստեղծվել է ստուգելու համար, թե նմուշները նույն բաշխումից են արդյոք։ FID գնահատականից տարբերվելով՝ MMD-ը՝ բնորոշ կորիզի (characteristic kernel) հետ օգտագործվելիս, ոչ մի ենթադրություն չի անում տվյալների բաշխման մասին։ Ավելին, այն անկողմնակալ գնահատիչ է և նմուշների առումով արդյունավետ է բարձր չափողականության տվյալների հետ գործ ունենալիս։
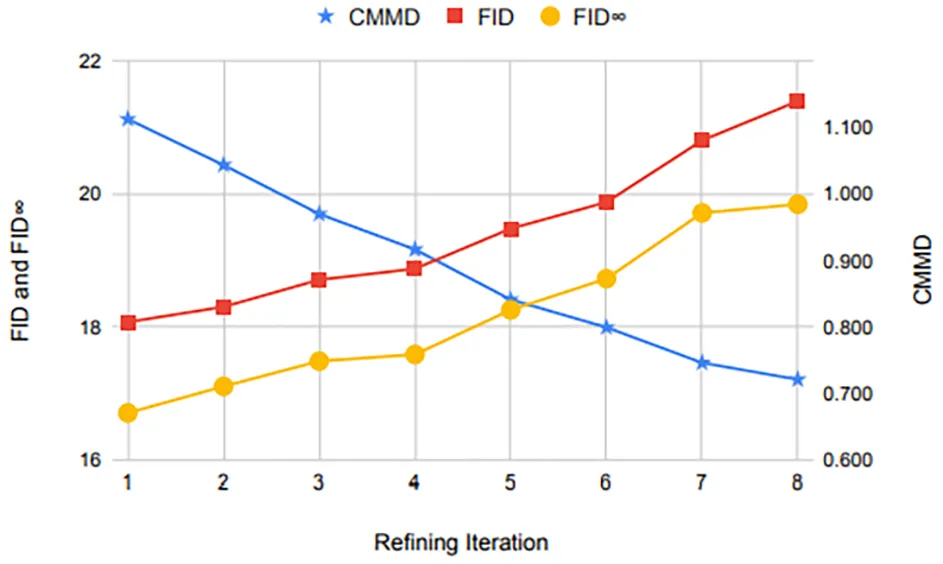
Նկար 5. CMMD-ի հեղինակները ցույց են տալիս, որ FID գնահատականը կարող է չարտացոլել պատկերի որակի աստիճանական բարելավումը։ Պանթեոնի պատկերի որակը քայլ առ քայլ բարելավվում է ձախից աջ։ Սակայն, ինչպես ցույց է տալիս ներքևի գրաֆիկը, FID գնահատականը աճում է մոնոտոն կերպով։ Նոր առաջարկված CMMD մետրիկը, ընդհակառակը, ճիշտ է արտացոլում պատկերի աստիճանական բարելավումը։ Աղբյուր
Ամփոփում
Այս հոդվածը ներկայացրեց պատկերների գեներատիվ մոդելների գնահատման երկու հիմնական մետրիկաները՝ Inception Score և Fréchet inception distance։ Inception Score-ը չի արտացոլում պատկերների բազմազանությունը մեկ դասի ներսում, և այն պետք է օգտագործել գեներատիվ մոդելի նույն տվյալների հավաքածուի վրա ուսուցանված inception մոդելով։ FID-ն իր հերթին շտկում է IS-ի բազմազանության խնդիրը, բայց պակաս հարմար է պայմանին հավատարմությունը գնահատելու համար և սխալմամբ ենթադրում է, որ պատկերի հատկանիշները հետևում են նորմալ բաշխմանը։ Նոր առաջարկված CMMD գնահատականը լուծում է FID-ի թույլ կողմերը՝ օգտագործելով Maximum Mean Discrepancy, որը ոչ մի ենթադրություն չի անում տվյալների բաշխման մասին։ Այն ավելի է բարելավում FID-ը՝ օգտագործելով շատ ավելի հարուստ CLIP embedding-ներ՝ Inception embedding-ների փոխարեն։