مقاييس تقييم نماذج الصور التوليدية
يقدّم هذا المقال المقياسين الرئيسيين المستخدمين لتقييم نماذج الصور التوليدية: Inception Score وFréchet inception distance.
قد يكون تدريب نماذج الصور التوليدية صعبًا، لكن تقييمها بشكل صحيح قد يكون أصعب. وأبسط مقياس هو حكم الخبراء البشر. غير أنه مكلف وبطيء وعرضة للتحيّز. فالخبراء البشر يتأثرون بطريقة صياغة المهمة وبدافعيتهم وبالملاحظات التي يتلقونها عن أخطائهم. ولم توجد دالة موضوعية يمكن استخدامها لتقييم الصور المولَّدة. ولهذا السبب أُنشئت طرق بديلة لقياس جودة الصور المولَّدة وتنوعها ودقتها. وأكثرها استخدامًا Inception Score (IS) وFréchet inception distance (FID).
Inception Score
قُدّم Inception Score أول مرة في الورقة Improved Techniques for Training GANs 2016. وهو مصمَّم لقياس أمرين:
- دقة الصورة. يجب أن تُظهر كل صورة جسمًا يمكن التعرف عليه بوضوح.
- التنوع. ينبغي أن يكون النموذج قادرًا على توليد فئات أجسام كثيرة مختلفة، ويفضل بتوزيع منتظم. يجب أن يكون لكل فئة الاحتمال نفسه.
يُحسب IS بالدالة التالية:
p(y|x) هو توزيع تسميات شرطي. يستخدم مؤلفو الورقة شبكة Inception للتنبؤ بتسمية لكل صورة مولَّدة. وعندما تُظهر الصورة جسمًا واضحًا، ينبغي لنموذج inception أن يسند احتمالًا مرتفعًا إلى إحدى الفئات، وستكون الإنتروبيا منخفضة H(y|x)~0.
أما الجزء الثاني من المعادلة، p(y)، فهو الاحتمال الذي يتنبأ به نموذج inception لكل فئة. ومن المثالي أن تكون كل الفئات متساوية الاحتمال، فيجب أن تكون الإنتروبيا مرتفعة H(y)~+∞.
ترمز KL إلى تباعد كولباك–ليبلر. وهو يقيس مدى تشابه التوزيعين. والقيمة الكبيرة تعني أنهما غير متشابهين على الإطلاق. وهذا يلبّي شرطَي الدقة والتنوع.
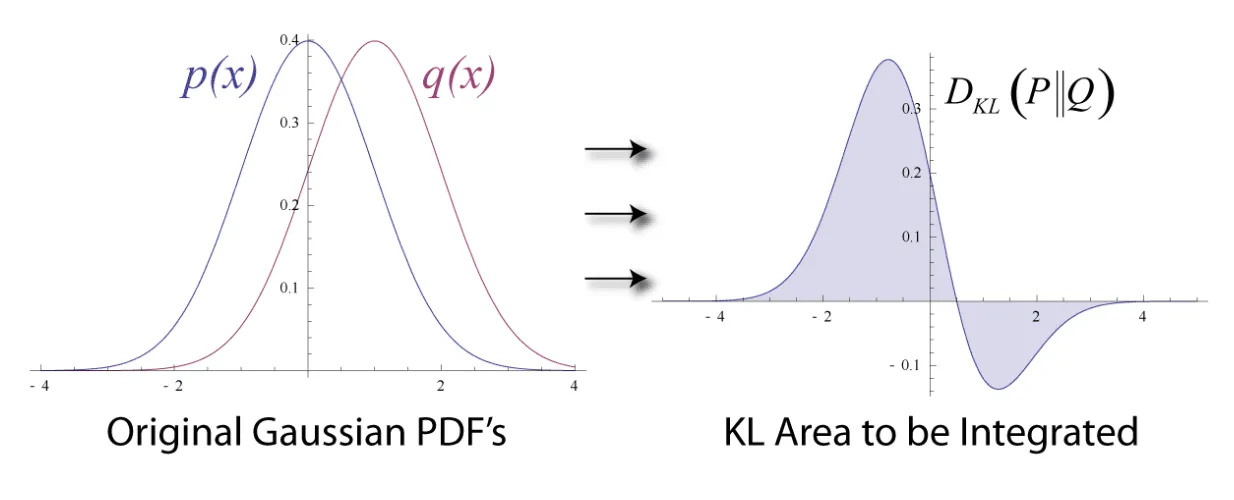
الشكل 1. يقيس تباعد KL مدى تشابه التوزيعات. DKL(P||Q) = ∑xP(x)ln(P(x)/Q(x)). DKL غير متماثل DKL(P||Q) != DKL(Q||P). المصدر
أُضيفت الدالة الأسية لأسباب جمالية بحتة. وكلما ارتفع IS كان أفضل.
نقاط ضعف Inception Score
لكن لـ Inception Score بعض نقاط الضعف. وقد وُصفت في الورقة A Note on the Inception Score 2018. وأهمها:
- ضعف القدرة على التعميم – لا يقيس IS مدى تنوع الصور داخل الفئة الواحدة. فقد يولّد نموذج GenAI صورًا متطابقة داخل الفئة ومع ذلك يحصل على درجة مرتفعة. ونتيجة لذلك لا يُعاقَب النموذج على حفظ جزء صغير فقط من بيانات التدريب.
- الحساسية لأوزان النموذج. حتى الفروق الضئيلة في قيم الأوزان قد تسبب تباينات كبيرة في نتائج التقييم.
بحسب استخدام تنفيذ Keras أو Torch لشبكة Inception، يخرج متوسط Inception Score أعلى بنسبة 3.5% لصور التحقق من ImageNet وأعلى بنسبة 11.5% لصور التحقق من CIFAR.
- إن تحسين نموذج GenAI مباشرة وفق Inception Score يعلّمه إنتاج عيّنات خصامية (adversarial) بدل صور أعلى جودة.
الشكل 2. عيّنات خصامية أنتجها نموذج انتشار دُرّب بهدف IS. بلغت العيّنات Inception Score قدره 900.15، بينما الحد الأقصى لدرجة IS هو 1000. المصدر
- يعمل IS بأفضل صورة مع نماذج GenAI المدرَّبة على مجموعة البيانات نفسها التي دُرّب عليها نموذج التصنيف Inception (دُرّب نموذج Inception الأصلي على ImageNet). وقد يعطي استخدام IS لنماذج GenAI المدرَّبة، مثلًا، على CIFAR-10 نتائج مضللة. والسبب أن أعلى 10 فئات يتنبأ بها نموذج Inception لا تطابق فئات CIFAR-10. وقد يؤدي عدم التطابق هذا بين فئات نموذج Inception وفئات مجموعة بيانات أخرى إلى تقدير خاطئ لـ p(y)، أي التوزيع الهامشي للفئات على مجموعة الصور المولَّدة X، ولـ p(y|x).
Fréchet inception distance
الشكل 3. تصوّر لكيفية حساب درجة FID. إن FID هي المسافة بين توزيعين طبيعيين يُحسب متوسطهما وسيغماهما من العزم الأول والثاني لخصائص الصورة التي ينتجها نموذج inception.
بسبب نقاط ضعف Inception Score، اقتُرحت Fréchet inception distance لتقييم نماذج GenAI. وهي تعكس مدى تشابه الصور المولَّدة مع الحقيقية بشكل أفضل من Inception Score. وكما في IS، يعتمد FID على نموذج Inception-v3 مدرَّب مسبقًا. لكن بدلًا من احتمالات المخرجات، يستخدم FID طبقة التجميع الأخيرة (الطبقة التي تسبق مباشرة طبقة التصنيف الخرجية) كطبقة ترميز. تُمرَّر 50k صورة عبر نموذج inception، وتُحسب العزوم على المتجهات القادمة من طبقة الترميز. وبدقة أكبر، يُحسب العزم الأول (المتوسط) والثاني (مصفوفة التغاير) لهذه الطبقة. وتُستخرج هذه الإحصاءات لمجموعة من الصور الحقيقية ومجموعة من الصور المزيفة. وأخيرًا تُحسب المسافة بين التوزيعين بمسافة Frechet.
هنا يشير mu_r وmu_f إلى متوسط الخصائص الحقيقية والمزيفة على التوالي، ويشير C_r وCf إلى مصفوفة التغاير للخصائص الحقيقية والمزيفة على التوالي، وTr هي عملية الأثر في الجبر الخطي، و|| ||^2 هو مجموع الفروق المربعة. وكلما صغرت المسافة (درجة FID)، كانت جودة الصورة أفضل.
الشكل 4. تعني درجة FID الأقل جودة ودقة صورة أفضل. المصدر
قدّمت الورقة Generating images with sparse representations صيغة محسّنة من FID تسمى sFID. وبدلًا من طبقة التجميع الأخيرة، تعتمد على الخصائص المكانية الوسيطة لشبكة inception. وتتطابق sFID بدرجة أكبر مع حكم البشر على الصور الجيدة الجودة. فهي ترتبط ارتباطًا قويًا بالأنسجة والبنى الواقعية، وتحقق التنوع، تمامًا كالإدراك البشري.
ومع أن sFID هي بفارق كبير أفضل مقياس آلي لتقييم نماذج صور GenAI، فلا يزال IS يُستخدم معها بشكل شائع. والسبب أن IS يعكس بشكل أفضل مدى وفاء الصورة للشرط المطلوب.
نقاط ضعف درجة FID
نُشرت مؤخرًا ورقة عن نقاط ضعف FID: [Rethinking FID: Towards a Better Evaluation Metric for Image Generation](https://arxiv.org/abs/2401.09603#:~:text=We highlight important drawbacks of,assumptions, and poor sample complexity.). ويرى مؤلفوها أن FID يجد صعوبة في عكس التحسنات التدريجية في جودة الصورة ويفشل في التقاط تشوهات الصورة. ويشيرون إلى المشكلات التالية، التي يجب حلّها لتحسين درجة FID:
- ينتج نموذج inception تضمينات (embeddings) ضعيفة للصور. دُرّبت تضمينات CLIP على عدد من عيّنات التدريب أكبر بـ x400، وبدلًا من مهام التصنيف، يُدرَّب CLIP على مطابقة الصور مع أوصافها بدقة. ونتيجة لذلك ينتج CLIP تضمينات أغنى من نموذج Inception.
- يفترض FID توزيعًا طبيعيًا للخصائص الخاصة، وقد لا يصح ذلك دائمًا.
- درجة FID متحيّزة. فدرجة FID المحسوبة على مجموعة محدودة من العيّنات ليست القيمة الحقيقية للدرجة، وتعتمد على عدد العيّنات المستخدمة في حسابها. وتُوصف التفاصيل في الورقة Effectively Unbiased FID and Inception Score and where to find them.
- FID غير كفء في استخدام العيّنات. يتطلب التقدير الموثوق لمصفوفة التغاير d × d لمتجهات الخصائص عالية الأبعاد عيّنة كبيرة.
ولمعالجة نقاط الضعف هذه، يقترح مؤلفو الورقة CLIP-Maximum Mean Discrepancy (CMMD).
CLIP-Maximum Mean Discrepancy
CMMD نسخة محسّنة من درجة FID. فهي تستبدل تضمينات Inception بتضمينات CLIP الأغنى بكثير، وتستبدل مسافة Fréchet بالتباين الأقصى للمتوسط (Maximum Mean Discrepancy). وقد أُنشئ MMD للتحقق مما إذا كانت العيّنات تأتي من التوزيع نفسه. وعلى خلاف درجة FID، لا يضع MMD المستخدم مع نواة مميِّزة (characteristic kernel) أي افتراضات حول كيفية توزيع البيانات. وفوق ذلك، فهو مقدِّر غير متحيّز وكفء في استخدام العيّنات عند التعامل مع بيانات عالية الأبعاد.
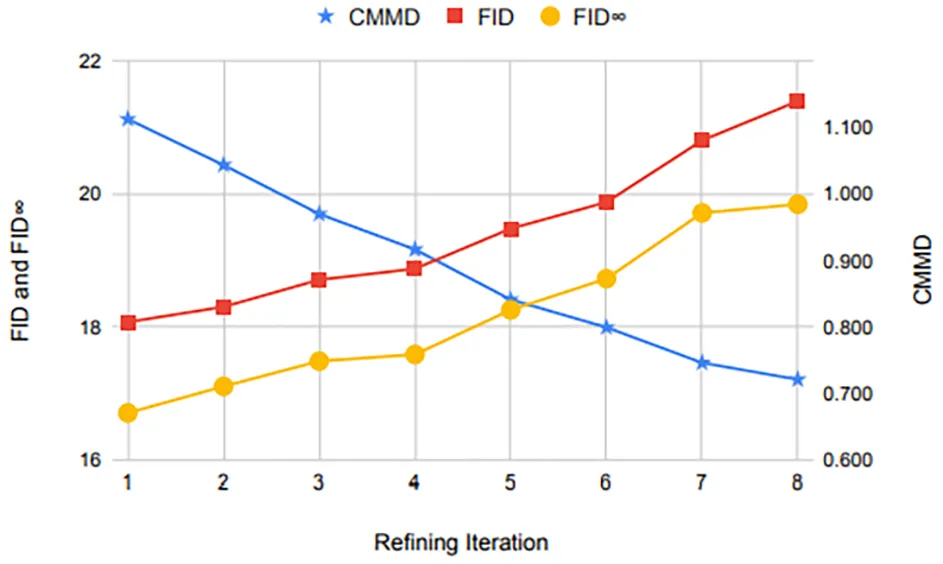
الشكل 5. يبيّن مؤلفو CMMD أن درجة FID قد تفشل في عكس التحسن التدريجي في جودة الصورة. تتحسن جودة صورة البانثيون خطوة بخطوة من اليسار إلى اليمين. ومع ذلك، وكما يبيّن الرسم السفلي، ترتفع درجة FID بشكل رتيب. أما مقياس CMMD المقترح حديثًا، فعلى النقيض، يعكس بشكل صحيح التحسن التدريجي للصورة. المصدر
الخلاصة
تناول هذا المقال المقياسين الرئيسيين لتقييم نماذج الصور التوليدية: Inception Score وFréchet inception distance. لا يعكس Inception Score تنوع الصور داخل الفئة الواحدة، وينبغي استخدامه مع نموذج inception مدرَّب على مجموعة البيانات نفسها التي دُرّب عليها النموذج التوليدي. أما FID فيعالج بدوره مشكلة التنوع في IS، لكنه أقل ملاءمة لتقييم الوفاء بالشرط، ويفترض خطأً أن خصائص الصور تتبع توزيعًا طبيعيًا. وتعالج درجة CMMD المقترحة حديثًا نقاط ضعف FID باستخدام التباين الأقصى للمتوسط، الذي لا يضع أي افتراضات حول توزيع البيانات. وهي تحسّن FID أكثر باستخدام تضمينات CLIP الأغنى بكثير بدل تضمينات Inception.