Ի՞նչ է իրականում տալիս LLM-ի finetuning-ը
Բժշկական Q&A չատբոտերը լավացնելու մոտեցումների համեմատություն։
Վաղ թե ուշ բնական լեզվի մշակմամբ, մասնավորապես՝ չատբոտերի և Large Language մոդելների հետ աշխատող յուրաքանչյուր մարդ հանդիպում է prompt engineering և մոդելի fine tuning տերմիններին՝ որպես իր համակարգը հարմարեցնելու կամ լավացնելու եղանակների։ Այնուամենայնիվ, հաճախ դժվար է ասել, թե ինչպիսի բարելավում սպասել և ինչ հատկություններ է հավանաբար բերելու բարելավման յուրաքանչյուր քայլ։
Այս բլոգ գրառումը դուրս է գալիս տեսության շրջանակից։ Մենք ընդունում ենք գործնական մոտեցում և դիտարկում ենք չատբոտերի բարելավման քայլերը՝ որպես օրինակ վերցնելով բժշկության ոլորտը։ Նախ նկարագրում ենք մեր մեթոդաբանությունը, ապա անցնում իրական օրինակների։ Դրանք ընդգրկում են բժշկական հարցերի մի շարք, որոնցից յուրաքանչյուրը քննարկվում է երեք կարգավորումներից մեկում՝ սովորական large language մոդել, RAG և fine tuned LLM։ Վերջում դուք հստակ պատկերացում կունենաք, թե ինչպես են այս կարգավորումները համեմատվում միմյանց հետ և ինչպես է fine tuning-ը ազդում չատբոտի ու llm մոդելի արդյունավետության վրա։
Չատբոտերի բարելավման բնորոշ քայլեր
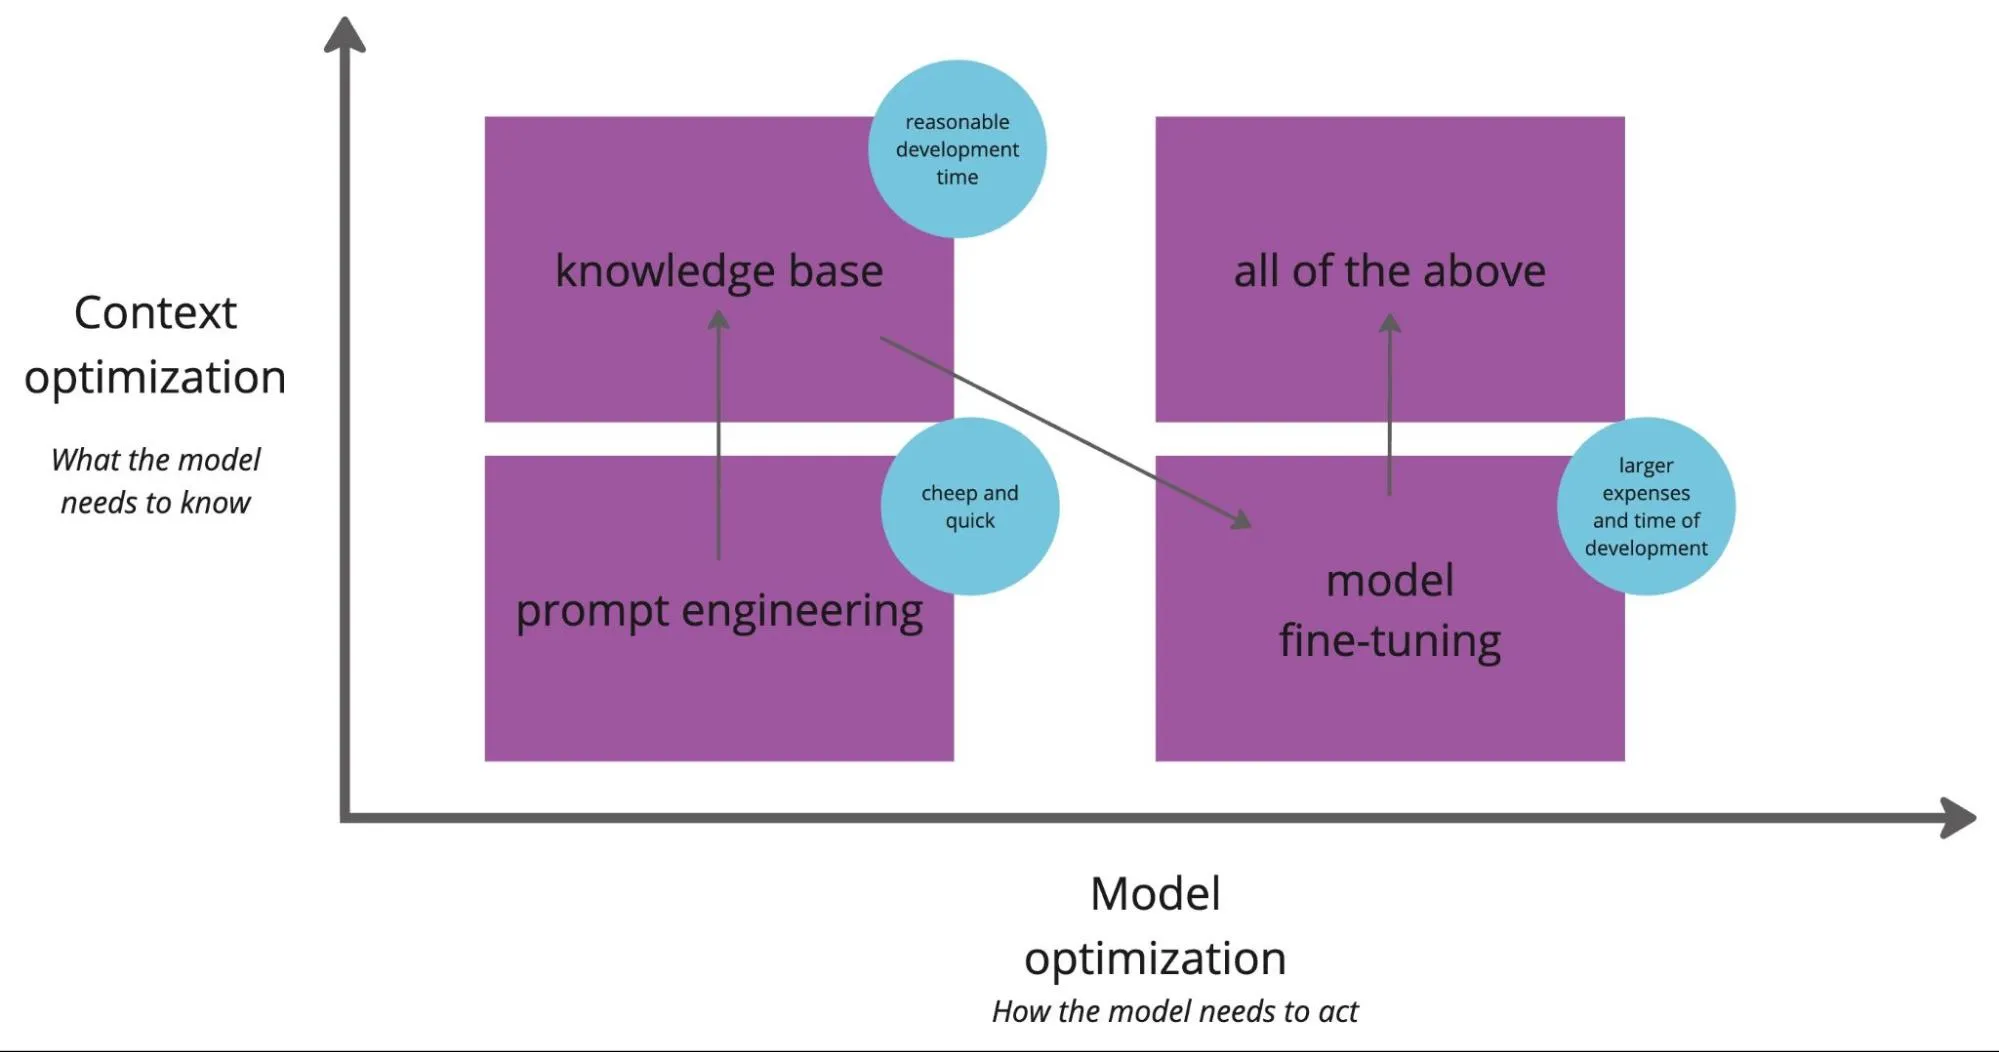
Չատբոտերը լավացնելու համար մենք անցնում ենք վերևի գրաֆիկում ցույց տրված pipeline-ով։
Prompt engineering և Few-shot prompting
Առաջին քայլը prompt engineering-ն է, որը նշանակում է ուղղորդող նախադասությունների կամ բառերի ավելացում, որոնք ուղղորդում են LLM-ին և, արդյունքում, լավացնում նրա աշխատանքը։ Prompt engineering-ի միջոցով կարող ենք ներմուծել persona (ստորև օրինակում նշված է կապույտով), և դա նկատելիորեն բարձրացնում է պատասխանների որակը։ Few shot prompting-ն իր հերթին հանգում է մուտքի և ելքի օրինակ զույգեր տրամադրելուն (ստորև օրինակում նշված է կանաչով)։
Միևնույն ժամանակ, քանի որ prompt-երը շարունակ երկարում են, կարող ենք հասնել մեր LLM-ի սահմաններին։ Ներկայիս մոդելները թույլ են տալիս մի քանի հազար բառ, բայց երբ համատեքստում պահվում են RAG-ով վերցված փաստերը և չատի պատմությունը, այդ առաստաղին կարելի է արագ հասնել։
Դրանից բացի, հետազոտությունները գնալով ավելի շատ են ցույց տալիս, որ շատ երկար համատեքստը միշտ չէ, որ օգտակար է, քանի որ միջինում գտնվող որոշ փաստեր կարող են կորչել (ավելին տե՛ս «Lost in the Middle: How Language Models Use Long Contexts»)։ Երկար համատեքստը նաև մեծացնում է մշակման ժամանակը, ինչը կարող է անցանկալի լինել որոշ հավելվածներում։
Գիտելիքների բազայի բարելավում
Համատեքստի ընդլայնումը բարելավման մեկ այլ խոստումնալից ուղղություն է։ Այն զգալի ջանք է պահանջում, քանի որ ճիշտ տվյալները գտնելը և համոզվելը, որ դրանց փաստերը չեն հակասում արդեն առկաներին, շատ աշխատանք է։ Երբեմն արժե նաև քննադատաբար նայել գոյություն ունեցող գիտելիքների տվյալների բազային և ուղղել երկիմաստ կամ պարզապես սխալ փաստերը (դա պատահում է ավելի հաճախ, քան մարդիկ կարծում են)։
Մոդելի fine tune – մոդելի արդյունավետության բարելավում
Սա մեզ բերում է այն բանին, ինչը շատերը համարում են խնդիրների լուծման սուրբ գրալը՝ fine tuning-ին։ LLM-ները սովորաբար pre trained են ինտերնետում գտնվող հսկայական քանակի տվյալների վրա, օրինակ՝ Wikipedia կամ Common Crawl (հաշվի առնելով դրանց լիցենզիաները, երբ LLM-ը գնում է production)։ Այդ տվյալների վրա մոդելը սովորում է առանց պիտակների, այսինքն՝ հաջորդ token-ի կանխատեսման միջոցով («LLMs are» բառերի համար կանխատեսել հաջորդ բառը)։
Fine tuning-ում կարելի է տարբերակել Q&A LLM-ների առնվազն երկու տարբեր տեսակ.
- LLM Fine tuning, երբ վերցնում ենք մեծ քանակությամբ հասանելի տվյալներ և կիրառում ենք pretraining քայլին նման մեթոդներ, միաժամանակ թույլ տալով pre trained մոդելին որոշակիորեն մասնագիտանալ մեր թիրախային ոլորտում։
- Առաջադրանքին հատուկ fine tuning (հայտնի է նաև որպես supervised fine tuning), երբ տրամադրում ենք մեր ոլորտի Q&A տվյալների հավաքածու և փորձում ենք մոդելին սովորեցնել պատասխանել հարցերին։ Փորձարկման ընթացքում կդիտարկենք մոդել, որը հատուկ վարժեցվել է բժշկական Q&A տվյալների հավաքածուների վրա (օրինակ՝ MedQA-ն պարունակում է մոտ 12 հազար հարց-պատասխան զույգ, իսկ ավելի լայն MedMCQA-ն՝ մոտ 190 հազար պիտակավորված օրինակ զույգ)։
Բժշկական ոլորտի բնութագիրը
Բժշկական ոլորտը մեզ սովորաբար առաջինը մտածել է տալիս «դժվար» և «բարդ» բառերի մասին (եթե դուք բժշկական մասնագետ չեք. նրա համար ոլորտը շատ ավելի պարզ է, քան Casual Joe-ի համար)։ Հիմնական պատճառներն են.
- բարդ, մասնագիտացված գիտելիքի կարիքը. կա մասնագիտացված տերմինաբանության հսկայական քանակ, բարդ կենսաբանական պրոցեսներ և ախտանիշների, հիվանդությունների ու բուժումների միջև բարդ կապեր։
- սխալների բարձր գինը. բժշկությունը սխալի տեղ չի թողնում, քանի որ հալյուցինացիաները կամ սխալ պատասխանները կարող են կյանքեր վտանգել։
- դինամիկ, մշտապես զարգացող ոլորտ. նոր հետազոտությունները, բուժումները և ուղեցույցները շարունակ փոխում են այս ոլորտը, ինչը էլ ավելի դժվար է դարձնում ընթացիկ փաստերով ամուր գիտելիքների բազա կառուցելը։
- էթիկական և իրավական մտահոգություններ. բժշկական ոլորտում ելքերը կարող են խտրական կամ կողմնակալ լինել։
- տվյալների որակը և հասանելիությունը. բժշկական տվյալները դժվար է ձեռք բերել, քանի որ դրանց գաղտնիությունը մեծ մտահոգություն է։ Եվ, ինչպես նշվեց ավելի վաղ, ոլորտը շարունակ փոխվում է, ուստի հին տվյալների հավաքածուները որոշ բնագավառներում կարող են հնացած լինել։
- երկիմաստություն և բացակայող համատեքստ. այս ոլորտում «կախված է» շատ տարածված պատասխան է, քանի որ որոշ հարցերի պատասխանը հաճախ պահանջում է ավելի լայն համատեքստ (այսինքն՝ հիվանդի բժշկական պատմությունը), իսկ գիտելիքների բազայի դեպքերը հաճախ հակասում են միմյանց։
Համեմատվող կարգավորումները
Այս ստուգման մեջ դիտարկում ենք երեք կարգավորում՝ մերկ հարց llama2-ին, llama2 prompt engineering-ով և Meditron (բժշկական տվյալների վրա fine tuned llama2)։ Այս հետազոտության ենթադրությունն այն է, որ օգտագործում ենք 7B մոդելներ։
Մերկ LLM մոդել
LLAMA-2-ը բավականին տարածված մոդել է, և վերջին 8 ամիսների ընթացքում դրա հիման վրա կառուցվել են բազմաթիվ բաց կոդով մոդելներ (Alpaca-ից՝ հրահանգների վրա fine tuned տարբերակից, և Vicuna-ից՝ խոսակցության վրա fine tuned տարբերակից, մինչև Meditron և Galen՝ բժշկական ոլորտի համար fine tuned)։ Այս բազային մոդելի համար մենք կիրառում ենք լռելյայն prompt սխեման՝ առանց լրացուցիչ համակարգային հրահանգների։
Prompt engineering
Prompt engineering-ը նշանակում է հրահանգը այնպես ձևավորել, որ Generative AI մոդելը կարողանա այն մեկնաբանել և հասկանալ։ Կարող եք դա պատկերացնել որպես մասնագիտացված արտահայտությունների կամ բառերի ավելացում, օրինակ՝ «You are an expert in the medical domain.»։
Այնպիսի տեխնիկաները, ինչպիսիք են Chain-of-Thought-ը կամ few-shot prompting-ը, նույնպես մտնում են prompt engineering-ի մեջ։
Մեր օրինակի համար օգտագործում ենք ստորև բերված system prompt-ը (այսինքն՝ հրահանգը, որը կառավարում է համակարգը).
Q&A բժշկական տվյալների վրա finetuned մոդել
Վերջապես, կա Q&A բժշկական տվյալների հավաքածուների վրա fine tuned մոդելը՝ Meditron-ը (որը ներկայումս առաջատար է բժշկական առաջատարների աղյուսակներում)։ Տրված հարցերի համար մենք օգտագործում ենք ստորև բերված հրահանգները՝ այս մոդելից առավելագույնը ստանալու համար.
Արդյունքներ
Այս բաժինը քննարկում է բժշկական Q&A-ում սխալների մի քանի տեսակ՝ պատկերացում տալով, թե ինչ կարող են տալ prompt engineering-ը և fine-tuning-ը։
Սխալներ պատասխաններում
Երեք տարբեր պատասխան, մեկական յուրաքանչյուր մոդելից, ընդ որում Meditron:7b-ից բացի մոդելները պատասխանում են սխալ
Ճիշտ պատասխանն այստեղ «chromosome replication without cell division»-ն է։ Երեքից միայն Meditron-ն է ճիշտ պատասխանում։ Մոդելին բժշկական փորձագետի persona տալը (prompt engineering) այս դեպքում բավարար չէր։ Prompt engineering-ի շնորհիվ մոդելն ընտրեց այլ, ավելի նկարագրական պատասխան, բայց այդ պատասխանը դարձյալ սխալ էր։
Մոդելի fine-tuning-ի հիմնական նպատակն է ընդլայնել նրա գիտելիքները և ամրապնդել ոլորտի մասնագիտացված բառապաշարի ըմբռնումը, և այս օրինակում այդ նպատակը իրագործվեց։
Պատասխանի հակիրճությունը
Օրինակ թիվ 2. սովորական llama-2 մոդելների շատախոս պատասխաններ՝ ընդդեմ Meditron:7B-ի շատ հակիրճ պատասխանների
Օրինակ թիվ 3. սովորական llama-2 մոդելների շատախոս պատասխաններ՝ ընդդեմ Meditron:7B-ի շատ հակիրճ պատասխանների
Այս օրինակները բացահայտում են լայն լսարանի համար նախատեսված LLM-ների (ինչպիսին է սովորական LLAMA-2-ը) հիմնական թուլությունը. նրանց պատասխանները փորձում են բոլորին հարմար լինել, այդ թվում՝ իրական փորձառություն չունեցող մարդկանց։ Արդյունքում դրանց պակասում է մասնագիտացված լսարանի համար անհրաժեշտ հակիրճությունը, ինչը դրանք քիչ օգտակար է դարձնում։
Fine tuned մոդելները կարող են տալ ավելի կարճ, ավելի կոնկրետ պատասխաններ՝ առանց ամեն ինչ բացատրելու, քանի որ դրանց թիրախային լսարանը կարող է ավելի մասնագիտացած լինել ոլորտում (բժշկական մասնագետներ՝ բժիշկներ կամ բուժքույրեր)։
Ընդհանուր նշանակության LLM-ների համեմատ՝ fine tuned LLM-ները հավանաբար ավելի լավ կգործեն այնպիսի չափանիշներով, ինչպիսիք են ճշտությունը (որքան ճշգրիտ է պատասխանը) և հակիրճությունը (երկար պատասխաններից խուսափում UX-ը լավացնելու համար)։ Բժշկական ոլորտում ուշադրության արժանի են նաև մի քանի այլ չափանիշներ.
- Չստուգված բուժումից խուսափելը (ընդհանուր նշանակության LLM-ները, որոնք վարժեցվել են վեբ տվյալների վրա, կարող են հակված լինել այս տեսակի սխալին)
- Հանրային առողջություն (խորհրդատվության հարցումներ վարքագծի վերաբերյալ, որը հակասում է հանրային առողջության ընդհանուր նորմերին)։
Եզրակացություններ
Այս բլոգ գրառումը անդրադարձավ մոդելի արդյունավետությունը բարելավելու հնարավոր ուղիներին և ներկայացրեց փորձարարական կարգավորում 3 տարբերակով՝ սովորական llama2, llama2 prompt engineering-ով և Meditron (բժշկական ոլորտի տվյալների վրա fine-tuned մոդել)։ Մենք հստակ տեսանք, որ fine-tuning-ը կարող է ընդլայնել մոդելի գիտելիքները և փոխել նրա լռելյայն պատասխանի ձևաչափի առանձնահատկությունները (այսինքն՝ պատասխանները դարձնել ավելի հակիրճ)՝ վերջին հաշվով այն ավելի օգտակար դարձնելով վերջնական օգտատիրոջ համար։