AI watermarking-ի բացատրություն
Այս բլոգգրառումը դիտարկում է արհեստական բանականության մեջ watermarking-ը, դրա հնարավոր տեսակները և կիրառումը տարբեր ոլորտներում, այդ թվում՝ պատկերների, տեքստի և աուդիոյի մեջ։
Քանի որ Գեներատիվ AI-ը տարածվում է chatGPT-ի, Dalle-ի, Midjourney-ի և այլ գործիքների միջոցով, գեներացված բովանդակությունը աստիճանաբար շրջապատում է մեզ։ Դրան գումարած՝ մոդելներ մարզելու համար տվյալների ապօրինի օգտագործման վերաբերյալ բազմաթիվ գործեր են ընթանում, օրինակ՝ Getty Images vs Stability.ai (Stable Diffusion-ի հետևում կանգնած ընկերությունը) կամ վիզուալ արտիստներ vs Midjourney կամ Deviant Art։
AI watermarking-ը այս խնդիրների պատասխանն է։ Այս բլոգգրառումը բացատրում է, թե դա ինչ է և ինչպես է այն կիրառվում տարբեր մոդալություններում, ինչպիսիք են պատկերները, տեքստը և աուդիոն։
AI watermarking – սահմանում և կարևորություն
Steg.AI-ի անտեսանելի watermark-ը C2PA ստորագրությամբ
Watermarking բառը կարող է հիշեցնել բանկնոտների վրայի ուլտրամանուշակագույն նշանները կամ դիպլոմների վրայի թղթի հատուկ նշանը – բաներ, որոնք չափազանց դժվար է կեղծել։ AI-ում կա նմանատիպ ստորագրություն։
Watermarking-ը նշանակում է բովանդակությունը նշել այնպես, որ այն կրի լրացուցիչ տեղեկություն, օրինակ՝ իսկության ապացույց։ AI-ում watermark-ը կարող է լինել լիովին տեսանելի (օրինակ՝ բովանդակության մեջ ներդրված տեսանելի կոդ) կամ անտեսանելի (ինչպես վերևի նկարում ցուցադրվածը)։ Այդպիսի օրինաչափությունները կարող են հայտնաբերվել կա՛մ մարդկանց, կա՛մ հատուկ գործիքների կողմից։
Watermarking-ի տեսակները
AI watermarking-ը կարելի է դասակարգել երկու հիմնական եղանակով.
- Բաց/փակ watermarking. Սա կախված է նրանից, թե իրականացումը հասանելի է հանրությանը**։** Բաց watermarking-ը խրախուսում է նորարարությունը, և համայնքը կարող է գտնել ու ուղղել սխալները։ Մյուս կողմից՝ իմանալը, թե ինչ տեսք ունի watermark-ը և ինչպես է այն ստեղծվում, կարող է հեշտացնել այն հեռացնելը կամ կեղծելը ցանկացողների համար։
- Մոդելի/բովանդակության watermarking. Սա կախված է նրանից, թե որտեղ է կիրառվում watermarking-ը՝ հասանելի մոդելի ներսում, թե արտաքին գործիքի միջոցով։ Ընտրությունը կարող է կարևոր լինել, քանի որ որոշ ոլորտներում, ինչպես տեքստը, watermark չի կարելի ստեղծել առանց մոդելի հասանելիության։ Մոդելի watermarking-ը հիմնականում պարտադրում է ելքի և միջանկյալ շերտերի որոշակի բաշխումներ ընտրված մուտքերի համար։ Բովանդակության watermarking-ը կենտրոնանում է տվյալներին աղմուկ կամ ստորագրություն ավելացնելու վրա։
Watermarking-ը տարբեր մոդալություններում
Այս բաժինը անցնում է watermarking-ի տեսակների օրինակներով և բացատրում է, թե ինչպես է watermarking-ը օգտագործվում այնպիսի ոլորտներում, ինչպիսիք են համակարգչային տեսողությունը, տեքստը կամ աուդիոն։
Պատկերներ
Stable Diffusion մոդելներով ստեղծված պատկերներում տեսանելի watermark-ների օրինակներ։
Համակարգչային տեսողության մեջ watermark-ներ ավելացնելը՝ հաստատելու համար, որ տվյալները եկել են որոշակի աղբյուրից, բավական սովորական է դարձել։ Լավ օրինակ է Getty-ի և Stability.ai-ի միջև ընթացող գործը, որտեղ գեներացված պատկերներում երևում է պատկերների մատակարարի watermark-ը։
Միևնույն ժամանակ, Computer Vision-ում կան գեներացված տվյալների համար շատ անտեսանելի watermark-ներ, ինչպիսիք են SynthID-ը (առաջարկվում է Google Cloud-ում պատկերների և նաև աուդիոյի համար), AWS-ի ներկայացրած watermarking API-ն, կամ TruePic-ի և IMATAG-ի բաց կոդով դեմոները։ OpenAI-ը նաև ներկայացրել է իր պատկերների նոր ձևաչափ՝ Dalle-3-ին watermarking ավելացնելու արդյունքում (հիմնված C2PA-ի վրա)։
Համակարգչային տեսողության մեկ այլ հայտնի թեմա տվյալների թունավորումն է (data poisoning), օրինակ՝ Nightshade-ը, որը ձեր պատկերներին ավելացնում է լրացուցիչ աղմուկ (մարդկանց համար անընկալելի), որը կործանարար հետևանքներ ունի անօրինական կերպով հավաքված տվյալների վրա մարզված մոդելների համար։ Պատկերացրեք դաշտում պառկած և ստվեր գցող կովի նկար։ Nightshade-ի կողմից փոխակերպվելուց հետո պատկերը մարդու աչքին անփոփոխ է թվում։ Սակայն մարզվող մոդելի համար ստվերը թաքցնում է կանաչ պայուսակի ձևը, ինչը վնասում է ուսուցման գործընթացը։ Փոխակերպումները, ինչպիսիք են կտրումը, սքրինշոթ անելը, պիքսելների հարթեցումը կամ աղմուկ ավելացնելը, որևէ տարբերություն չեն անում, քանի որ օրինաչափությունները պահպանվում են։ Glaze-ը (նույն Չիկագոյի համալսարանի լաբորատորիայից) աշխատում է նմանատիպ ձևով. այն փոփոխում է պատկերները անկապ ոճով (մարդկանց համար անընկալելի, բայց մեքենաների վրա ուժեղ ազդող), ինչը prompt-ի վրա հիմնված պատկերների գեներացման մոդելներին ստիպում է անհամապատասխան պատկերներ ստեղծել։ Օրինակ, Glaze-ով պաշտպանված ածխանկար պատկերը մեքենան կարող է ընկալել որպես Jackson Pollock-ի ոճով աբստրակտ արվեստ, ուստի «generate me charcoal style image» prompt-ը կարող է հանգեցնել անհամապատասխան, ոչ ցանկալի փոփոխությունների)։
Photoguard-ի իմունիզացիա, վերցված բնօրինակ հոդվածից։
Երբ խոսքը վերաբերում է առկա պատկերներից deep fake-երի ստեղծումը կանխելուն, կան այնպիսի գործիքներ, ինչպիսին Photoguard-ն է։ Նրանց նպատակը նման է վերը նկարագրված մեթոդներին. նրանք փոփոխում են բնօրինակ պատկերները այնպես, որ մարդու աչքը չի տեսնում։ Սակայն ինֆերենսի ժամանակ մոդելները կա՛մ անտեսում են prompt-ը, կա՛մ անտեսում են բնօրինակ պատկերի համատեքստը։
TruePic-ը մի գործիք է, որը հենվում է C2PA ստանդարտի վրա՝ պատկերը նրա մետատվյալներում ստորագրելու համար, ինչը հնարավորություն է տալիս հետևել պատկերի ծագմանը։ Նրա Hugging Face space-ը թույլ է տալիս և՛ ստորագրել պատկերներ, և՛ ստուգել ստորագրությունները։
Ինտերնետն առաջարկում է մի շարք Deepfake դետեկտորներ, ինչպիսիք են HuggingFace-ի վրայի համայնքային դետեկտորները կամ Content at Scale դետեկտորը, բայց նրանց որակն ու կայունությունը հաճախ կասկածելի են։
Տեքստ
AI-ով գեներացված տեքստը հայտնաբերելու GLTR դեմոն
Մինչդեռ պատկերային տվյալների watermarking-ը բավական հեշտ է պատկերացնել, տեքստի watermarking-ը բոլորովին այլ հարց է։ Պատկերների դեպքում պիքսելները կարելի է փոփոխել մարդու աչքի համար անընկալելի տիրույթում, տեքստի դեպքում դա հնարավոր չէ։ Այս ոլորտի լուծումների մեծ մասը օգտվում է ժամանակակից տեքստ գեներացնող մոդելների աշխատանքի սկզբունքից, այն է՝ հաջորդ token-ի կանխատեսումից (օր.՝ originality.ai)։
Տեքստի watermarking-ի մեկ հետաքրքիր մեթոդ բառապաշարը պատահականորեն բաժանում է երկու բազմության՝ նախընտրելի token-ներ («կանաչ token-ներ») և սահմանափակված token-ներ («կարմիր token-ներ»)։ Հետո, կախված watermarking-ի ռեժիմից, սահմանափակված token-ները կա՛մ լիովին խուսափվում են («կոշտ watermarking»), կա՛մ կանաչ խմբի token-ները ստանում են ավելի բարձր հավանականություն («փափուկ watermarking»)։ Մոդելի ելքին միջամտելը կարող է վատթարացնել տեքստի գեներացման որակը, այդ պատճառով WaterBench-ի հեղինակները առաջարկել են միասնական բենչմարկ՝ ավտոռեգրեսիվ LLM-ների համար տարբեր watermarking ալգորիթմներ համեմատելու համար։
Զուտ ինֆերենսի ժամանակ գործող մեթոդների շարքում արժանի է հիշատակման GLTR մեթոդը։ Նախորդ token-ների հիման վրա այն փորձում է կանխատեսել հաջորդ token-ի logit-ները և ապա գտնում է «ընտրված token»-ի դիրքը վերադարձված logit-ների մեջ։ Մարդկանց գրած տեքստը պարունակում է ավելի քիչ «ամենատարածված ընտրություններ» (գրաֆիկում նշված կանաչով) և ավելի շատ հազվադեպերը (գրաֆիկում նշված մանուշակագույնով)։ Սա աշխատում է միայն եթե մենք ունենք մոդելի ելքերի լիարժեք հասանելիություն, որպեսզի կարողանանք ստանալ logit-ներ ցանկացած մուտքի համար։ Բացի այդ, մենք սահմանափակված ենք մեզ հասանելի մոդելներով, այնպես որ «Այս տեքստը գեներացվե՞լ է AI-ով» հարցին պատասխանելու փոխարեն պատասխանում ենք «Այս տեքստը գեներացվե՞լ է XYZ մոդելով» հարցին։
Արժե շեշտել, որ տեքստի watermarking-ի ներկայիս մեթոդները կատարյալից հեռու են և կարող են տալ շատ կեղծ դրական արդյունքներ։ Այդ պատճառով լինում են դեպքեր, երբ OpenAI-ը կարող է լուռ փակել հանրային հասանելիությունը այդպիսի գործիքներին։
Աուդիո
Պատկերների և տեքստի համար GenAI-ի առաջընթացի հետ մեկտեղ աուդիոն ևս արագ զարգանում է։ Ցավոք, ձայնի ճանաչման համակարգերը հաճախ օգտագործվում են բանկերում բիոմետրիկ սկանավորման համար (բարեբախտաբար՝ ոչ միայնակ, այլ սովորաբար PIN-ի, մատնահետքի կամ գաղտնաբառի հետ համատեղ), և դրանք կարող են շահագործվել կասկածելի նպատակներով։
Աուդիոյի watermarking-ը աշխատում է շատ նման պատկերների watermarking-ին. ձայնագրությունը փոփոխվում է մարդկանց լսելի տիրույթից դուրս (20-20000Հց-ից այն կողմ), բայց հատուկ մոդելները կարող են հայտնաբերել փոփոխությունները։
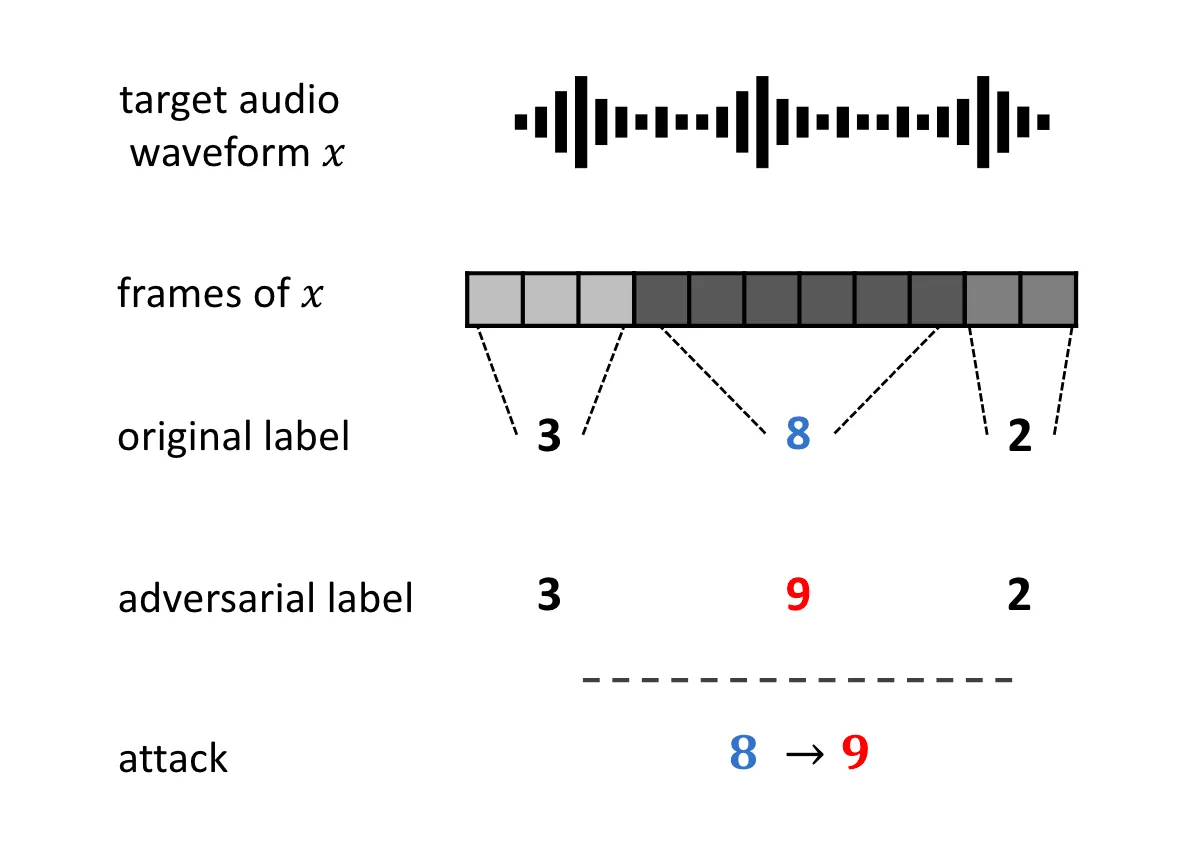
Օգտակար պատկեր Venomave հոդվածից։
Ձայնային համակարգերի համար կան հայտնի մեթոդներ՝ անցանկալի մարզողների կողմից օգտագործվող տվյալները թունավորելու համար։ WaveFuzz-ը ավելացնում է նպատակային աղմուկ, որը ձայնային նմուշները դարձնում է մարզման համար անարժեք, մինչդեռ դրանք մարդ ունկնդիրների համար հնչում են նույն կերպ. հաճախականության տարածության բնութագրերը մնում են նույնը, բայց MFCC ներկայացման կառուցվածքը (լայնորեն օգտագործվում է AI համակարգերի կողմից աուդիոյի համար) տարբեր է։ Venomave-ի հեղինակները, իրենց հերթին, փորձում են ավելացնել աղմուկ, որը աուդիոձայնագրության ընտրված տարրերի համար մոդելը մղում է դեպի որոշման սահման, ինչը աուդիոն ուղղակիորեն վերարտադրելը դարձնում է շատ դժվար։
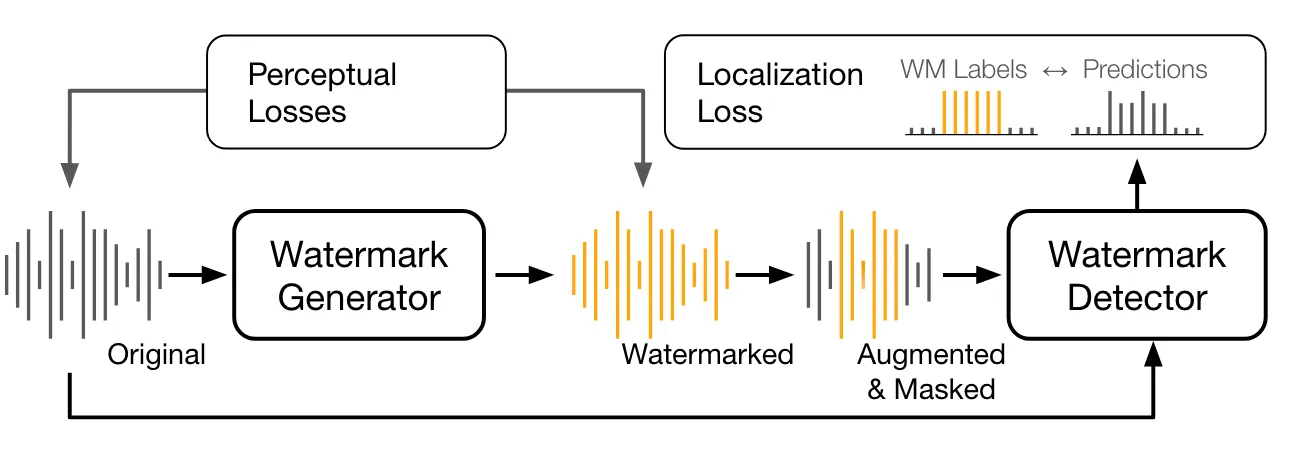
AudioSeal watermarking սխեմայի մարզման կառուցվածքը, վերցված բնօրինակ հոդվածից։
AudioSeal-ը watermarking համակարգի լավ օրինակ է, որտեղ գեներատորն ու դետեկտորը մարզվում են համատեղ, ինչը նրանց դարձնում է կայուն բնական աուդիո փոխակերպումների նկատմամբ՝ միաժամանակ թույլ տալով բարձր որակի հայտնաբերում։ Օգտագործվում է Perceptual loss, որպեսզի բնօրինակ նմուշները և watermark-ված նմուշները (ստեղծված watermark գեներացնող մոդելով) հնարավոր չլինի տարբերել։ Մյուս բաղադրիչը watermark դետեկտորն է, որը հենվում է Localization loss-ի վրա՝ կանխատեսելու, թե արդյոք watermark առկա է, անկախ այն բանից, թե ինչ խանգարումներ են կիրառվել watermark-ված նմուշի վրա։
Եզրակացություններ
Այս բլոգգրառումը բացատրեց, թե ինչ է watermarking-ը AI-ում և որ տեսակներն են գոյություն ունեն, և ակնարկ տվեց, թե ինչպես է այն օգտագործվում այնպիսի ոլորտներում, ինչպիսիք են պատկերը, տեքստը կամ աուդիոն։ Այս գիտելիքով մենք կարող ենք ընտրել ճիշտ գործիքներ – օրինակ՝ կանխելու համար մեր լուսանկարների հավաքումն ու օգտագործումը մարզման համար անցանկալի կողմերի կողմից, կամ որ դրանք դառնան deep fake-երի թիրախ։
Եթե ցանկանում եք watermark ավելացնել ձեր արտադրանքի գեներացրած տվյալներին, կապվեք մեզ հետ։