شرح العلامات المائية في الذكاء الاصطناعي
تتناول هذه التدوينة العلامات المائية في الذكاء الاصطناعي وأنواعها وكيفية استخدامها في مجالات مختلفة، منها الصور والنصوص والصوت.
مع انتشار الذكاء الاصطناعي التوليدي عبر chatGPT وDalle وMidjourney وأدوات أخرى، يحيط بنا المحتوى المولَّد تدريجيًا. وإضافة إلى ذلك، هناك قضايا عديدة جارية بشأن الاستخدام غير القانوني للبيانات في تدريب النماذج، مثل Getty Images ضد Stability.ai (الشركة التي تقف وراء Stable Diffusion) أو الفنانين البصريين ضد Midjourney أو Deviant Art.
العلامات المائية في الذكاء الاصطناعي هي الرد على هذه المشكلات. توضح هذه التدوينة ما هي وكيف تُطبَّق على أنماط مختلفة، مثل الصور والنصوص والصوت.
العلامات المائية في الذكاء الاصطناعي – التعريف والأهمية
العلامة المائية غير المرئية من Steg.AI مع توقيع C2PA
قد تستحضر عبارة «العلامة المائية» إلى ذهنك علامات الأشعة فوق البنفسجية على الأوراق النقدية أو العلامة الورقية الخاصة على الشهادات – أشياء يصعب تزويرها للغاية. وفي الذكاء الاصطناعي، يوجد نوع مشابه من التوقيعات.
تعني العلامة المائية وسم المحتوى بحيث يحمل معلومات إضافية، مثل إثبات الأصالة. وفي الذكاء الاصطناعي، يمكن أن تكون العلامة المائية مرئية بالكامل (مثل رمز مرئي مضمَّن في المحتوى) أو غير مرئية (كالعلامة الظاهرة في الصورة أعلاه). ويمكن اكتشاف هذه الأنماط إما بواسطة البشر أو بأدوات مخصصة.
أنواع العلامات المائية
يمكن تصنيف العلامات المائية في الذكاء الاصطناعي بطريقتين رئيسيتين:
- العلامات المائية المفتوحة/المغلقة: يعتمد هذا على ما إذا كان التنفيذ متاحًا للعموم**.** تشجع العلامات المائية المفتوحة على الابتكار، ويستطيع المجتمع اكتشاف الأخطاء وإصلاحها. ومن ناحية أخرى، فإن معرفة شكل العلامة المائية وكيفية إنتاجها قد تسهّل على أي شخص يريد إزالتها أو تزويرها.
- العلامات المائية للنموذج/للمحتوى: يعتمد هذا على موضع تطبيق العلامة المائية – داخل النموذج المتاح أو عبر أداة خارجية. وقد يكون للاختيار أهمية، لأنه في بعض المجالات، مثل النصوص، لا يمكن إنشاء علامة مائية دون الوصول إلى النموذج. تفرض العلامة المائية للنموذج في المقام الأول توزيعات معينة للمخرجات وللطبقات الوسيطة لمجموعة مختارة من المدخلات. أما العلامة المائية للمحتوى فتركّز على إضافة ضوضاء أو توقيع إلى البيانات.
العلامات المائية عبر الأنماط المختلفة
يستعرض هذا القسم أمثلة على أنواع العلامات المائية ويشرح كيفية استخدامها في مجالات مثل رؤية الحاسوب أو النصوص أو الصوت.
الصور
أمثلة على علامات مائية مرئية في صور أنتجتها نماذج Stable Diffusion.
في رؤية الحاسوب، أصبحت إضافة العلامات المائية لتأكيد أن البيانات جاءت من مصدر معين أمرًا شائعًا إلى حد ما. ومن الأمثلة الجيدة على ذلك القضية الجارية بين Getty وStability.ai، حيث يمكن رؤية العلامة المائية لمزوّد الصور في الصور المولَّدة.
وفي الوقت نفسه، تضم رؤية الحاسوب كثيرًا من العلامات المائية غير المرئية للبيانات المولَّدة، مثل SynthID (المتاح على Google Cloud للصور وللصوت كذلك)، أو واجهة العلامات المائية البرمجية التي قدمتها AWS، أو العروض التوضيحية مفتوحة المصدر من TruePic وIMATAG. كما قدمت OpenAI صيغة جديدة لصورها نتيجة إضافة العلامات المائية إلى Dalle-3 (بالاعتماد على C2PA).
وثمة موضوع شائع آخر في رؤية الحاسوب هو تسميم البيانات، مثل Nightshade الذي يضيف ضوضاء إضافية إلى صورك (لا يدركها البشر) لها عواقب مدمرة على النماذج المدرَّبة على بيانات جُمعت بشكل غير قانوني. تخيّل صورة بقرة مستلقية في حقل وتلقي بظلها. بعد أن يحوّلها Nightshade، تبدو الصورة بلا تغيير للعين البشرية. أما بالنسبة إلى النموذج الذي يجري تدريبه، فإن الظل يخفي شكل حقيبة يد خضراء، مما يفسد عملية التعلّم. ولا تُجدي التحويلات مثل القص والتقاط لقطات الشاشة وتنعيم البكسلات أو إضافة الضوضاء، لأن الأنماط تبقى. ويعمل Glaze (من المختبر نفسه في جامعة شيكاغو) بطريقة مماثلة: فهو يغيّر الصور بأسلوب لا صلة له بها (لا يدركه البشر لكنه يؤثر بقوة في الآلات)، مما يجعل نماذج توليد الصور المعتمدة على التوجيهات تنتج صورًا غير ذات صلة. فعلى سبيل المثال، قد تدرك الآلة صورة بالفحم محمية بـ Glaze على أنها فن تجريدي بأسلوب Jackson Pollock، فيؤدي التوجيه «generate me charcoal style image» إلى تغييرات غير ذات صلة وغير مرغوبة).
تحصين Photoguard، مأخوذ من الورقة الأصلية.
وعندما يتعلق الأمر بمنع إنشاء التزييف العميق (deep fakes) من الصور الموجودة، توجد أدوات مثل Photoguard. وهدفها يشبه الأساليب الموصوفة أعلاه: فهي تعدّل الصور الأصلية بطريقة لا تراها العين البشرية. لكن النماذج، أثناء الاستدلال، إما تتجاهل التوجيه أو تتجاهل سياق الصورة الأصلية.
TruePic أداة تعتمد على معيار C2PA لتوقيع صورة في بياناتها الوصفية، مما يتيح تتبع أصل الصورة. ويتيح فضاؤها على Hugging Face توقيع الصور والتحقق من التوقيعات معًا.
ويقدم الإنترنت عددًا من كاشفات التزييف العميق، مثل الكاشفات المجتمعية على HuggingFace أو كاشف Content at Scale، لكن جودتها واستقرارها مثار شك في كثير من الأحيان.
النصوص
عرض GLTR التوضيحي لرصد النصوص المولَّدة بالذكاء الاصطناعي
بينما يسهل تصور وضع علامات مائية على بيانات الصور، يختلف الأمر تمامًا مع النصوص. ففي الصور، يمكن تغيير البكسلات ضمن نطاق لا تدركه العين البشرية؛ أما في النصوص فهذا غير ممكن. وتستفيد معظم الحلول في هذا المجال من طريقة عمل نماذج توليد النصوص الحالية، أي التنبؤ بالرمز التالي (مثل originality.ai).
إحدى طرق وضع العلامات المائية على النصوص المثيرة للاهتمام تقسّم المفردات عشوائيًا إلى مجموعتين: رموز مفضلة («الرموز الخضراء») ورموز مقيَّدة («الرموز الحمراء»). ثم، بحسب نمط وضع العلامة المائية، تُتجنب الرموز المقيَّدة كليًا («العلامة المائية الصارمة») أو تحصل الرموز من المجموعة الخضراء على احتمال أعلى («العلامة المائية المرنة»). والعبث بمخرجات النموذج قد يضعف جودة توليد النص، ولهذا قدّم مؤلفو WaterBench معيارًا موحدًا لمقارنة خوارزميات العلامات المائية المختلفة للنماذج اللغوية الكبيرة ذاتية الانحدار.
ومن بين الطرق التي تعمل في وقت الاستدلال فحسب، تستحق طريقة GLTR الذكر. فهي تحاول، استنادًا إلى الرموز السابقة، التنبؤ بالقيم اللوغاريتمية (logits) للرمز التالي ثم تحدد موضع «الرمز المختار» بين القيم المُعادة. والنص الذي يكتبه البشر يحتوي على «خيارات شائعة» أقل (معلَّمة بالأخضر في الرسم) وعلى خيارات نادرة أكثر (معلَّمة بالأرجواني في الرسم). ولا يعمل ذلك إلا إذا كان لدينا وصول كامل إلى مخرجات النموذج، فنحصل على القيم اللوغاريتمية لأي مدخل نريده. وإضافة إلى ذلك، نحن مقيَّدون بالنماذج التي نستطيع الوصول إليها، فبدلًا من الإجابة عن «هل ولّد الذكاء الاصطناعي هذا النص؟»، نجيب عن «هل ولّد النموذج XYZ هذا النص؟».
ومن الجدير بالتأكيد أن طرق وضع العلامات المائية الحالية على النصوص بعيدة عن الكمال ويمكن أن تنتج كثيرًا من الإيجابيات الكاذبة. ولهذا السبب تحدث حالات قد تسحب فيها OpenAI بهدوء الوصول العام إلى مثل هذه الأدوات.
الصوت
إلى جانب تقدم الذكاء الاصطناعي التوليدي للصور والنصوص، يتطور الصوت بسرعة أيضًا. ومن المؤسف أن أنظمة التعرف على الصوت تُستخدم كثيرًا في المسح الحيوي في البنوك (ولحسن الحظ ليس وحدها، بل غالبًا مع رقم سري أو بصمة إصبع أو كلمة مرور)، ويمكن استغلالها لأغراض مشبوهة.
تعمل العلامات المائية الصوتية بشكل شبيه بعلامات الصور: يُعدَّل التسجيل خارج النطاق الذي يسمعه البشر (ما بعد 20-20000Hz)، ومع ذلك تستطيع النماذج المخصصة اكتشاف التغييرات.
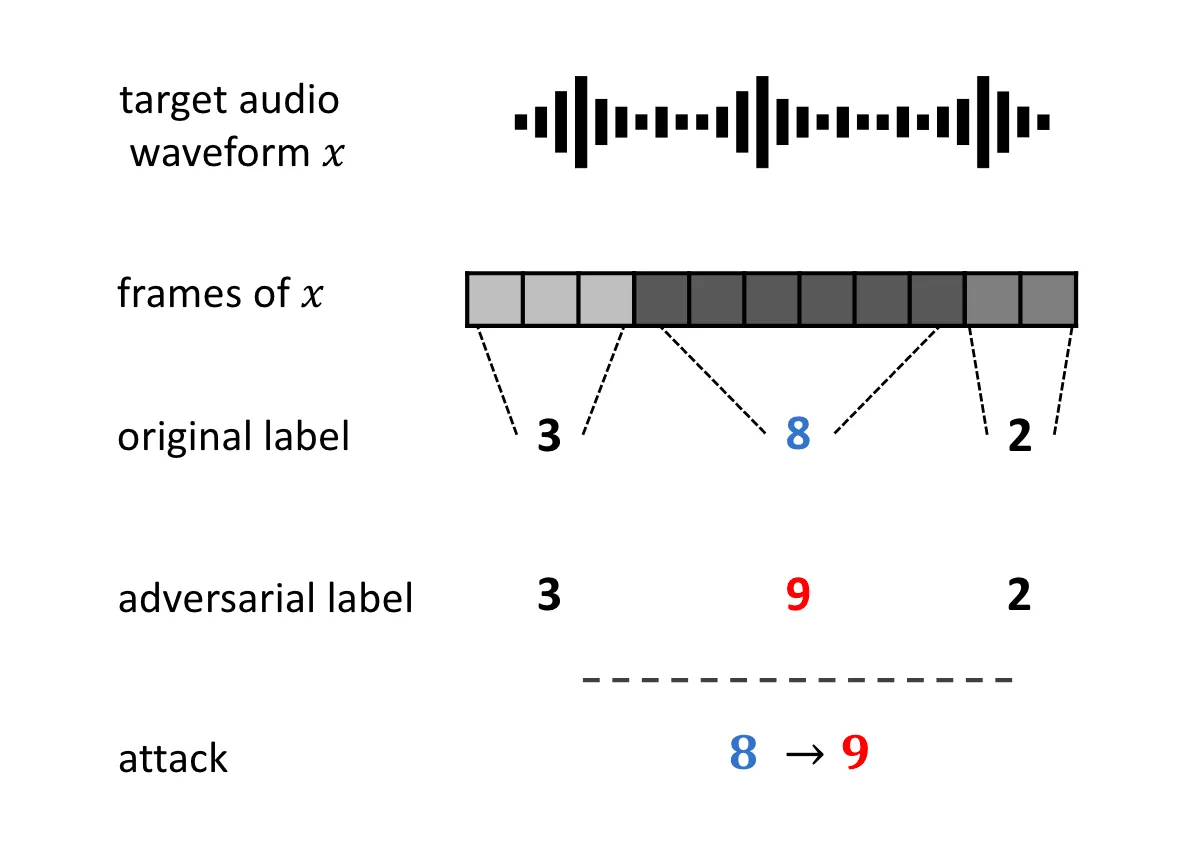
صورة مفيدة من ورقة Venomave.
وبالنسبة إلى أنظمة الصوت، توجد طرق معروفة لتسميم البيانات التي يستخدمها المدرِّبون غير المرغوب فيهم. فـ WaveFuzz يضيف ضوضاء موجَّهة تجعل العينات الصوتية عديمة القيمة للتدريب بينما تبدو متطابقة للمستمعين البشر: تبقى خصائص فضاء التردد كما هي، لكن بنية تمثيل MFCC (المستخدم على نطاق واسع في أنظمة الذكاء الاصطناعي للصوت) تختلف. أما مؤلفو Venomave فيحاولون إضافة ضوضاء تدفع النموذج، لعناصر مختارة من التسجيل الصوتي، نحو حدّ القرار، مما يجعل إعادة إنتاج الصوت مباشرةً أمرًا بالغ الصعوبة.
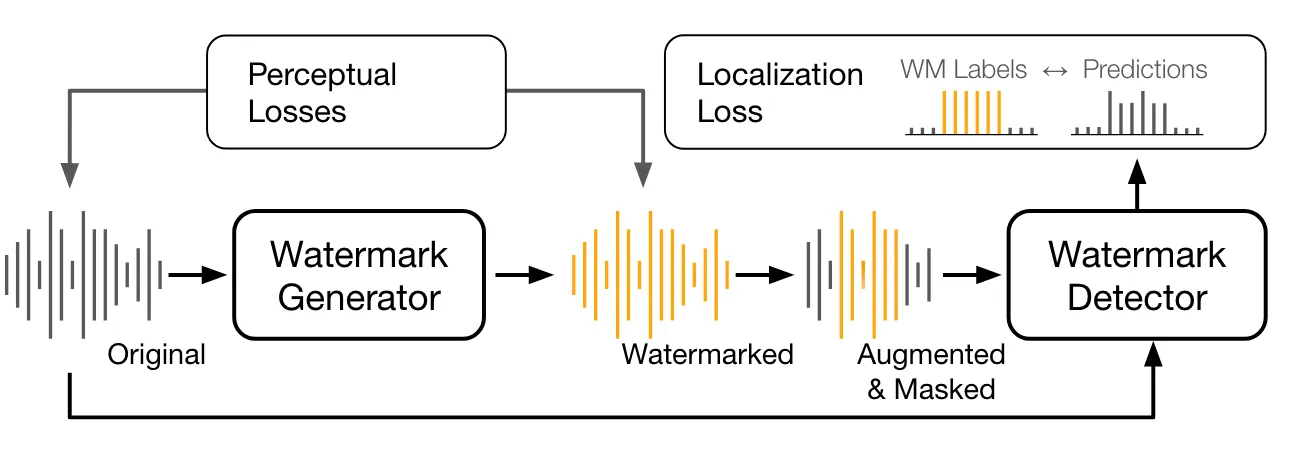
إعداد التدريب لمخطط العلامات المائية AudioSeal، مأخوذ من الورقة الأصلية.
يُعد AudioSeal مثالًا جيدًا على نظام علامات مائية يُدرَّب فيه المولِّد والكاشف معًا، مما يجعلهما متينين أمام التحويلات الطبيعية للصوت مع إتاحة كشف عالي الجودة. ويُستخدم فقدان إدراكي (Perceptual loss) حتى لا يمكن التمييز بين العينات الأصلية والعينات الموسومة (التي ينتجها نموذج توليد العلامات المائية). أما المكوّن الآخر فهو كاشف العلامة المائية، الذي يعتمد على فقدان التموضع (Localization loss) للتنبؤ بوجود علامة مائية أم لا، مهما كانت الاضطرابات المطبقة على العينة الموسومة.
الخلاصات
شرحت هذه التدوينة ما العلامات المائية في الذكاء الاصطناعي وما الأنواع الموجودة منها، وقدمت نظرة عامة على كيفية استخدامها في مجالات مثل الصور أو النصوص أو الصوت. وبهذه المعرفة قد نتمكن من اختيار الأدوات المناسبة – مثلًا لمنع جمع صورنا واستخدامها في التدريب من جهات غير مرغوب فيها، أو لمنع تحولها إلى هدف للتزييف العميق.
إذا أردتَ وضع علامة مائية على البيانات التي ينتجها منتجك، فلا تتردد في التواصل معنا!