ماذا يمنحك الضبط الدقيق لنموذج LLM فعلًا؟
مقارنة بين أساليب تحسين روبوتات الدردشة الطبية للأسئلة والأجوبة.
عاجلًا أم آجلًا، يصادف كل من يعمل في معالجة اللغات الطبيعية، وفي روبوتات الدردشة والنماذج اللغوية الكبيرة تحديدًا، مصطلحات مثل هندسة التلقين (prompt engineering) والضبط الدقيق للنموذج (fine tuning) كوسيلتين لتكييف نظامه أو تحسينه. ومع ذلك، كثيرًا ما يصعب معرفة نوع التحسّن المتوقع وما الصفات التي قد تجلبها كل خطوة تحسين.
يتجاوز هذا المقال النظرية. فنحن نتبع نهجًا عمليًا وننظر في خطوات تحسين روبوتات الدردشة، مستخدمين المجال الطبي مثالًا. نصف أولًا منهجيتنا، ثم ننتقل إلى أمثلة واقعية. وهي تشمل طيفًا من الأسئلة الطبية، يُفحص كل منها في واحد من ثلاثة إعدادات: نموذج لغوي كبير عادي، وRAG، ونموذج LLM مضبوط ضبطًا دقيقًا. وفي النهاية ستكوّن صورة واضحة عن كيفية مقارنة هذه الإعدادات ببعضها، وعن تأثير الضبط الدقيق في أداء روبوت الدردشة ونموذج llm.
الخطوات المعتادة لتحسين روبوتات الدردشة
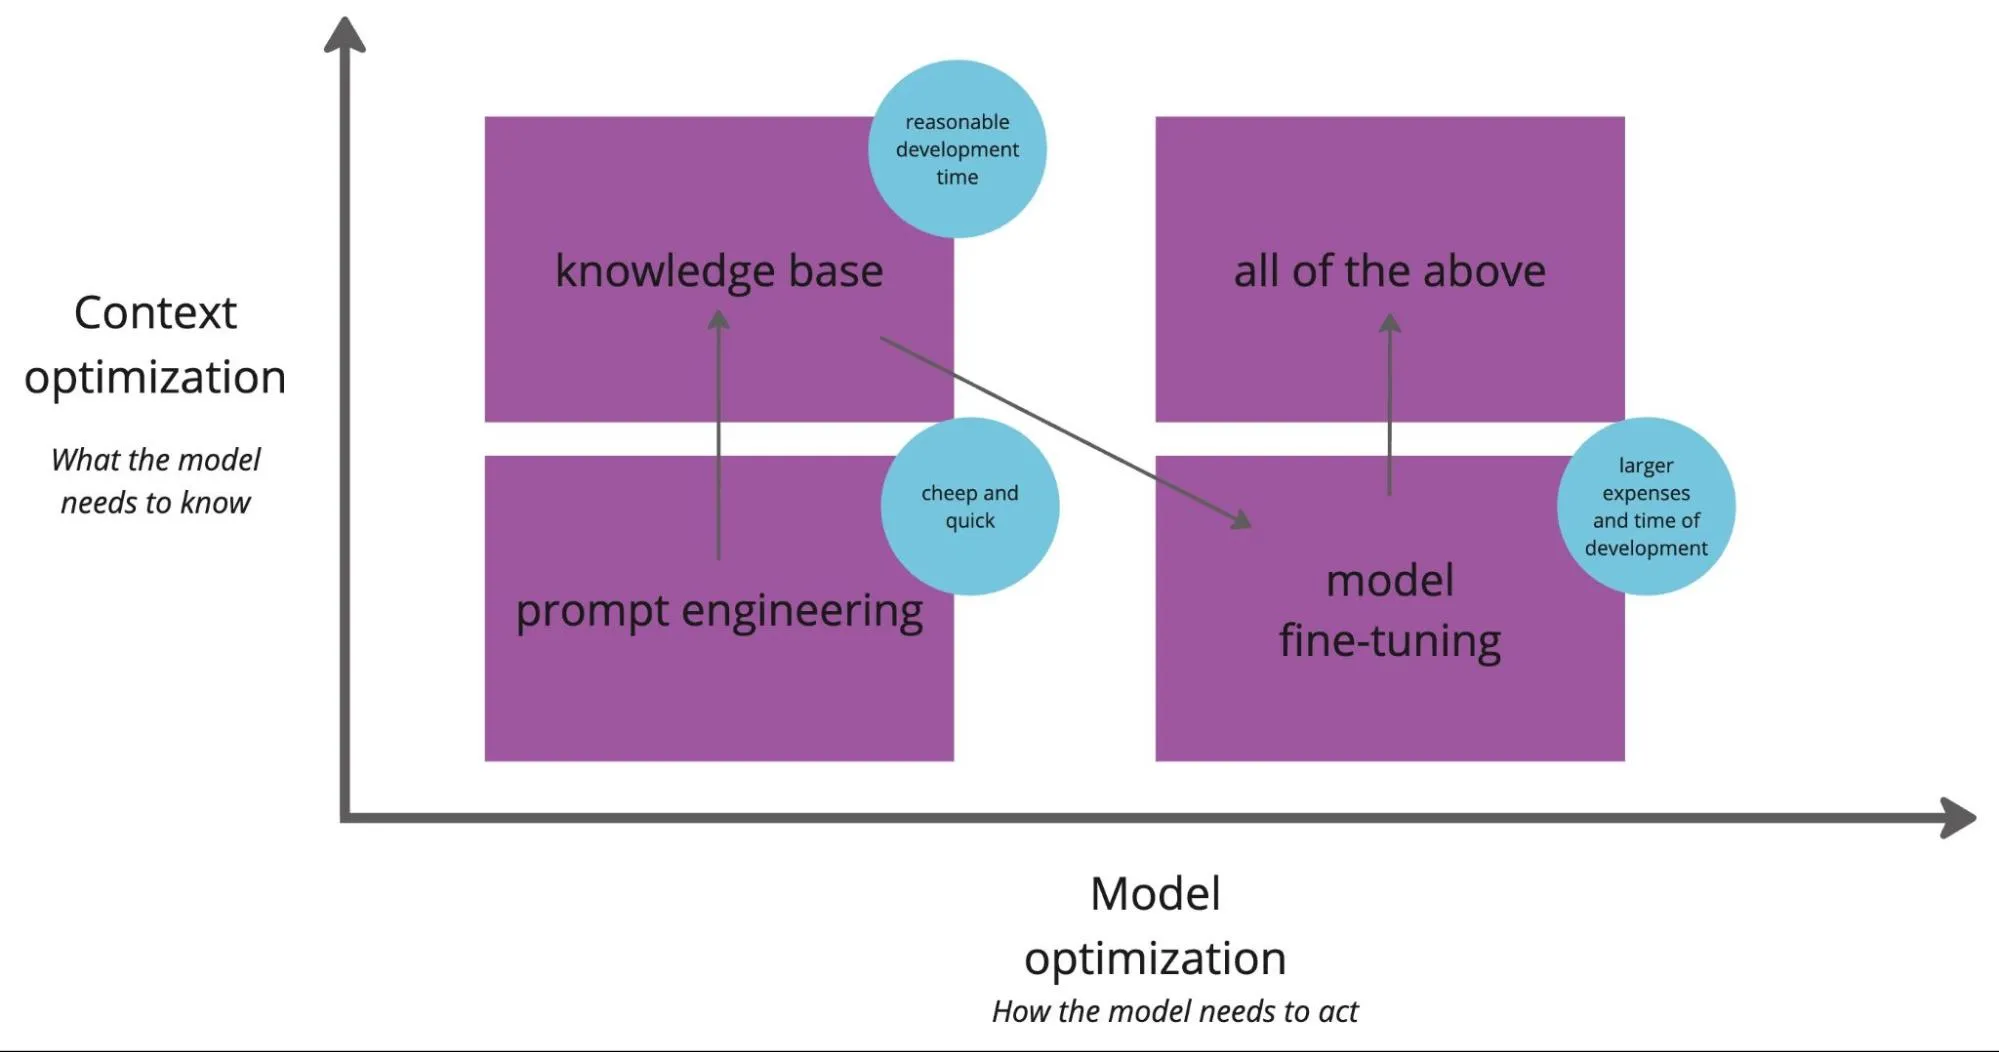
لتحسين روبوتات الدردشة، نمرّ بالمسار الموضح في الرسم أعلاه.
هندسة التلقين والتلقين بأمثلة قليلة
الخطوة الأولى هي هندسة التلقين، وتعني إضافة جمل أو كلمات إرشادية توجّه النموذج اللغوي وتحسّن بالتالي أداءه. فمن خلال هندسة التلقين يمكننا إدخال شخصية (معلَّمة بالأزرق في المثال أدناه)، وهذا يرفع جودة الإجابات بشكل ملحوظ. أما التلقين بأمثلة قليلة فيتلخص في تزويد النموذج بأزواج مدخلات ومخرجات نموذجية (معلَّمة بالأخضر في المثال أدناه).
وفي الوقت نفسه، ومع استمرار تزايد طول التلقينات، قد نصل إلى حدود نموذجنا اللغوي. تسمح النماذج الحالية ببضعة آلاف من الكلمات، لكن عندما تُحفظ الحقائق المسترجعة عبر RAG وسجل المحادثة في السياق، قد يُبلغ هذا السقف سريعًا.
وإضافة إلى ذلك، تُظهر الأبحاث بشكل متزايد أن السياق الطويل جدًا ليس مفيدًا دائمًا، لأن بعض الحقائق في المنتصف قد تضيع (انظر «Lost in the Middle: How Language Models Use Long Contexts» لمزيد من التفاصيل). كما أن السياق الطويل يزيد زمن المعالجة، وقد يكون ذلك غير مرغوب في بعض التطبيقات.
تحسين قاعدة المعرفة
يُعد توسيع السياق مجالًا واعدًا آخر للتحسين. وهو يتطلب جهدًا كبيرًا، لأن تحديد البيانات الصحيحة والتأكد من عدم تعارض حقائقها مع الحقائق الموجودة يتطلب عملًا كثيرًا. وفي بعض الأحيان يفيد أيضًا إلقاء نظرة نقدية على قاعدة المعرفة الحالية وتصحيح الحقائق الغامضة أو الخاطئة ببساطة (وهذا يحدث أكثر مما يظن الناس).
ضبط النموذج ضبطًا دقيقًا – تحسين أداء النموذج
يقودنا هذا إلى ما يعتبره كثيرون الكأس المقدسة لحل المشكلات: الضبط الدقيق. تُدرَّب النماذج اللغوية الكبيرة عادةً مسبقًا على كميات ضخمة من البيانات الموجودة على الإنترنت، مثل Wikipedia أو Common Crawl (مع مراعاة تراخيصها عند وضع النموذج في الإنتاج). وعلى هذه البيانات يتعلم النموذج دون أي وسوم، أي عبر التنبؤ بالرمز التالي (للكلمات «LLMs are»، يتنبأ بالكلمة التالية).
في الضبط الدقيق، يمكن التمييز بين نوعين مختلفين على الأقل من نماذج LLM للأسئلة والأجوبة:
- الضبط الدقيق للنموذج اللغوي، حيث نأخذ كميات كبيرة من البيانات المتاحة ونطبّق أساليب تشبه خطوة التدريب المسبق، مع السماح للنموذج المدرَّب مسبقًا بأن يتخصص قليلًا في مجالنا المستهدف.
- الضبط الدقيق الموجّه لمهمة محددة (ويُعرف أيضًا بالضبط الدقيق الخاضع للإشراف)، حيث نزوّد النموذج بمجموعة بيانات أسئلة وأجوبة من مجالنا ونحاول تعليمه الإجابة عن الأسئلة. وخلال التجربة سننظر في نموذج مدرَّب خصيصًا على مجموعات بيانات الأسئلة والأجوبة الطبية (على سبيل المثال، يحتوي MedQA على نحو 12 ألف زوج من الأسئلة والأجوبة، بينما يحتوي MedMCQA الأوسع على نحو 190 ألف زوج من الأمثلة الموسومة).
خصائص المجال الطبي
يميل المجال الطبي إلى جعلنا نفكر أولًا في كلمات مثل «صعب» و«معقّد» (إلا إذا كنت متخصصًا طبيًا، وعندها يكون المجال أبسط بكثير بالنسبة إليك مما هو لدى Casual Joe). والأسباب الرئيسية:
- الحاجة إلى معرفة معقدة ومتخصصة – فهناك كمّ هائل من المصطلحات المتخصصة والعمليات البيولوجية المعقدة والروابط المتشابكة بين الأعراض والأمراض والعلاجات.
- التكلفة العالية للأخطاء – فالطب لا يترك مجالًا للخطأ، إذ قد تعرّض الهلوسات أو الإجابات الخاطئة الأرواح للخطر.
- مجال ديناميكي دائم التطور – فالأبحاث والعلاجات والإرشادات الجديدة تغيّر هذا المجال باستمرار، مما يجعل بناء قاعدة معرفة سليمة بحقائق حديثة أصعب.
- المخاوف الأخلاقية والقانونية – ففي المجال الطبي قد تكون المخرجات تمييزية أو متحيزة.
- جودة البيانات وتوفرها: يصعب الحصول على البيانات الطبية لأن خصوصيتها شاغل كبير. وكما ذُكر سابقًا، فإن المجال يتغير باستمرار، لذا قد تكون مجموعات البيانات الأقدم قديمة في بعض النواحي.
- الغموض ونقص السياق: في هذا المجال، «يعتمد الأمر» إجابة شائعة جدًا، لأن الإجابة عن بعض الأسئلة تتطلب غالبًا سياقًا أوسع (أي التاريخ الطبي للمريض)، وكثيرًا ما تتناقض الحالات في قاعدة المعرفة فيما بينها.
الإعدادات المقارَنة
في هذا الفحص ننظر في ثلاثة إعدادات: سؤال مجرد إلى llama2، وllama2 مع هندسة التلقين، وMeditron (نموذج llama2 مضبوط ضبطًا دقيقًا على بيانات طبية). والافتراض في هذا البحث أننا نستخدم نماذج بحجم 7B.
نموذج LLM الأساسي
LLAMA-2 نموذج شائع إلى حد كبير، وخلال الأشهر الثمانية الماضية بُنيت فوقه نماذج مفتوحة المصدر كثيرة (من Alpaca، وهي نسخة مضبوطة على التعليمات، وVicuna، وهي نسخة مضبوطة على المحادثة، وصولًا إلى Meditron وGalen المضبوطين للمجال الطبي). وفي هذا النموذج الأساسي نطبّق مخطط التلقين الافتراضي دون أي تعليمات نظام إضافية.
هندسة التلقين
تعني هندسة التلقين صياغة تعليمة بحيث يستطيع نموذج الذكاء الاصطناعي التوليدي تفسيرها وفهمها. ويمكنك اعتبارها إضافة عبارات أو كلمات متخصصة مثل «You are an expert in the medical domain.».
وتندرج تقنيات مثل Chain-of-Thought أو التلقين بأمثلة قليلة تحت هندسة التلقين أيضًا.
في مثالنا نستخدم تلقين النظام التالي (أي التعليمة التي تتحكم في النظام):
نموذج مضبوط ضبطًا دقيقًا على بيانات طبية للأسئلة والأجوبة
وأخيرًا، هناك النموذج المضبوط ضبطًا دقيقًا على مجموعات بيانات الأسئلة والأجوبة الطبية، Meditron (الذي يتصدر حاليًا لوائح المتصدرين الطبية). وللأسئلة المطروحة نستخدم التعليمات أدناه للحصول على أقصى استفادة من هذا النموذج:
النتائج
يستعرض هذا القسم عدة أنواع من الأخطاء في الأسئلة والأجوبة الطبية، ليعطي فكرة عما يمكن أن تقدمه هندسة التلقين والضبط الدقيق.
أخطاء في الإجابات
ثلاث إجابات مختلفة، واحدة من كل نموذج، حيث أجابت النماذج غير Meditron:7b إجابة خاطئة
الإجابة الصحيحة هنا هي «تضاعف الكروموسومات دون انقسام الخلية.» ومن بين النماذج الثلاثة، لم يُصب إلا Meditron. ولم يكن منح النموذج شخصية خبير طبي (هندسة التلقين) كافيًا في هذه الحالة. فبفضل هندسة التلقين اختار النموذج إجابة أخرى أكثر وصفًا، لكنها ظلت خاطئة.
يهدف الضبط الدقيق للنموذج أساسًا إلى توسيع معرفته وتقوية استيعابه لمفردات المجال المتخصصة، وفي هذا المثال تحقق هذا الهدف.
إيجاز الإجابة
المثال رقم 2: إجابات مسهبة من نماذج llama-2 العادية مقابل إجابات موجزة جدًا من Meditron:7B
المثال رقم 3: إجابات مسهبة من نماذج llama-2 العادية مقابل إجابات موجزة جدًا من Meditron:7B
تكشف هذه الأمثلة نقطة الضعف الرئيسية في النماذج اللغوية الموجهة إلى جمهور واسع (مثل LLAMA-2 العادي): فإجاباتها تحاول إرضاء الجميع، بمن فيهم الأشخاص الذين لا يملكون خبرة حقيقية. ونتيجة لذلك تفتقر إلى الإيجاز الذي يحتاجه جمهور متخصص، مما يجعلها قليلة الفائدة.
يمكن للنماذج المضبوطة ضبطًا دقيقًا أن تعطي إجابات أقصر وأكثر تحديدًا دون شرح كل شيء، لأن جمهورها المستهدف قد يكون أكثر تخصصًا في المجال (مهنيون طبيون مثل الأطباء أو الممرضين).
وبالمقارنة مع النماذج اللغوية العامة، من المرجح أن تتفوق النماذج المضبوطة ضبطًا دقيقًا في معايير مثل الصحة (مدى دقة الإجابة) والإيجاز (تجنب الإجابات الطويلة لتحسين تجربة المستخدم). وفي المجال الطبي هناك بعض المعايير الأخرى التي تستحق الانتباه أيضًا:
- تجنب العلاجات غير الموثقة (فالنماذج اللغوية العامة، المدرَّبة على بيانات الويب، قد تكون عرضة لهذا النوع من الأخطاء)
- الصحة العامة (طلبات النصح بشأن سلوك يخالف معايير الصحة العامة).
الاستنتاجات
تناول هذا المقال الطرق الممكنة لتحسين أداء النموذج، وعرض إعدادًا تجريبيًا بثلاثة أشكال: llama2 العادي، وllama2 مع هندسة التلقين، وMeditron (نموذج مضبوط ضبطًا دقيقًا على بيانات المجال الطبي). ورأينا بوضوح أن الضبط الدقيق يمكنه توسيع معرفة النموذج وتغيير خصائص صيغة إجابته الافتراضية (أي جعل الإجابات أكثر إيجازًا)، مما يجعله في النهاية أكثر فائدة للمستخدم النهائي.