اختبار الحمل لنموذج ML باستخدام Locust
تعرّف على كيفية اختبار الحمل لنموذج ذكاء اصطناعي منشور لمعرفة كيف يتعامل مع كميات متفاوتة من حركة المستخدمين.
تعرّف على كيفية اختبار الحمل لنموذج ذكاء اصطناعي منشور لمعرفة كيف يتعامل مع كميات متفاوتة من حركة المستخدمين.
تستطيع نماذج تعلّم الآلة حل الكثير من المشكلات التجارية المعقدة، ولهذا تعتمد عليها منتجات أعمال كثيرة اليوم. وإلى جانب أداء النموذج نفسه، المقاس بمجموعة من المقاييس المختلفة، فإن تجربة المستخدم (UX) في المنتج المدعوم بالذكاء الاصطناعي مهمة أيضًا. وأحيانًا، من منظور الأعمال، يكون إعطاء المستخدم إجابة سريعة أهم، حتى على حساب معدل خطأ أعلى.
وبمجرد تحديد قيود زمن التشغيل للنموذج، يمكن لفريق هندسة ML إجراء اختبارات تقيس مدى سرعة استجابة نظام ML. في هذه المقالة، سأوضح كيفية إجراء اختبار الحمل والأداء لنموذج ذكاء اصطناعي. وباستخدام أداة locust، سنحاكي الطلبات القادمة من مستخدمي النظام ونفحص كيف تؤثر في استخدام الموارد وزمن استجابة نظام تعلّم الآلة المنشور. تفضّل بمواصلة القراءة وجرّب التقنيات الموصوفة هنا!
اختبار الأداء
قبل أن نبدأ، شرح موجز للمصطلحات المستخدمة في المقالة. ما هو اختبار الأداء بالضبط؟
اختبار أداء التطبيق طريقة لتحليل كيف يؤثر الحمل على الخدمة في زمن استجابتها، ومدى جودة توسعها، وما إذا كانت متسامحة مع الأعطال. فعبر زيادة حركة الشبكة، يمكننا تحديد اللحظة التي تبدأ فيها الخدمة بالإرهاق ويبدأ عدد الطلبات غير المعالَجة بالارتفاع. وهذا مهم جدًا من منظور واجهة المستخدم ومن منظور استقرار النظام. وعندما تقع نماذج تعلّم الآلة خلف API مكشوفة، يمكننا التحقق من كيفية تأثير حركة الطلبات في زمن الاستجابة واستخدام الموارد. ولإجراء اختبارات الحمل، يمكننا إما كتابة سكربت خاص بنا أو اللجوء إلى أدوات جاهزة مثل locust.
إعداد التجربة
مثالنا نظام ML لتصنيف النصوص مبني على BERT، يُقدَّم عبر BentoML داخل حاوية Docker. والخدمة متاحة على منفذ معين عبر REST API. وتشغّل حاوية أخرى أداة اختبار الحمل، وهي locust المذكورة سابقًا. وهي تحاكي مستخدمين يستدعون نموذج تعلّم الآلة بإرسال طلبات إلى نقطة النهاية المكشوفة.
وتشغّل حاويات أخرى الخدمات التي تجمع المقاييس التي يوفرها BentoML وتعرضها بصريًا، وهي Prometheus وGrafana.
يوضح المخطط أدناه المكونات وكيف تتفاعل. يرسل Locust الطلبات إلى خدمة BentoML التي تقدّم نموذج تعلّم الآلة. ومعالجة هذه الطلبات تحدّث مقاييس الخدمة، التي يقرؤها Prometheus في الوقت الفعلي ويمررها إلى Grafana.
في تلك الخدمة الأخيرة، يمكننا بناء تصورات لهذه المقاييس ودراسة سلوك الخدمة تحت الحمل. وفي الإنتاج، يمكننا إعداد تنبيهات مناسبة تُطلَق بمجرد أن تبدأ الخدمة بإظهار علامات الإرهاق.
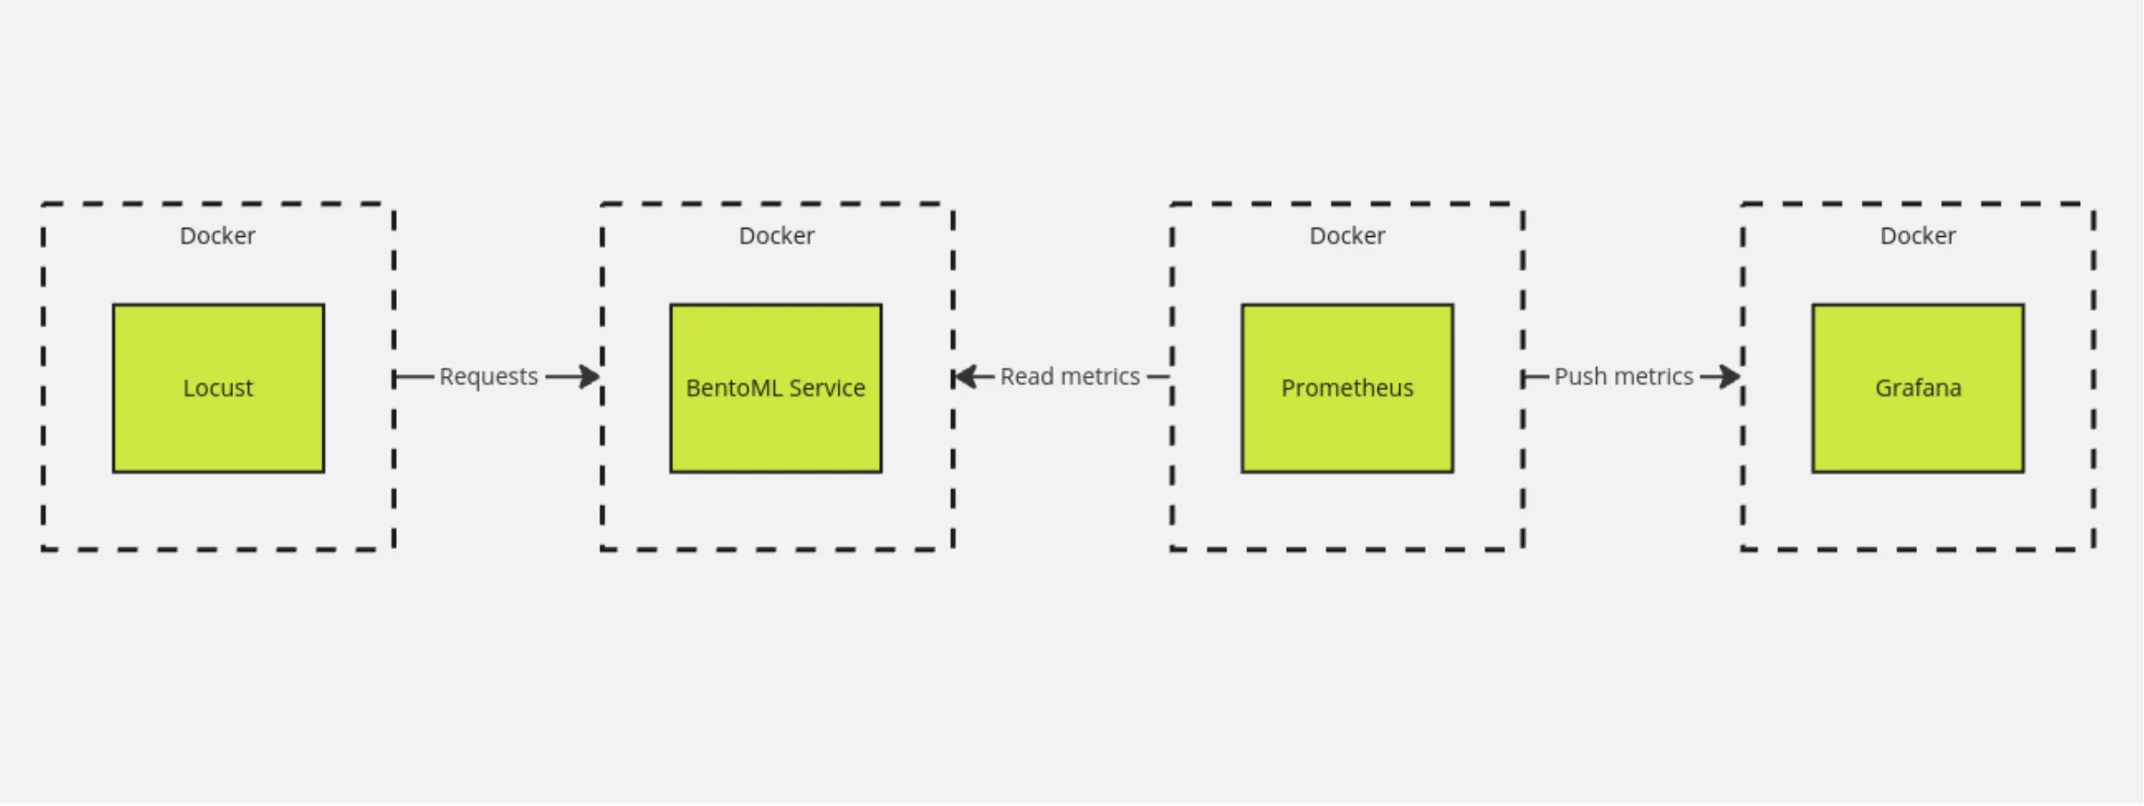
معمارية المكونات في السيناريو المناقَش.
كيف نفعل ذلك؟
نفترض أن خدمة نموذج تعلّم الآلة تعمل محليًا وتكشف REST API. إليك شيفرة نموذجية تشغّل نموذجًا من سجل BentoML على المنفذ 3000:
bentoml serve <MODEL_NAME:TAG> -p 3000يعرّف ملف docker-compose.yaml أدناه خدمة locust واحدة تكشف المنفذ 8089، وتتحدث إلى خدمة تعمل محليًا على المنفذ 3000. ويعتمد الأمر الذي تشغّله الخدمة على سكربت Python يصف كيفية اختبار التطبيق. ويحدد الأمر عدد المستخدمين المراد محاكاتهم، وكيف ينبغي أن ينمو عددهم مع الوقت، ومدة تشغيل المحاكاة، وأين يُخزَّن التقرير والملف الذي يحوي نتائج المحاكاة.
version: '3'

services:
 locust:
   image: locustio/locust
   ports:
     - "8089:8089"
   volumes:
     - ./:/mnt/locust
   command: -f /mnt/locust/locustfile.py
   --host=http://host.docker.internal:3000 --headless --users 1000
   --spawn-rate 5 --run-time 5m --html /mnt/locust/results.html
   --csv /mnt/locust/results -t 5m
   extra_hosts:
     - "host.docker.internal:host-gateway"
إليك معنى الخيارات الممررة إلى أمر locust (بناءً على الوثائق):
–host- العنوان الذي تعمل عليه خدمة ML–headless- التشغيل دون الوضع الرسومي–users- الحد الأقصى لعدد المستخدمين في حركة المرور المحاكاة–spawn-rate- عدد المستخدمين الذين يُضافون إلى مجموعة المستخدمين الحالية في كل فترة زمنية معينة–run-time- المدة الإجمالية للمحاكاة–html- المسار الذي سيُخزَّن فيه تقرير HTML--csv- المسار الذي ستُخزَّن فيه نتائج CSV
القسم extra_hosts، مع عنوان خاص في أمر locust، مطلوب كي تتمكن الأداة العاملة داخل حاوية من الوصول بشكل صحيح إلى خدمة تعمل محليًا على الجهاز المضيف (كما هو موصوف في هذا النقاش). وإذا كان نموذج ML متاحًا كحاوية Docker، فيمكن وضع كل خدمة لازمة للاختبارات في ملف docker-compose.
يحوي الملف locustfile.py مثالًا لنقطة نهاية واحدة مراد اختبارها، إلى جانب حمولة نموذجية لنموذج تعلّم الآلة.
from locust import HttpUser, between, task

EXAMPLE_DATA = {
   "data": ["This is an example sentence to classify."]
}

class QuickstartUser(HttpUser):
   """Load test user class."""

   wait_time = between(1, 5) # defines interval between user requests

   @task
   def classify(self):
       """Trigger `classify` endpoint."""
       self.client.post("/classify", json=EXAMPLE_DATA)
إذا كان docker-compose.yaml وlocustfile.py في المجلد نفسه، فما عليك سوى تشغيل docker compose up لإطلاق الحاوية. ينفّذ Locust المحاكاة، وبعد انتهائها تُكتب النتائج بصيغة .csv وتقرير HTML في المجلد الحالي.
التقارير
ينتج عن تشغيل اختبار الحمل تقرير HTML يحتوي تصورًا تفاعليًا لحمل الخدمة، إضافة إلى النتائج بصيغة .csv.
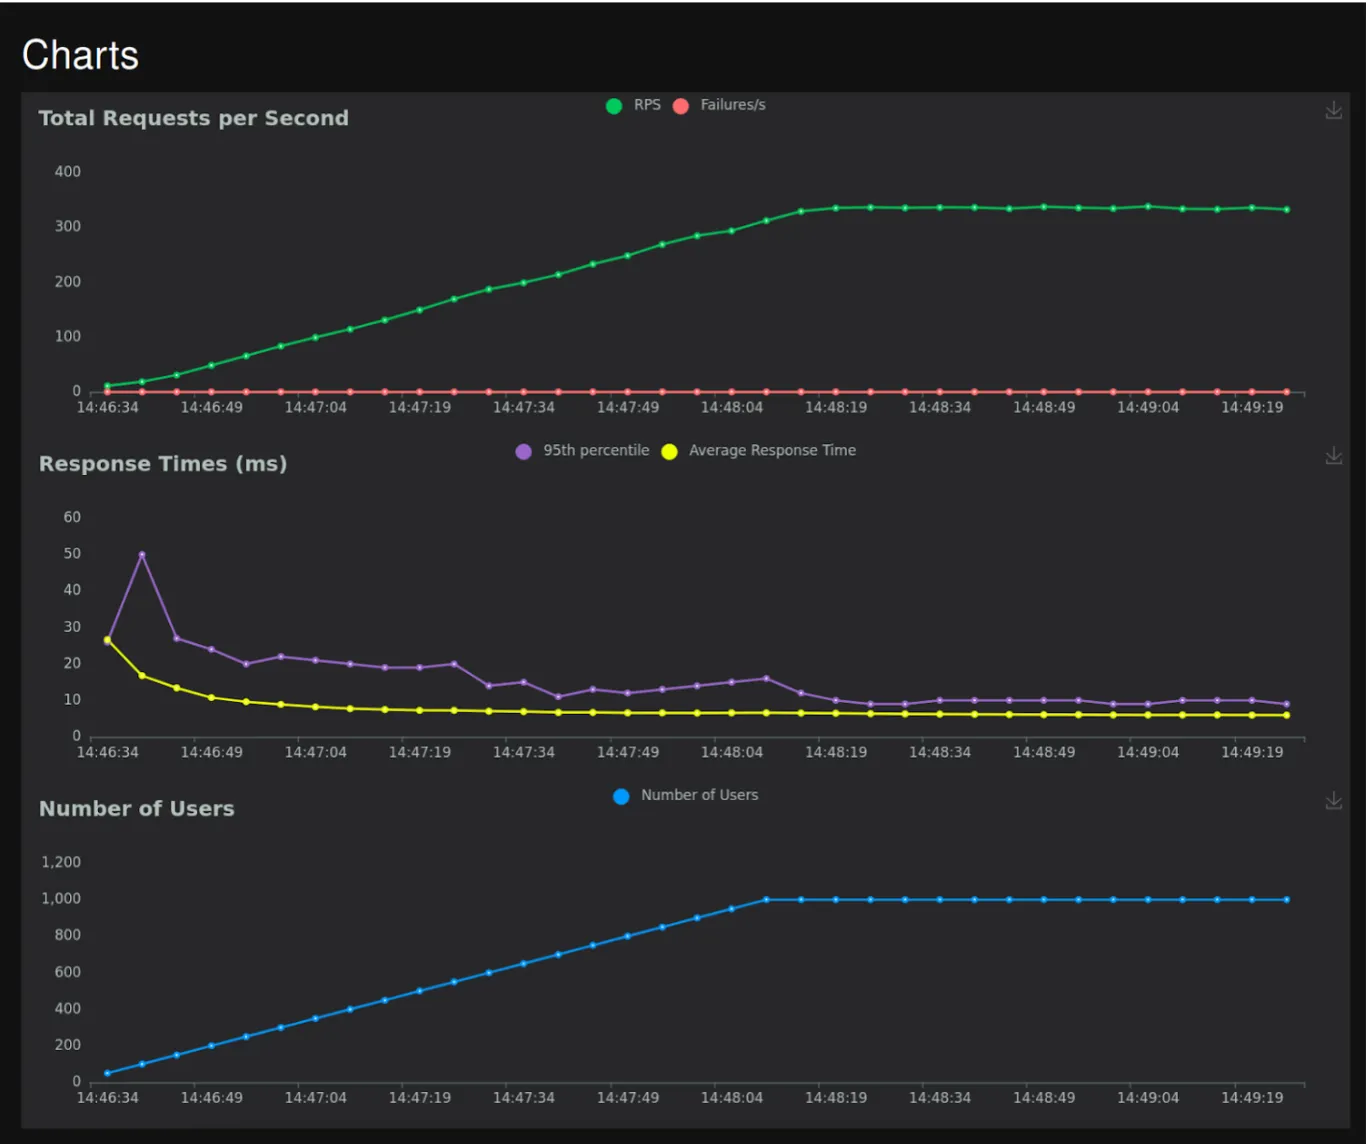
مخططات عدد المستخدمين وزمن الاستجابة والاستعلامات في الثانية على مدى محاكاة حركة المرور.
تغطي الإحصاءات الملخصة مع أزمنة الاستجابة لكل نقطة نهاية معرّفة في locustfile.py. المئينات 50 و60 و70 و80 و90 و95 و99 و100 من توزيع أزمنة استجابة النموذج. والقيم الأكثر إبلاغًا واستخدامًا هي أزمنة الاستجابة عند المئين 95 والمئين 99، ويمكن قراءتها على أنها أطول زمن استجابة يُتوقع من النموذج في 95 أو 99 بالمئة من الحالات.
مراقبة مقاييس النظام
باستخدام Locust، يمكننا فقط مراقبة زمن الاستجابة وإحصاءات كيفية معالجة الطلبات المحاكاة وتحليلها والإبلاغ عنها. أما نماذج تعلّم الآلة في العالم الحقيقي فتستهلك موارد أكثر بكثير، بما فيها وحدات GPU، وهذه هي ما نريد مراقبته وتحليل أدائه.
ولفعل ذلك، يمكننا الاعتماد على Prometheus وGrafana لجمع السجلات الصادرة عن خدمة نموذج ML المنشور لدينا وعرضها بصريًا.
عند هذه النقطة، إذا نُشر النموذج مع نقطة نهاية المقاييس الافتراضية (/metrics)، تتاح سجلات إضافية عن استخدام موارد النظام. ولعرضها بصريًا، علينا تشغيل Grafana وPrometheus وبعض الخدمات الأخرى اللازمة. ولهذا سأعيد استخدام حزمة docker-compose مفتوحة المصدر قائمة.
ستجد أدناه ملف docker-compose.yaml المعدَّل، الذي يطلق، إلى جانب Grafana وPrometheus، حاوية Locust أيضًا ويبدأ اختبار الحمل تلقائيًا.
version: '3.8'

volumes:
 prometheus_data: {}
 grafana_data: {}

services:
 locust:
   image: locustio/locust
   ports:
     - "8089:8089"
   volumes:
     - ./:/mnt/locust
   command: -f /mnt/locust/locustfile.py --host=http://host.docker.internal:8000
   --headless --users 100 --spawn-rate 5 --run-time 5m
   --html /mnt/locust/results.html --csv /mnt/locust/results -t 5m
   extra_hosts:
     - "host.docker.internal:host-gateway"
 prometheus:
   image: prom/prometheus
   restart: always
   volumes:
     - ./prometheus:/etc/prometheus/
     - prometheus_data:/prometheus
   command:
     - '--config.file=/etc/prometheus/prometheus.yml'
     - '--storage.tsdb.path=/prometheus'
     - '--web.console.libraries=/usr/share/prometheus/console_libraries'
     - '--web.console.templates=/usr/share/prometheus/consoles'
   ports:
     - 9090:9090
   extra_hosts:
     - "host.docker.internal:host-gateway"

 grafana:
   image: grafana/grafana
   user: '472'
   restart: always
   environment:
     GF_INSTALL_PLUGINS: 'grafana-clock-panel,grafana-simple-json-datasource'
   volumes:
     - grafana_data:/var/lib/grafana
     - ./grafana/provisioning/:/etc/grafana/provisioning/
   env_file:
     - ./grafana/config.monitoring
   ports:
     - 3000:3000
   depends_on:
     - prometheus
لنفترض أن النموذج يعمل محليًا على المنفذ 8000 مع BentoML، بعد تشغيله بالأمر:
bentoml serve handler.svc -p 8000.
يؤدي تشغيل docker compose up في المجلد الذي يحوي ملف docker-compose.yaml إلى بدء جميع الحاويات وبدء اختبار الحمل. وبمجرد فتح Grafana في المتصفح، تتاح مقاييس النظام التي يوفرها Prometheus. ومع لوحة معلومات مناسبة، يمكننا مراقبة استخدام الموارد طوال اختبار الحمل وحركة الشبكة المحاكاة.
الأمر بهذه السهولة حقًا! مجموعة حاويات مراقبة أداء التطبيقات هذه عامة وقابلة لإعادة الاستخدام. فعند استبدال النموذج وتحديث معالج BentoML، فإن التعديل الوحيد المطلوب في إعداد القياس هو تغيير اسم نقطة النهاية والبيانات النموذجية في locustfile.py.
النتائج
الملف docker-compose.yaml الذي أعددناه هو إعداد قياس عام لأي نموذج يُقدَّم عبر HTTP (BentoML ليس شرطًا)، يحاكي حركة شبكة المستخدمين الذين يستدعون خدمة ML. وإضافة تجميع مقاييس النظام تتيح لك علاوة على ذلك تتبع كيفية استهلاك نماذج ML للموارد الرئيسية مثل RAM وVRAM وCPU وGPU. وبتعديل معاملات حركة الشبكة المحاكاة، يمكنك إجراء اختبارات الحمل واختبارات الأداء واختبارات الإجهاد لخدمات ML.
توضح لقطة الشاشة أدناه الأداة أثناء العمل. فطوال المحاكاة، يبقى استخدام GPU عند مستوى ثابت، ولا يشكّل التوسع أي خطر لخطأ نفاد الذاكرة (Out Of Memory). وبهذه الطريقة، يمكننا اختبار وتأكيد أن خدمتنا مبنية بحيث لا تؤدي زيادة حركة المرور إلى تعطلها.
مقاييس النظام معروضة بصريًا في Grafana.
الخلاصة
أوضحت هذه المقالة كيف يمكن لأداة Locust محاكاة الحمل الذي ستواجهه خدمة تجري استدلال نموذج تعلّم الآلة. وقدمت شيفرة بسيطة لاختبار نقاط النهاية المكشوفة، وأنواع القطع المتوقعة، وكيفية الاستفادة منها. كما بيّنت كيفية عرض هذه المقاييس بصريًا في Grafana، وهو ما يفيد عند تصميم مراقبة خدمات ML للإنتاج أو أثناء اختبار الأداء. آمل أن تساعدك هذه المقالة على تصميم وتحليل الخدمات والنشرات التي تتضمن نماذج تعلّم الآلة بشكل أكثر فعالية.