ML մոդելի բեռնվածքային թեստավորում Locust-ով
Տեսեք, թե ինչպես բեռնվածքային թեստավորել տեղակայված AI մոդելը՝ իմանալու համար, թե ինչպես է այն հաղթահարում օգտատերերի տրաֆիկի տարբեր քանակները։
Տեսեք, թե ինչպես բեռնվածքային թեստավորել տեղակայված AI մոդելը՝ իմանալու համար, թե ինչպես է այն հաղթահարում օգտատերերի տրաֆիկի տարբեր քանակները։
Մեքենայական ուսուցման մոդելները ընդունակ են լուծել բազմաթիվ բարդ բիզնես խնդիրներ, ուստի այսօր այդքան բիզնես արտադրանքներ հենվում են դրանց վրա։ Բացի մոդելի սեփական արտադրողականությունից, որը չափվում է տարբեր մետրիկներով, կարևոր է նաև AI-ով աշխատող արտադրանքի UX-ը։ Երբեմն, բիզնեսի տեսանկյունից, օգտատիրոջը արագ պատասխան տալը ավելի կարևոր է, նույնիսկ սխալների ավելի բարձր մակարդակի գնով։
Երբ մոդելի աշխատանքային սահմանափակումները սահմանված են, ML ինժեներական թիմը կարող է թեստեր անցկացնել, որոնք չափում են, թե որքան արագ է արձագանքում ML համակարգը։ Այս հոդվածում ցույց կտամ, թե ինչպես իրականացնել արհեստական ինտելեկտի մոդելի բեռնվածքային և արտադրողականության թեստավորում։ locust գործիքով մենք կմոդելավորենք համակարգի օգտատերերից եկող հարցումները և կուսումնասիրենք, թե ինչպես են դրանք ազդում տեղակայված մեքենայական ուսուցման համակարգի ռեսուրսների օգտագործման և արձագանքման ժամանակի վրա։ Ազատ զգացեք շարունակել ընթերցել և փորձել այստեղ նկարագրված տեխնիկաները։
Արտադրողականության թեստավորում
Սկսելուց առաջ՝ հոդվածում օգտագործվող տերմինների հակիրճ բացատրություն։ Ի՞նչ է իրականում արտադրողականության թեստավորումը։
Հավելվածի արտադրողականության թեստավորումը մեթոդ է՝ վերլուծելու, թե ինչպես է ծառայության վրա բեռը ազդում նրա արձագանքման ժամանակի վրա, որքան լավ է այն մասշտաբավորվում և արդյոք սխալների նկատմամբ կայուն է։ Ցանցային տրաֆիկը մեծացնելով՝ կարող ենք ճշգրիտ որոշել այն պահը, երբ ծառայությունը սկսում է գերբեռնվել, և չմշակված հարցումների քանակը սկսում է աճել։ Սա շատ կարևոր է և՛ UI-ի տեսանկյունից, և՛ համակարգի կայունության համար։ Երբ մեքենայական ուսուցման մոդելները գտնվում են բաց API-ի հետևում, կարող ենք ստուգել, թե ինչպես է հարցումների տրաֆիկը ազդում արձագանքման ժամանակի և ռեսուրսների օգտագործման վրա։ Բեռնվածքային թեստեր անցկացնելու համար կարող ենք կա՛մ գրել սեփական սկրիպտ, կա՛մ դիմել պատրաստի գործիքների, ինչպիսին է locust-ը։
Փորձի կարգավորում
Մեր օրինակը BERT-ի վրա հիմնված ML տեքստի դասակարգման համակարգ է, որը սպասարկվում է BentoML-ով Docker կոնտեյների ներսում։ Ծառայությունը հասանելի է տվյալ պորտով REST API-ի միջոցով։ Մեկ այլ կոնտեյներ աշխատեցնում է բեռնվածքային թեստավորման գործիքը՝ նախկինում նշված locust-ը։ Այն մոդելավորում է օգտատերերի, որոնք կանչում են մեքենայական ուսուցման մոդելը՝ հարցումներ ուղարկելով բաց endpoint-ին։
Հետագա կոնտեյներները աշխատեցնում են ծառայություններ, որոնք հավաքում և վիզուալիզացնում են BentoML-ի տրամադրած մետրիկները, այն է՝ Prometheus-ը և Grafana-ն։
Ստորև դիագրամը ցույց է տալիս բաղադրիչներն ու դրանց փոխազդեցությունը։ Locust-ը հարցումներ է ուղարկում BentoML ծառայությանը, որը սպասարկում է մեքենայական ուսուցման մոդելը։ Այս հարցումների մշակումը թարմացնում է ծառայության մետրիկները, որոնք Prometheus-ը կարդում է իրական ժամանակում և փոխանցում Grafana-ին։
Այս վերջին ծառայությունում կարող ենք կառուցել այս մետրիկների վիզուալիզացիաներ և ուսումնասիրել, թե ինչպես է ծառայությունը վարվում բեռի տակ։ Production-ում կարող ենք կարգավորել համապատասխան ահազանգեր, որոնք կգործարկվեն, երբ ծառայությունը սկսի գերբեռնվածության նշաններ ցույց տալ։
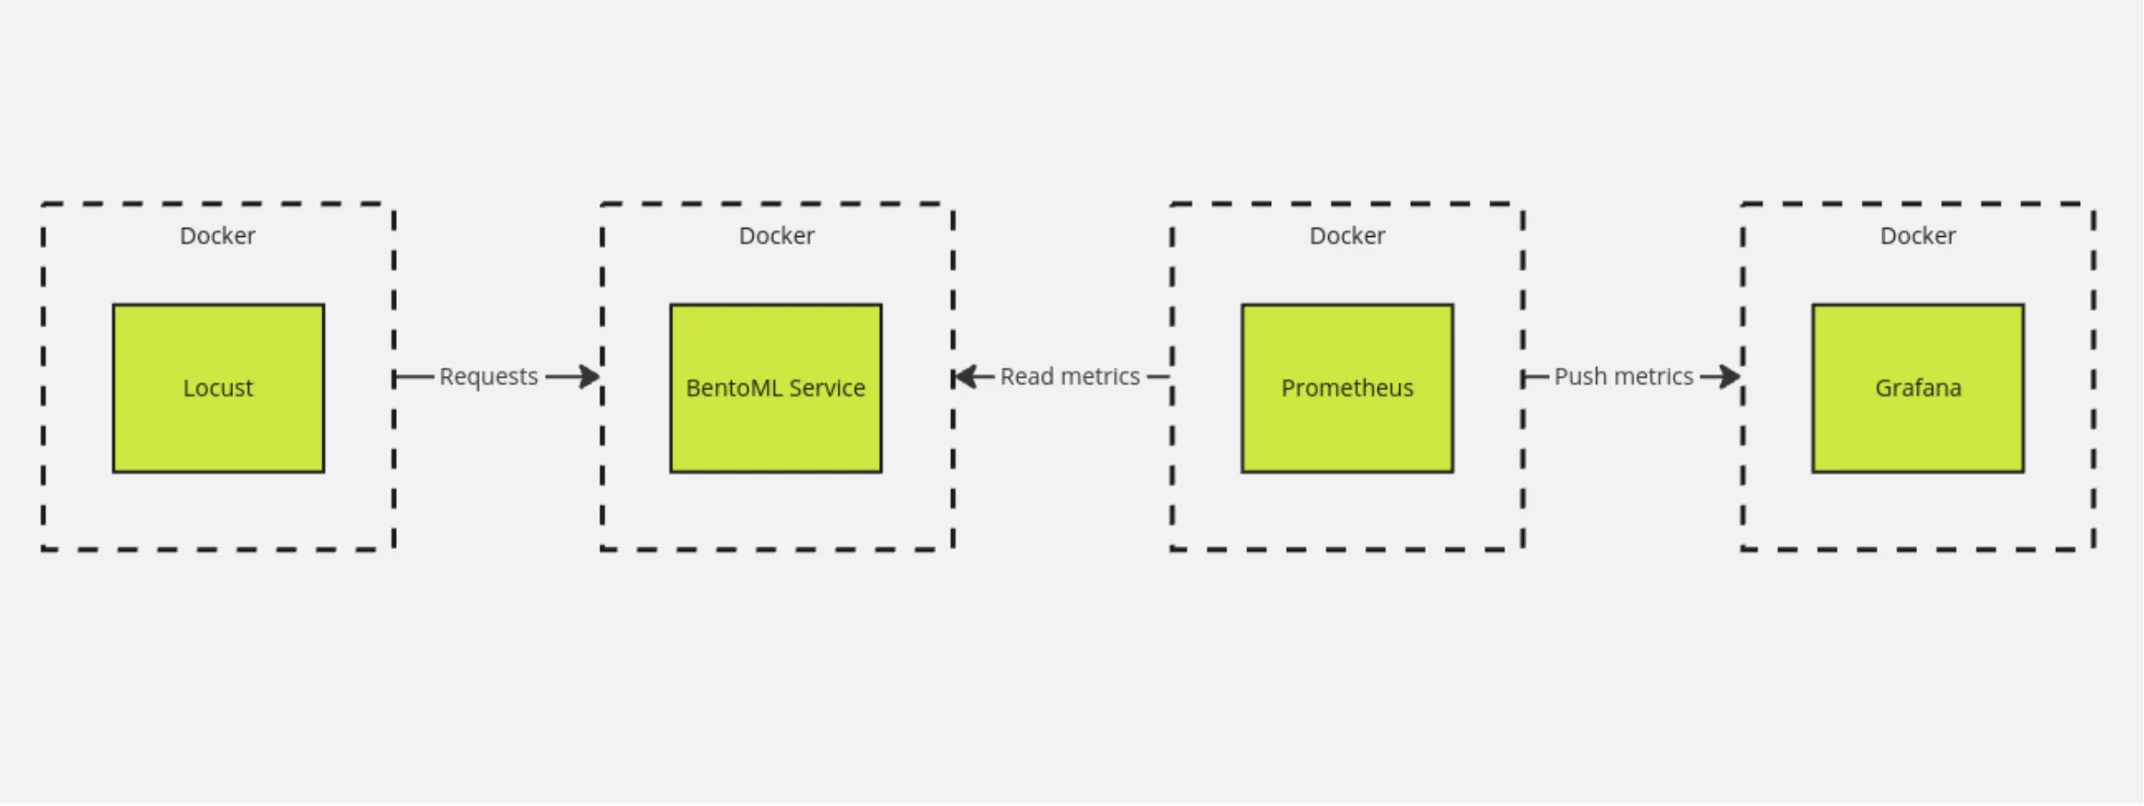
Քննարկվող սցենարի բաղադրիչների ճարտարապետությունը։
Ինչպե՞ս դա անել
Ենթադրում ենք, որ մեքենայական ուսուցման մոդելի ծառայությունը աշխատում է տեղային և բացահայտում է REST API։ Ահա օրինակ կոդ, որը BentoML registry-ից մոդել է աշխատեցնում 3000 պորտով՝
bentoml serve <MODEL_NAME:TAG> -p 3000Ստորև docker-compose.yaml ֆայլը սահմանում է մեկ locust ծառայություն՝ 8089 պորտը բացահայտող, որը շփվում է տեղային 3000 պորտով աշխատող ծառայության հետ։ Ծառայության կատարած հրամանը հենվում է Python սկրիպտի վրա, որը նկարագրում է, թե ինչպես պետք է թեստավորվի հավելվածը։ Հրամանը սահմանում է, թե քանի օգտատեր մոդելավորել, ինչպես պետք է նրանց թիվը աճի ժամանակի ընթացքում, որքան ժամանակ պետք է տևի մոդելավորումը և որտեղ պահել հաշվետվությունը և մոդելավորման արդյունքները պարունակող ֆայլը։
version: '3'

services:
 locust:
   image: locustio/locust
   ports:
     - "8089:8089"
   volumes:
     - ./:/mnt/locust
   command: -f /mnt/locust/locustfile.py
   --host=http://host.docker.internal:3000 --headless --users 1000
   --spawn-rate 5 --run-time 5m --html /mnt/locust/results.html
   --csv /mnt/locust/results -t 5m
   extra_hosts:
     - "host.docker.internal:host-gateway"
Ահա, թե ինչ են նշանակում locust հրամանին փոխանցվող ընտրանքները (փաստաթղթերի հիման վրա)՝
–host– ML ծառայության աշխատելու հասցեն–headless– աշխատել առանց գրաֆիկական ռեժիմի–users– մոդելավորվող տրաֆիկում օգտատերերի առավելագույն թիվը–spawn-rate– յուրաքանչյուր տվյալ ժամանակահատվածում ընթացիկ օգտատերերի խմբին քանի օգտատեր է ավելացվում–run-time– մոդելավորման ընդհանուր տևողությունը–html– ուղին, որտեղ կպահվի HTML հաշվետվությունը--csv– ուղին, որտեղ կպահվեն CSV արդյունքները
extra_hosts բաժինը, locust հրամանի հատուկ հասցեի հետ միասին, անհրաժեշտ է, որպեսզի կոնտեյներացված գործիքը կարողանա ճիշտ հասնել հոսթ մեքենայի վրա տեղային աշխատող ծառայությանը (ինչպես նկարագրված է այս թեմայում)։ Եթե ML մոդելը հասանելի է որպես Docker կոնտեյներ, թեստերի համար անհրաժեշտ յուրաքանչյուր ծառայություն կարելի է դնել docker-compose ֆայլում։
locustfile.py ֆայլը պարունակում է թեստավորվող մեկ endpoint-ի օրինակ՝ մեքենայական ուսուցման մոդելի նմուշային payload-ի հետ միասին։
from locust import HttpUser, between, task

EXAMPLE_DATA = {
   "data": ["This is an example sentence to classify."]
}

class QuickstartUser(HttpUser):
   """Load test user class."""

   wait_time = between(1, 5) # defines interval between user requests

   @task
   def classify(self):
       """Trigger `classify` endpoint."""
       self.client.post("/classify", json=EXAMPLE_DATA)
Եթե docker-compose.yaml-ը և locustfile.py-ը նույն դիրեկտորիայում են, կոնտեյները գործարկելու համար պարզապես աշխատեցրեք docker compose up։ Locust-ը կատարում է մոդելավորումը, և ավարտելուց հետո .csv ձևաչափով արդյունքները և HTML հաշվետվությունը գրվում են ընթացիկ դիրեկտորիայում։
Հաշվետվություններ
Բեռնվածքային թեստը աշխատեցնելը ստեղծում է HTML հաշվետվություն, որը պարունակում է ծառայության բեռի ինտերակտիվ վիզուալիզացիա, ինչպես նաև արդյունքները .csv ձևաչափով։
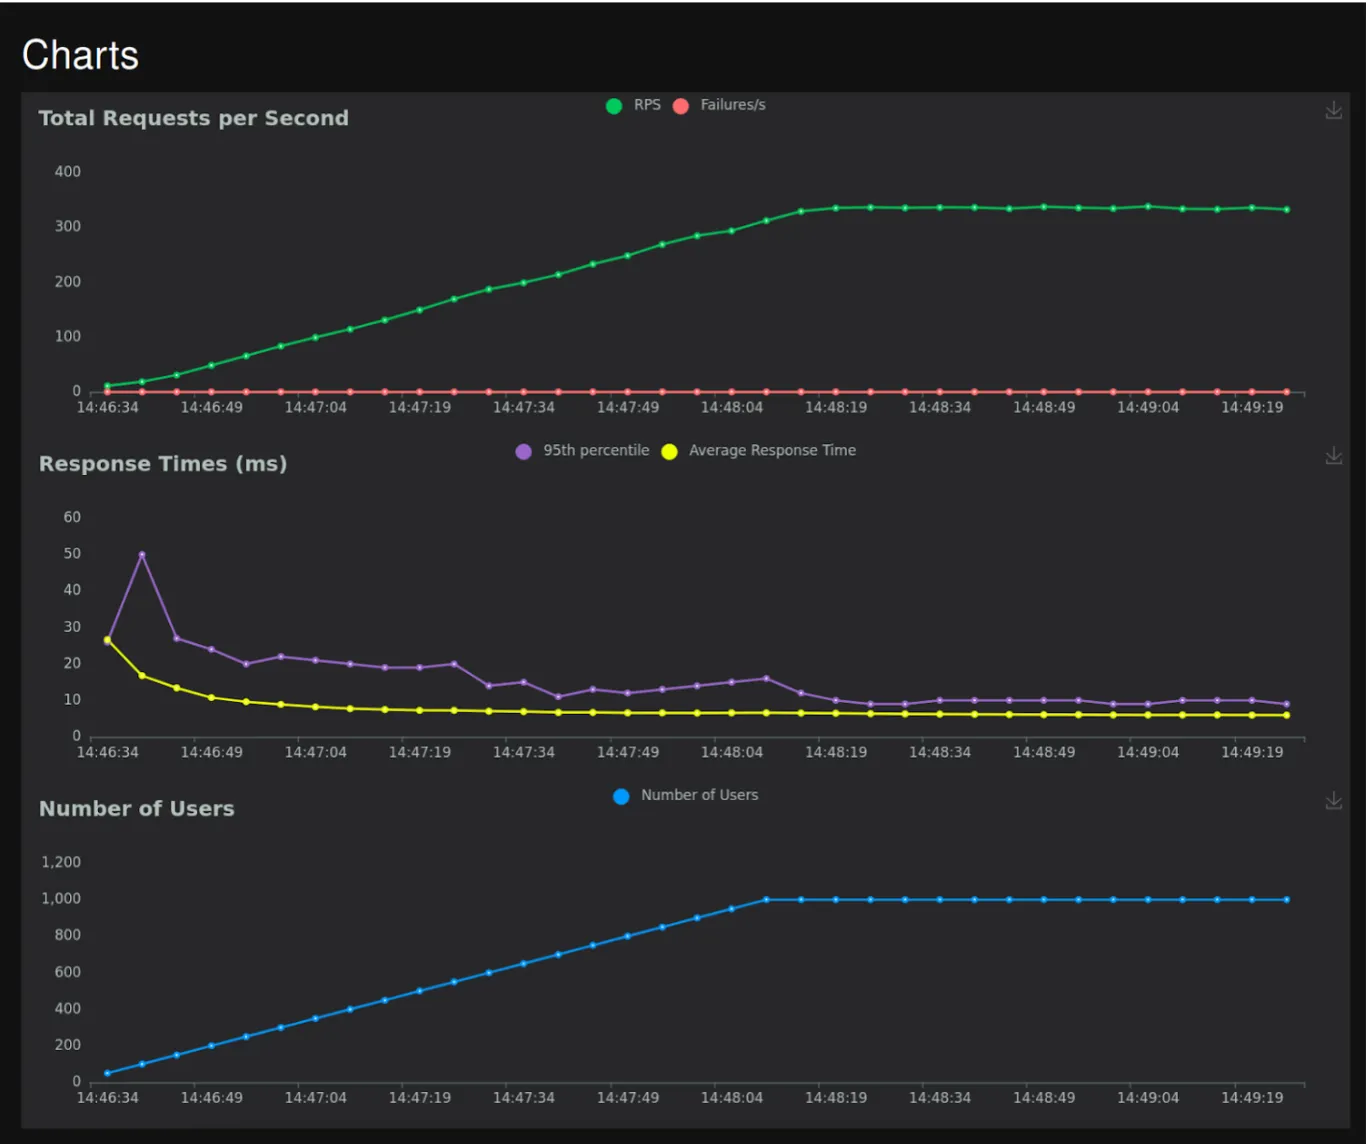
Օգտատերերի քանակի, արձագանքման ժամանակի և վայրկյանում հարցումների քանակի գրաֆիկները տրաֆիկի մոդելավորման ընթացքում։
Ամփոփ վիճակագրությունը՝ locustfile.py-ում սահմանված յուրաքանչյուր endpoint-ի արձագանքման ժամանակներով, ընդգրկում է մոդելի արձագանքման ժամանակի բաշխման 50-րդ, 60-րդ, 70-րդ, 80-րդ, 90-րդ, 95-րդ, 99-րդ և 100-րդ պերցենտիլները։ Ամենից հաճախ հաշվետվության մեջ նշվող և օգտագործվող արժեքները 95-րդ և 99-րդ պերցենտիլի արձագանքման ժամանակներն են, որոնք կարելի է կարդալ որպես արձագանքման ամենաերկար ժամանակ, որ կարելի է սպասել մոդելից դեպքերի 95 կամ 99 տոկոսում։
Համակարգի մետրիկների մոնիտորինգ
Locust-ով կարող ենք դիտարկել, վերլուծել և հաշվետվություն ներկայացնել միայն արձագանքման ժամանակի և մոդելավորված հարցումների մշակման վիճակագրության վերաբերյալ։ Իրական աշխարհի մեքենայական ուսուցման մոդելները սպառում են շատ ավելի շատ ռեսուրսներ, ներառյալ GPU-ները, և հենց դրանք ենք ուզում մոնիտորինգի և պրոֆիլավորման ենթարկել։
Դրա համար կարող ենք հենվել Prometheus-ի և Grafana-ի վրա՝ մեր տեղակայված ML մոդելի ծառայության արձակած լոգերը հավաքելու և վիզուալիզացնելու համար։
Այս պահին, եթե մոդելը տեղակայված է լռելյայն մետրիկների endpoint-ով (/metrics), հասանելի են դառնում համակարգի ռեսուրսների օգտագործման լրացուցիչ լոգեր։ Դրանք վիզուալիզացնելու համար պետք է աշխատեցնենք Grafana, Prometheus և մի քանի այլ անհրաժեշտ ծառայություններ։ Դրա համար կվերօգտագործեմ առկա բաց կոդով docker-compose stack։
Ստորև կգտնեք ճշգրտված docker-compose.yaml ֆայլը, որը Grafana-ից և Prometheus-ից բացի գործարկում է նաև Locust կոնտեյները և ավտոմատ սկսում է բեռնվածքային թեստավորումը։
version: '3.8'

volumes:
 prometheus_data: {}
 grafana_data: {}

services:
 locust:
   image: locustio/locust
   ports:
     - "8089:8089"
   volumes:
     - ./:/mnt/locust
   command: -f /mnt/locust/locustfile.py --host=http://host.docker.internal:8000
   --headless --users 100 --spawn-rate 5 --run-time 5m
   --html /mnt/locust/results.html --csv /mnt/locust/results -t 5m
   extra_hosts:
     - "host.docker.internal:host-gateway"
 prometheus:
   image: prom/prometheus
   restart: always
   volumes:
     - ./prometheus:/etc/prometheus/
     - prometheus_data:/prometheus
   command:
     - '--config.file=/etc/prometheus/prometheus.yml'
     - '--storage.tsdb.path=/prometheus'
     - '--web.console.libraries=/usr/share/prometheus/console_libraries'
     - '--web.console.templates=/usr/share/prometheus/consoles'
   ports:
     - 9090:9090
   extra_hosts:
     - "host.docker.internal:host-gateway"

 grafana:
   image: grafana/grafana
   user: '472'
   restart: always
   environment:
     GF_INSTALL_PLUGINS: 'grafana-clock-panel,grafana-simple-json-datasource'
   volumes:
     - grafana_data:/var/lib/grafana
     - ./grafana/provisioning/:/etc/grafana/provisioning/
   env_file:
     - ./grafana/config.monitoring
   ports:
     - 3000:3000
   depends_on:
     - prometheus
Ասենք՝ մոդելը տեղային աշխատում է 8000 պորտով BentoML-ով, գործարկված հետևյալ հրամանով՝
bentoml serve handler.svc -p 8000։
docker compose up աշխատեցնելը docker-compose.yaml ֆայլը պարունակող դիրեկտորիայում գործարկում է բոլոր կոնտեյներները և սկսում բեռնվածքային թեստավորումը։ Երբ Grafana-ն բացվում է դիտարկիչում, հասանելի են դառնում Prometheus-ի տրամադրած համակարգի մետրիկները։ Համապատասխան dashboard-ով կարող ենք հետևել ռեսուրսների օգտագործմանը բեռնվածքային թեստավորման և մոդելավորված ցանցային տրաֆիկի ընթացքում։
Դա իսկապես այդքան հեշտ է։ Հավելվածի արտադրողականության մոնիտորինգի կոնտեյներների այս հավաքածուն ընդհանուր է և վերօգտագործելի։ Երբ փոխարինում եք մոդելը և թարմացնում BentoML handler-ը, չափման կարգավորման մեջ միակ անհրաժեշտ ճշգրտումը endpoint-ի անվան և նմուշային տվյալների փոփոխումն է locustfile.py-ում։
Արդյունքներ
Մեր հավաքած docker-compose.yaml-ը HTTP-ով սպասարկվող ցանկացած մոդելի համար ընդհանուր չափման կարգավորում է (BentoML-ը պարտադիր չէ), որը մոդելավորում է ML ծառայությունը կանչող օգտատերերի ցանցային տրաֆիկը։ Համակարգի մետրիկների ագրեգացիայի ավելացումը լրացուցիչ թույլ է տալիս հետևել, թե ինչպես են ML մոդելները սպառում առանցքային ռեսուրսներ, ինչպիսիք են RAM-ը, VRAM-ը, CPU-ն և GPU-ն։ Մոդելավորվող ցանցային տրաֆիկի պարամետրերը ճշգրտելով՝ կարող եք անցկացնել ML ծառայությունների բեռնվածքային թեստեր, արտադրողականության թեստեր և սթրես թեստեր։
Ստորև էկրանի պատկերը ցուցադրում է գործիքը գործողության մեջ։ Մոդելավորման ողջ ընթացքում GPU-ի օգտագործումը մնում է կայուն մակարդակի վրա, և մասշտաբավորումը Out Of Memory սխալի վտանգ չի պարունակում։ Այս կերպ կարող ենք թեստավորել և հաստատել, որ մեր ծառայությունը կառուցված է այնպես, որ աճող տրաֆիկը այն չի կոտրի։
Համակարգի մետրիկները, վիզուալիզացված Grafana-ում։
Ամփոփում
Այս հոդվածը ցույց տվեց, թե ինչպես Locust գործիքը կարող է մոդելավորել այն բեռը, որին կբախվի մեքենայական ուսուցման մոդելի inference կատարող ծառայությունը։ Այն ներկայացրեց բաց endpoint-ները թեստավորելու պարզ կոդ, սպասվող արտեֆակտների տեսակները և դրանցից օգտվելու եղանակը։ Այն նաև ցուցադրեց, թե ինչպես վիզուալիզացնել այս մետրիկները Grafana-ում, ինչը հարմար է գալիս production-ի համար կամ արտադրողականության թեստավորման ընթացքում ML ծառայությունների մոնիտորինգ նախագծելիս։ Հուսով եմ՝ այս հոդվածը կօգնի ձեզ ավելի արդյունավետ նախագծել և վերլուծել մեքենայական ուսուցման մոդելներ ներառող ծառայություններն ու տեղակայումները։